Sagen Sie uns, wie wir helfen können
Vertrieb & Preise
Speak to a rep about your business needs

Hilfe & Support
See our product support options
Allgemeine Anfragen und Standorte
Kontakt

 Control-M + GCP Dataproc
Ihr GCP-Dataproc-Workflow startet, bevor ein Spark-Batch überhaupt ausgeführt wird – und er kann scheitern, wenn etwas stromaufwärts kaputtgeht. Ein Cloud-Speicher-Objekt kommt zu spät an. Ein BigQuery-Vorbereitungsauftrag verpasst sein erwartetes Abschlussfenster. Control-M orchestriert die gesamte Kette: Ankunft des Cloud-Speichers, BigQuery-Vorbereitung, Dataproc-Ausführung und nachgelagerte Lieferung – sodass Ihr Spark-Batch nur dann läuft, wenn die Daten, auf die es angewiesen ist, tatsächlich bereit sind.
Häufige Workflow-Probleme
Klingt das nach deiner Woche?
Das sind keine Randfälle. Sie sind die normalen Betriebsbedingungen für Teams, die GCP-Dataproc-Jobs über mehrere Tools ausführen. So geht Control-M mit jedem einzelnen um.
VERSPÄTETE DATENEINTREFFEN
Dein 2 Uhr morgens. Der Spark-Job beginnt. Das Cloud-Speicherobjekt ist verspätet.
Control-M macht die vorgelagerte Datenankunft zum Teil des Jobflusses, sodass die Dataproc-Verarbeitung auf die bestätigte Ankunft der erforderlichen Eingabe wartet, anstatt mit einem festen Zeitplan zu beginnen. Die abhängige Arbeitslast beginnt erst, wenn ihre Voraussetzung abgeschlossen ist, was eine unvollständige Datenverarbeitung verhindert.
FEHLGESCHLAGENER CHARGE
Dein serverloser Spark-Batch wurde storniert. Die Downstream-Verarbeitung wartet noch.
Control-M überwacht die Ausführung von Dataproc und erkennt einen abgebrochenen Batch als Fehlerzustand. Downstream-Abhängigkeiten bleiben blockiert, anstatt eine unvollständige Verarbeitung voranzutreiben, was Operatoren einen kontrollierten Wiederherstellungspfad bietet und verhindert, dass der Fehler durch die Pipeline kaskadieren.
STATUSUMFRAGE
Der Spark-Job läuft noch. Deine nächste Stufe kann nicht sicher starten.
Control-M fragt den Dataproc-Jobzustand in einem konfigurierbaren Verifikationsintervall ab und wendet eine definierte Toleranz an, bevor der Job Not OK beendet wird. Downstream-Arbeit folgt dem tatsächlichen Ausführungszustand und nicht einem geschätzten Abschlussfenster.
CROSS-TOOL-ABHÄNGIGKEIT
Dataproc wurde erfolgreich abgeschlossen. Die BigQuery-Übergabe muss noch koordiniert werden
Control-M platziert Dataproc- und BigQuery-Jobs in denselben End-to-End-Workflow, sodass die nachgelagerte Verarbeitung von einem erfolgreichen Upstream-Abschluss abhängen kann. Die Übergabe folgt dem Job-Status und nicht separaten Zeitplänen, wodurch Zeitunterschiede zwischen den Verarbeitungsphasen reduziert werden.
DOPPELTE AUSFÜHRUNG
Eine serverlose Batch-Anfrage wird erneut versucht. Du kannst kein Risiko einer doppelten Verarbeitung eingehen.
Für Dataproc Serverless für Spark-Batches unterstützt Control-M Batch-ID und Requested ID-Parameter, wobei die Requested ID die CreateBatch-Anfrage identifiziert. Dataproc ignoriert eine zweite Anfrage mit derselben ID und gibt stattdessen die Operation zurück, die mit dem ursprünglichen Batch verbunden ist.
Control-M + GCP Dataproc
Control-M + GCP Dataproc
|
workload.types |
Workflow-Vorlagen · einzelne Dataproc-Jobs · Dataproc Serverless für Spark-Batches · interaktive Sitzungen · Big-Data-Verarbeitung · Machine-Learning-Workloads |
|
trigger.type |
Dateiankunft · Upstream-Jobabschluss · Zeitplan · Control-M-Abhängigkeit · API-gesteuerte Ausführung · Anwendungsübergreifender Jobzustand |
|
cross_tool.deps |
GCP BigQuery-Job · GCP-Dataflow-Job · GCP Composer DAG · Cloud-Speicherdatei · Dateiübertragungsabschluss · REST-API-Aufruf |
|
cloud.platforms |
Google Cloud Platform · Dataproc · Dataproc Serverless für Spark · Control-M SaaS · Control-M Web · Automatisierungs-API · Hybride Unternehmensworkflows |
|
error_handling |
Verifikations-Abfrageintervall · konfigurierbare Toleranz · Erkennung von Ausfallchargen durch abgebrochene Chargen · Downstream-Kaskadenprävention · Abhängigkeitsbasierte Wiederherstellung · Angeforderte ID |
|
Durchsatz |
parallele Dataproc-Verarbeitung · serverlose Spark-Batches · großflächige Batch-Verarbeitung · Big-Data-Workloads |
|
Beobachtbarkeit |
Dataproc-Jobstatus · Ergebnisse und Ausgabe · Abhängigkeitsstatus · Workflow-Überwachung · Ausführungshistorie · End-to-End-Job-Sichtbarkeit |
End-to-End-Orchestrierung
Ein Produktionsworkflow. Jedes Tool im Stack.
Control-M orchestriert Workflows über GCP Dataproc, BigQuery, Dataflow, Cloud Composer, Cloud Storage, Dateiübertragungen und Cloud-Dienste in einem einzigen Job-Flow – mit Abhängigkeitsverfolgung, SLA-Transparenz und automatisierter Wiederherstellung über alle hinweg.
- Cross-Tool-Abhängigkeit: Cloud-Speicher → BigQuery → GCP Dataproc → Analytics-Übergabe
- Datenbewusste Trigger: Dateiankunft, API-Ereignis, Upstream-Job-Erfüllung, Dataproc-Abschluss
|
GCP Dataproc |
Workflow-Vorlagen · Dataproc-Jobs · Serverlos für Spark-Batches · Interaktive Sitzungen · Status-Abfrage |
|
GCP BigQuery |
Datenverarbeitung · Analytics-Jobs · Upstream-Vorbereitung · Downstream-Analysen |
|
GCP-Datenfluss |
Batchverarbeitung · Streaming-Pipelines · Abhängigkeiten zwischen Jobs · Workflow-Übergaben |
|
GCP-Komponist |
Airflow DAG-Ausführung · DAG-Wiederholung (Option, nur fehlgeschlagene Aufgaben erneut zu versuchen) · plattformübergreifende Abhängigkeit · Workflow-Koordination |
|
Cloud-Speicher |
Dateiankunft · Eingabe-Staging · Ausgabelieferung · Datengetriebene Abhängigkeiten |
|
Dateiübertragungen |
Dateibeobachtung · verwaltete Übertragung · Lieferbestätigung · Downstream-Verarbeitungs-Trigger |
|
REST-APIs |
Anwendungsaufrufe · Workflow-Übergaben · API-gesteuerte Automatisierung · plattformübergreifende Koordination |
Koexistenz des Luftstroms
Control-M ersetzt deine Airflow DAGs nicht. Es verläuft die darüberliegende Schicht.
Der Einwand ist häufig: "Wir sind bereits auf Airflow." Das Problem ist nicht, was Airflow macht – sondern was vor und nach Airflow passiert. Genau hier versagen Pipelines tatsächlich.
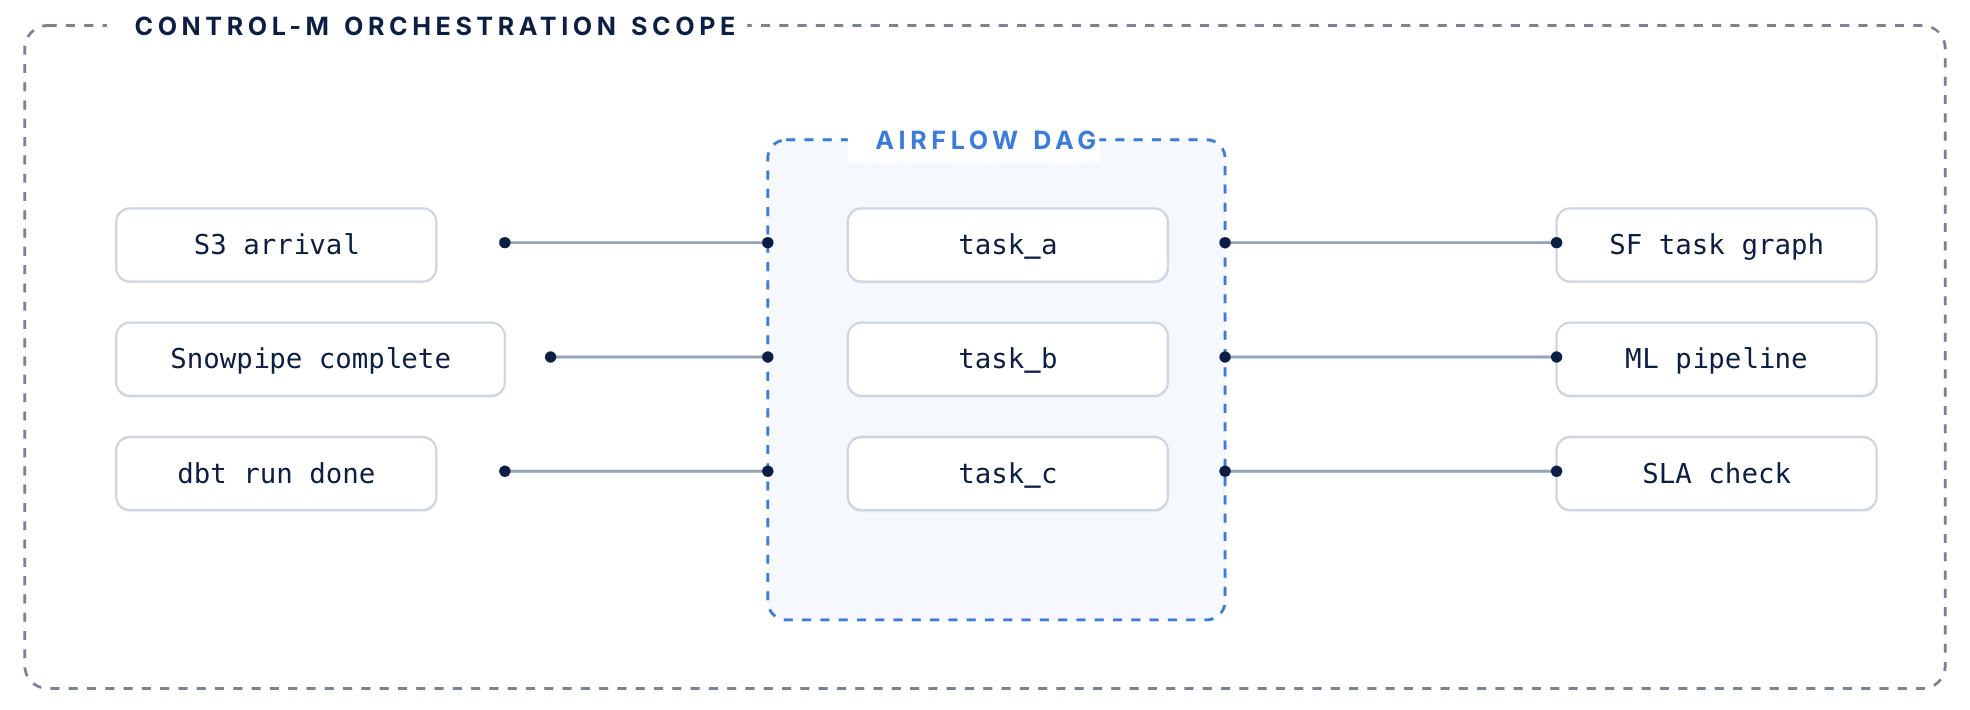
Der Luftstrom steuert seinen DAG. Control-M verwaltet alles Umliegende.
Luftstromregler
Orchestrierung auf DAG-Ebene innerhalb der Datenpipeline
- DAG-Level-Aufgabenorchestrierung innerhalb von Datenpipelines
- Python-Operatoren, Sensoren und Aufgabenabhängigkeiten
- Ausführungsgraph für Jobs, die in deiner Pipeline laufen
- Verwaltet erneute Versuche innerhalb eines einzigen DAG-Kontexts
Control-M fügt hinzu
Die Koordinationsschicht um deine DAGs herum
- Koordinationsschicht rund um DAGs – löst den Airflow basierend auf upstream-Bedingungen aus: Dateiankünfte, API-Ereignisse, andere Werkzeugabschlüsse
- Verfolgt den SLA-Beitrag jedes DAG über den gesamten End-to-End-Workflow, nicht nur über die eigene Routine
- Verwaltet die Fehlerwiederherstellung, wenn upstream-Abhängigkeiten ausfallen, bevor der Luftstrom überhaupt startet.
- Bestehende DAGs müssen nicht umgeschrieben oder migriert werden
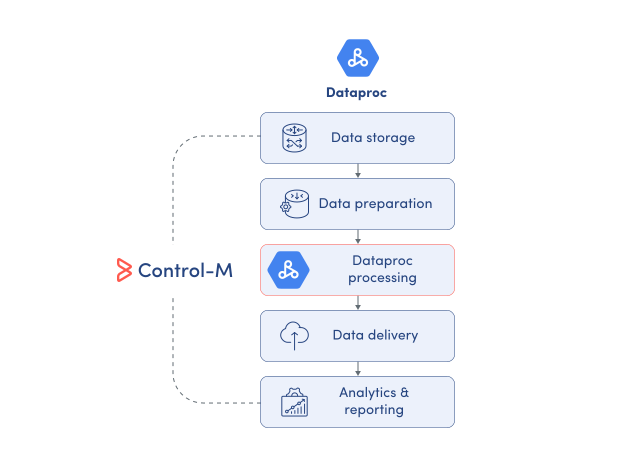
PIPELINES ÜBERWACHEN
Überwachen Sie die Ausführung von Dataproc in Ihrer gesamten Datenpipeline.
Dataproc berichtet die Ausführung innerhalb seines eigenen Dienstes, aber die Produktionspipelines erstrecken sich über Speicher, Vorbereitung, Verarbeitung und Lieferung. Control-M bringt diese verbundenen Jobs in eine operative Ansicht, sodass Teams die Ausführung im End-to-End-Kontext überwachen können:
-
Dataproc-Jobstatus
-
Ergebnisse und Arbeitsergebnisse
-
Upstream- und Downstream-Abhängigkeiten
-
Plattformübergreifende Ausführungssichtbarkeit
-
Zentralisierte Workflow-Überwachung
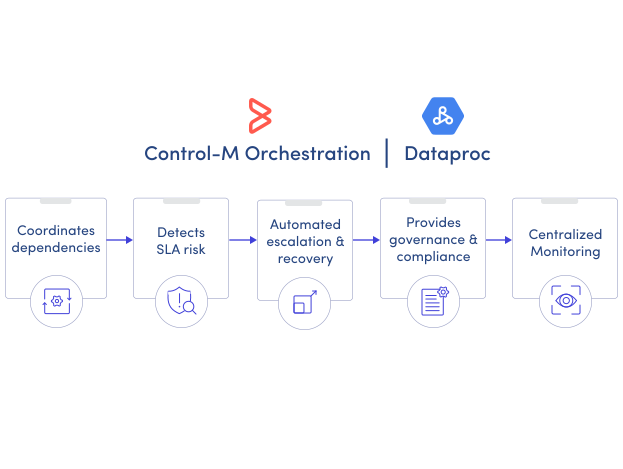
SLA-SICHERUNG
Halten Sie die Dataproc-Pipelines an die Lieferfristen ausgerichtet.
Ein erfolgreicher Dataproc-Auftrag garantiert nicht, dass der vollständige Datendienst rechtzeitig abgeschlossen ist. Control-M verfolgt den Verarbeitungsschritt im Rahmen seines umfassenderen Arbeitsablaufs, hilft Teams, Abhängigkeitsverzögerungen zu identifizieren und die Lieferung im Hinblick auf End-to-End-Service-Erwartungen zu steuern:
-
End-to-End-SLA-Sichtbarkeit
-
Upstream-Abhängigkeitsverfolgung
-
Überwachung der nachgelagerten Lieferung
-
Ausnahmegesteuerte operative Reaktion
-
Plattformübergreifender Workflow-Status
Dokumentation
Bring Ordnung in komplexe Arbeitsabläufe
Erfahren Sie, wie Control-M Teams hilft, komplexe Prozesse mit größerer Transparenz, Koordination und Kontrolle zu orchestrieren.
