Sagen Sie uns, wie wir helfen können
Vertrieb & Preise
Speak to a rep about your business needs

Hilfe & Support
See our product support options
Allgemeine Anfragen und Standorte
Kontakt

 Control-M + Hadoop HDFS
Ihr Hadoop-HDFS-Workflow startet, bevor ein HDFS-Befehl oder Dateibeobachter überhaupt ausgeführt wird – und er kann scheitern, wenn etwas stromaufwärts defekt ist. Ein Sqoop-Import schreibt nie den erwarteten HDFS-Datensatz. Eine Hive-Transformation ist zu spät abgeschlossen und verpasst das Downstream-Verarbeitungsfenster. Control-M orchestriert die gesamte Kette: Einkunft der Quelldaten, Hive-Transformation, HDFS-Ausführung und Downstream-Lieferung.
Häufige Workflow-Probleme
Klingt das nach deiner Woche?
AKTENANKUNFT
Die HDFS-Akte kam um 2:00 Uhr morgens an. Sie ist immer noch unvollständig.
Control-M HDFS File Watcher wartet auf den angegebenen HDFS-Pfad, bis die Datei die definierte Mindestgröße erreicht hat. Wenn die Datei eintrifft, aber das Größenkriterium nicht erfüllt ist, beobachtet der Job weiter und verhindert, dass Teildaten in die nächste Pipeline-Stufe gelangen.
HDFS-BEFEHLSFEHLER
Dein HDFS fällt aus. Die Downstream-Verarbeitung ist bereits für den Start geplant.
Control-M führt HDFS-Befehle als verwaltete Jobs aus und erfasst deren Abschlusszustand. Abhängigkeiten verhindern, dass nachgelagerte Jobs nach einem fehlgeschlagenen Befehl fortgesetzt werden, wodurch ein HDFS-Zugriffs- oder Übertragungsproblem nicht durch den Rest des Workflows kaskadieren.
KREUZ-CLUSTER-KOPIE
Der gestrige Transfer von DistCp zog sich hin. Das heutige Analysefenster schließt sich.
Control-M plant DistCp als Teil desselben Produktionsworkflows, verfolgt dessen Fertigstellung vor Beginn der abhängigen Verarbeitung und wendet Control-M-Planung sowie SLA-Kontrollen rund um den Auftrag an – was die manuelle Koordination reduziert, wenn große Inter-Cluster-Kopien lang dauern.
HIVE · HDFS
Dein Hive-Job erledigt. Der HDFS-Lieferschritt hat nie begonnen.
Control-M modelliert Hive-Verarbeitung und HDFS-Operationen innerhalb einer Abhängigkeitskette. Wenn der Hive-Job seinen erforderlichen Abschlusszustand erreicht, kann Control-M den abhängigen HDFS-Schritt ohne separaten Cron-Termin oder manuelle Übergabe freigeben.
SLA-RISIKO
Die HDFS-Bearbeitung verzögert sich. Die Geschäftsfrist hat sich nicht verschoben.
Control-M bringt Hadoop-Jobs in seine Enterprise-Scheduling-Umgebung und ermöglicht SLA-Jobs um sie herum. Teams können die HDFS-Phase im Kontext des End-to-End-Workflows verwalten, anstatt eine isolierte Dateisystemaufgabe zu beheben.
INTEGRATIONSFAKTEN
Control-M + Hadoop HDFS
|
workload.types |
HDFS-Befehle · HDFS-Dateibeobachter · DistCp · Spark Vor-/Nach-HDFS-Befehle · MapReduce Vor-/Nach-HDFS-Befehle |
|
trigger.type |
HDFS-Dateiankunft (mit Mindestdateigröße und maximaler Wartezeit) · Zeitplan · Abschluss des Auftrags im Upstream. |
|
cross_tool.deps |
Hive-Job · Spark-Job · Sqoop-Job · MapReduce-Job · Oozie-Workflow · DistCp-Transfer · Downstream-Analysen |
|
cloud.platforms |
On-premises Hadoop · Cloudera / Hortonworks-Distributionen · Linux-Edge-Node · Kerberos-gesichertes Hadoop |
|
error_handling |
Vorbefehlsfehlerbehandlung (FailJobOnCommandFailure) · Nachbefehlsfehlerbehandlung · Abhängigkeitsgating · SLA-Überwachung · Ressourcenkontrollen |
|
Durchsatz |
verteilter HDFS-Speicher · große Datensätze · parallele DistCP-Übertragungen · Hadoop-Batchverarbeitung · Cluster-Scale-Workloads |
|
Beobachtbarkeit |
Control-M-Jobüberwachung · Jobabschlussstatus · End-to-End-Abhängigkeitssichtbarkeit · SLA-Tracking · Zentralisierte Planungsansicht |
End-to-End-Orchestrierung
Ein Produktionsworkflow. Jedes Tool im Stack.
Control-M orchestriert Workflows über Hadoop HDFS, Hive, Spark, Sqoop, Oozie und Dateiübertragungen in einem einzigen Job-Flow – mit Abhängigkeitsverfolgung, SLA-Transparenz und automatisierter Wiederherstellung in allen Bereichen.
- Cross-Tool-Abhängigkeit: Sqoop → HDFS → Hive → Spark
- Datenbewusste Auslöser: Ankunft der HDFS-Datei, Mindestdateigröße, Auftragsabschluss, Zeitplan
|
Hadoop HDFS |
HDFS-Befehle · Dateiankunft beobachten · Mindestgrößenkriterien · verwaltete Abhängigkeiten |
|
DistCp |
Verteilte Kopie · Quellpfade · Zielpfad · DistCp-Optionen |
|
Bienenstock |
Hive-Skriptausführung · Abhängigkeitskoordination · Vor-/Nach-HDFS-Operationen |
|
Spark |
Verteilte Kopie (Inter-/Intra-Cluster) · Quellpfade · Zielpfad · DistCp-Optionen. |
|
Sqoop |
Datenbewegungsjobs · Workflow-Abhängigkeiten · geplante Ausführung |
|
Oozie |
Workflow-Ausführung · Workflow-Extraktion · Aktionssichtbarkeit |
|
MapReduce |
MapReduce-Jobs · Streaming-Jobs · HDFS Pre/Post-Befehle |
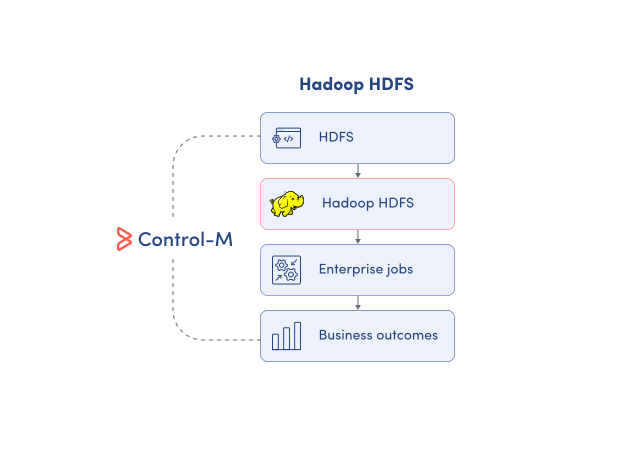
PIPELINES ÜBERWACHEN
Überwachen Sie die HDFS-Ausführung über die gesamte Datenpipeline hinweg.
HDFS zeigt, was im Dateisystem passiert, aber nicht, ob der gesamte Geschäftsablauf voranschreitet. Control-M legt HDFS-Operationen neben Hadoop-Verarbeitung und abhängigen Unternehmensjobs in einer operativen Ansicht:
-
HDFS-Jobausführungsstatus
-
Upstream- und Downstream-Abhängigkeiten
-
Cross-Tool-Workflow-Sichtbarkeit
-
Zentralisierte Jobüberwachung
SLA-SICHERUNG
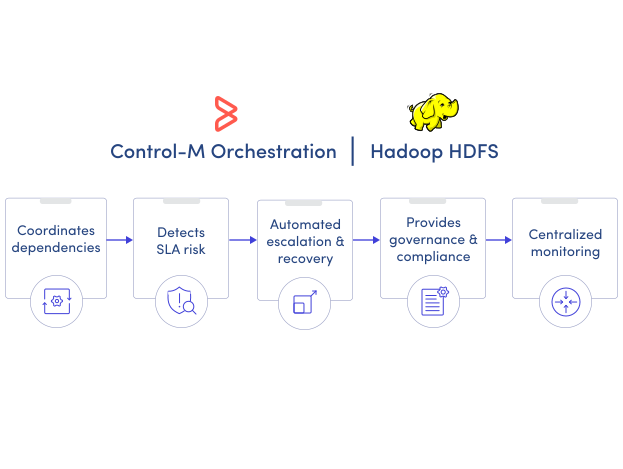
Halten Sie HDFS-abhängige Pipelines auf Geschäftsfristen ausgerichtet
Ein erfolgreicher HDFS-Betrieb kann für den Prozess, der davon abhängt, immer noch zu spät sein. Control-M wendet Unternehmensplanung, Abhängigkeiten, Ressourcenkontrollen und SLA-Management rund um Hadoop-Workloads an, sodass Teams die Lieferung im Geschäftskontext steuern können:
-
End-to-End-SLA-Tracking
-
Fortgeschrittene Terminvereinbarungskriterien
-
Komplexes Abhängigkeitsmanagement
-
Koordination des Ressourcenpools
-
Sperren Sie Ressourcenkontrollen
