Sagen Sie uns, wie wir helfen können
Vertrieb & Preise
Speak to a rep about your business needs

Hilfe & Support
See our product support options
Allgemeine Anfragen und Standorte
Kontakt

 Control-M + Hadoop MapReduce
Ihr Hadoop-MapReduce-Workflow startet, bevor das Programm-JAR überhaupt ausgeführt wird – und es kann scheitern, wenn etwas im Vorstrom kaputtgeht. Eine HDFS-Eingabedatei, die unvollständig ankommt. Ein Sqoop-Import, der spät abgeschlossen wird. Control-M orchestriert die gesamte Kette: HDFS-Datenankunft, Sqoop-Aufnahme, MapReduce-Ausführung und nachgelagerte Hive-Verarbeitung.
Häufige Workflow-Probleme
Klingt das nach deiner Woche?
EINGABEBEREITSCHAFT
Dein MapReduce-Job um 2 Uhr morgens gestartet. Der HDFS-Eingang ist nie angekommen.
Control-M HDFS File Watcher wartet auf die erforderliche Datei und die minimale Dateigröße, bevor er erfolgreich abgeschlossen wird. Der MapReduce-Job kann weiterhin von diesem Ereignis abhängig bleiben, um eine vorzeitige Ausführung bei fehlenden oder unvollständigen Eingabedaten zu verhindern.
FEHLERWIEDERHERSTELLUNG
Der MapReduce-Job ist fehlgeschlagen. Deine nachgeschaltete Hive-Verarbeitung wartet immer noch.
Control-M platziert MapReduce- und nachgeschaltete Hadoop-Jobs in derselben Abhängigkeitskette. Fehlgeschlagene Verarbeitung verhindert, dass abhängige Jobs freigegeben werden, bis definierte Wiederherstellungsbedingungen erfüllt sind, wodurch der Fehler eingedämmt wird, anstatt schlechte Daten stromabwärts weiterzugeben.
PIPELINE-TIMING
Sqoop war früh fertig. MapReduce wartet immer noch auf seine geplante Startzeit.
Control-M koordiniert Sqoop und MapReduce über Workflow-Abhängigkeiten statt über isolierte Zeitpläne. Wenn der Upstream-Job seine Abschlussbedingungen erfüllt, kann die Verarbeitung in die MapReduce-Phase übergehen, ohne auf ein separates festes Zeitfenster zu warten.
HDFS-VORBEREITUNG
Die HDFS-Ausgabe von gestern bleibt bestehen. Der heutige MapReduce-Lauf kann nicht sicher starten.
Control-M unterstützt HDFS-Vor- und Nachbefehle rund um die Ausführung von MapReduce zur Vorbereitung und Bereinigung. Konfigurierbare Befehlsfehlerbehandlung bestimmt, ob ein fehlgeschlagener Befehl den Auftrag stoppt, was den Teams explizite Kontrolle über unsichere Ausführungsbedingungen gibt.
SLA-RISIKO
MapReduce ist kurz dahin. Ihre Morgen-Analytics-Lieferung ist jetzt gefährdet.
Control-M kann einen SLA-Job an Hadoop-Workloads anhängen und MapReduce innerhalb der größeren Abhängigkeitskette verwalten. Datenteams können zeitplanabhängige Verarbeitung als Teil des End-to-End-Workflows verfolgen, anstatt einen isolierten Cluster-Job zu überwachen.
Control-M + Hadoop MapReduce
Control-M + Hadoop MapReduce
|
workload.types |
Java MapReduce · MapReduce Streaming · HDFS-Befehle · HDFS-Dateibeobachter · Hive · Pig · Sqoop · Spark · DistCp · Oozie · Impala · Verteilte Shell · Tajo |
|
trigger.type |
HDFS-Dateiankunft · minimale Dateigröße · Zeitplan · Abschluss eines vorgelagerten Auftrags · Control-M-Abhängigkeitsbedingung |
|
cross_tool.deps |
HDFS-Dateibeobachter · Sqoop · Hive · Pig · Spark · Oozie · DistCp · Impala · Verteilte Shell · Tajo · Enterprise Control-M-Jobs |
|
cloud.platforms |
Selbstverwaltete Hadoop-Cluster · Linux-Ausführungshosts · On-Premises-Umgebungen · Hybride Unternehmens-Workflows (für Managed Cloud Hadoop, siehe Azure HDInsight und AWS EMR-Integrationen) |
|
error_handling |
Vorbefehlsfehlerbehandlung · Nachbefehlsfehlerbehandlung · Abhängigkeitskontrolle · HDFS-Dateibeobachter-Zeitabbruch · SLA-Jobüberwachung |
|
Durchsatz |
Verteilte Big-Data-Verarbeitung · clusterbasierte Ausführung · paralleles MapReduce Workloads · Hochvolumen-Batch-Verarbeitung |
|
Beobachtbarkeit |
zentralisierte Hadoop-Jobüberwachung · Sichtbarkeit von Workflow-Abhängigkeiten · SLA-Job-Tracking · Control-M-Überwachungsdomäne |
End-to-End-Orchestrierung
Ein Produktionsworkflow. Jedes Tool im Stack.
Control-M orchestriert Workflows über Hadoop MapReduce, HDFS, Sqoop, Hive, Spark, Oozie und Dateiübertragungen in einem einzigen Job-Flow – mit Abhängigkeitsverfolgung, SLA-Transparenz und automatisierter Wiederherstellung in allen Bereichen.
- Cross-Tool-Abhängigkeit: HDFS-Datei → Sqoop → Hadoop MapReduce → Hive → Analytics-Übergabe
- Datenbewusste Auslöser: HDFS-Dateiankunft, Upstream-Fertigstellung, Dateigrößenkriterien, Verarbeitungsergebnis
|
Hadoop MapReduce |
Programm-JAR-Ausführung · Hauptklasse und Argumente · HDFS Pre/Post-Befehle · Abhängigkeitsorchestrierung |
|
HDFS |
Dateiankunftserkennung · Mindestgrößenkriterien · HDFS-Befehle · Vorbereitung und Bereinigung |
|
Sqoop |
Import-/Exportjobs · Jobargumente · HDFS-Integration · Abhängigkeitskoordination |
|
Bienenstock |
Hive-Job-Ausführung · Skripte und Parameter · Upstream/Downstream-Abhängigkeiten |
|
Spark |
Python-Jobs · Scala/Java-Jobs · Spark-Optionen · Abhängigkeitskoordination |
|
Oozie |
Workflow-Einreichung · Auftragseigenschaften · Workflow-Extraktion · Abhängigkeitskoordination |
|
DistCp |
Verteilte Kopie · Quell-/Zielpfade · Übertragungsoptionen · Workflow-Abhängigkeiten |
Koexistenz des Luftstroms
Control-M ersetzt deine Airflow DAGs nicht. Es verläuft die darüberliegende Schicht.
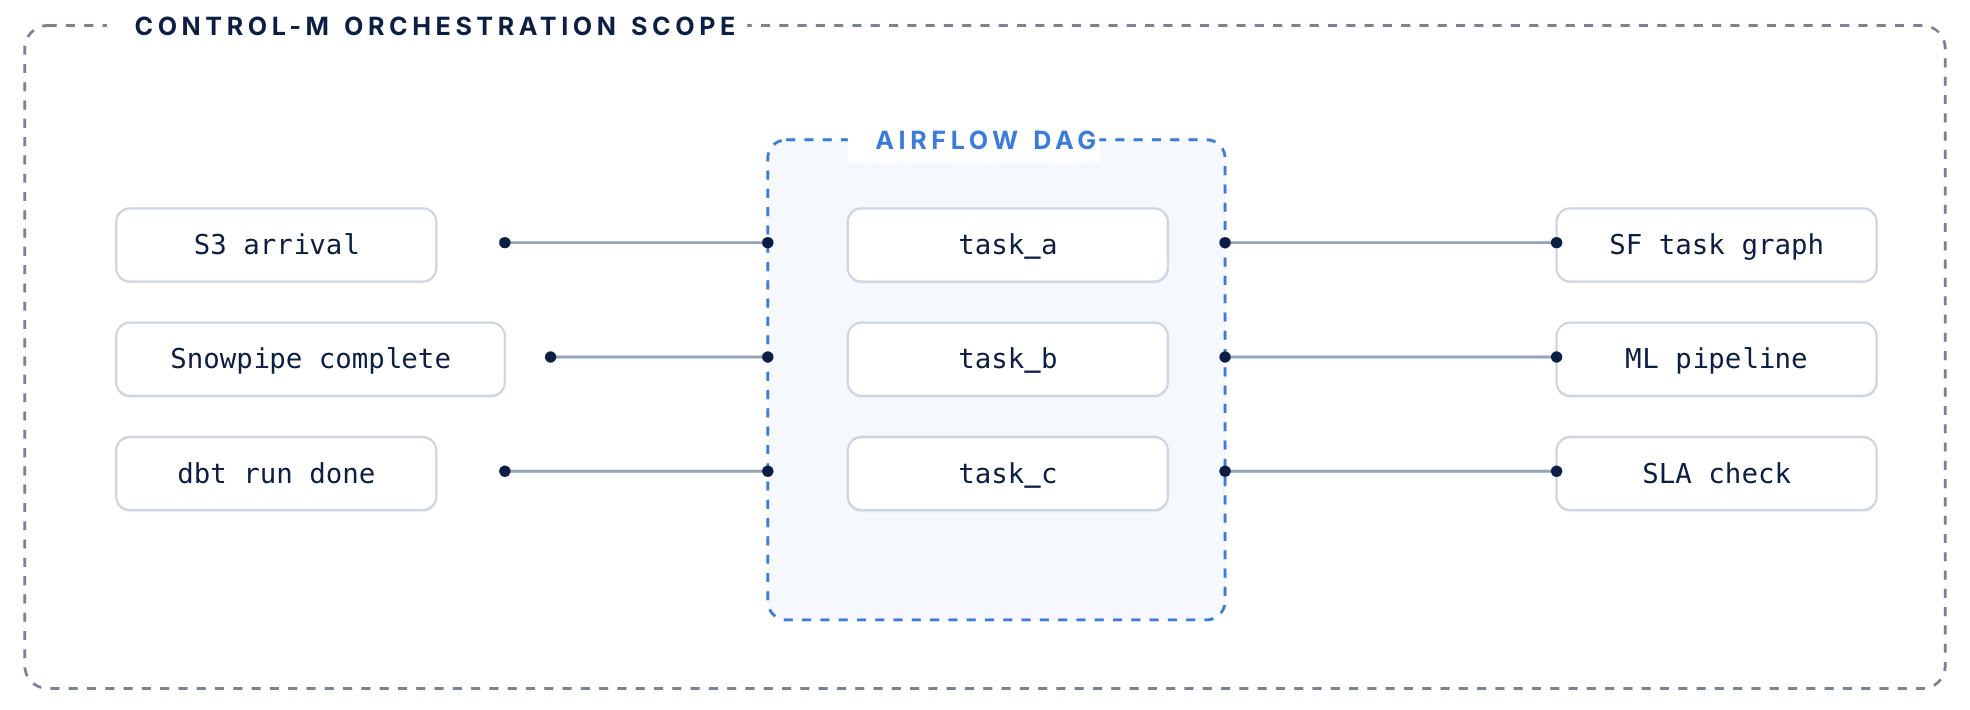
Der Luftstrom steuert seinen DAG. Control-M verwaltet alles Umliegende.
Luftstromregler
Orchestrierung auf DAG-Ebene innerhalb der Datenpipeline
- DAG-Level-Aufgabenorchestrierung innerhalb von Datenpipelines
- Python-Operatoren, Sensoren und Aufgabenabhängigkeiten
- Ausführungsgraph für Jobs, die in deiner Pipeline laufen
- Verwaltet erneute Versuche innerhalb eines einzigen DAG-Kontexts
Control-M fügt hinzu
Die Koordinationsschicht um deine DAGs herum
- Koordinationsschicht rund um DAGs – löst den Airflow basierend auf upstream-Bedingungen aus: Dateiankünfte, API-Ereignisse, andere Werkzeugabschlüsse
- Verfolgt den SLA-Beitrag jedes DAG über den gesamten End-to-End-Workflow, nicht nur über die eigene Routine
- Verwaltet die Fehlerwiederherstellung, wenn upstream-Abhängigkeiten ausfallen, bevor der Luftstrom überhaupt startet.
- Bestehende DAGs müssen nicht umgeschrieben oder migriert werden
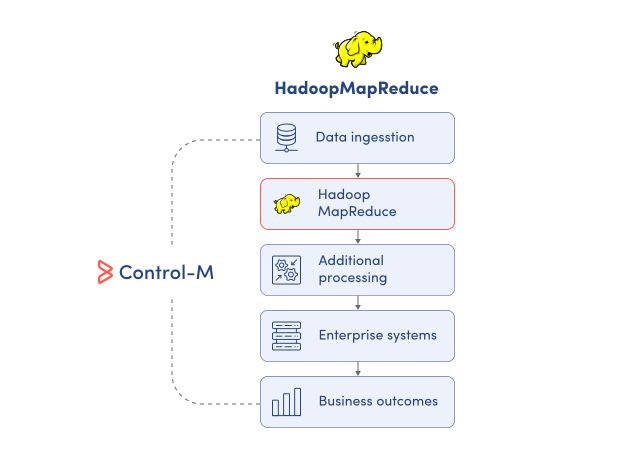
PIPELINES ÜBERWACHEN
Überwachen Sie Hadoop MapReduce Jobs über die gesamte Datenpipeline hinweg
Hadoop stellt die Ausführung innerhalb des Clusters frei, aber die Produktionspipelines gehen über einen einzelnen MapReduce-Job hinaus. Control-M zentralisiert MapReduce und umliegende Arbeitslasten, sodass Datenteams die Verarbeitung im Kontext des gesamten Workflows überwachen können:
-
MapReduce-Ausführungsstatus
-
Upstream- und Downstream-Abhängigkeiten
-
Plattformübergreifende Workflow-Sichtbarkeit
-
Hadoop-Jobüberwachung
-
End-to-End-Verarbeitungsstatus
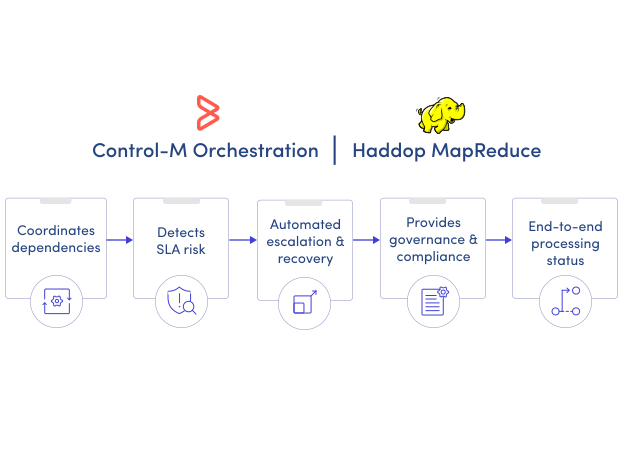
SLA-SICHERUNG
Halte die MapReduce-Verarbeitung mit den Liefer-SLAs im Einklang
Ein erfolgreicher MapReduce-Auftrag garantiert nicht, dass der vollständige Datendienst rechtzeitig abgeschlossen wird. Control-M verbindet die Hadoop-Verarbeitung mit Unternehmensplanung, Abhängigkeiten und SLA-Management, sodass Teams zeitkritische Auslieferungen über die gesamte Pipeline hinweg steuern können:
-
Hadoop-SLA-Jobverfolgung
-
Fortgeschrittene Terminvereinbarungskriterien
-
Komplexes Abhängigkeitsmanagement
-
Ressourcenpool-Kontrollen
-
End-to-End-SLA-Sichtbarkeit
