Sagen Sie uns, wie wir helfen können
Vertrieb & Preise
Speak to a rep about your business needs

Hilfe & Support
See our product support options
Allgemeine Anfragen und Standorte
Kontakt

 Control-M + Hadoop
Ihr Hadoop-Workflow startet, bevor ein Spark-, Hive- oder MapReduce-Job ausgeführt wird – und er kann scheitern, wenn etwas im Vorstrom kaputtgeht. Ein erwarteter Datensatz landet nie in HDFS. Ein Sqoop-Import aus einer operativen Datenbank wird spät abgeschlossen. Control-M orchestriert die gesamte Kette: HDFS-Datenankunft, Sqoop-Aufnahme, Hadoop-Ausführung und nachgelagerte Lieferung.
Häufige Workflow-Probleme
Klingt das nach deiner Woche?
Das sind keine Randfälle. Das sind die normalen Betriebsbedingungen für Teams, die Hadoop-Jobs über mehrere Tools hinweg ausführen. So geht Control-M mit jedem einzelnen um.
HDFS-DATENANKUNFT
Dein 2 Uhr morgens. Der Spark-Job beginnt. Der HDFS-Eingang ist immer noch nicht da.
Control-M nutzt Dateibeobachtung, um die Ankunft von HDFS-Daten zu erkennen und wartet auf die erforderlichen Daten, bevor die abhängige Verarbeitung freigegeben wird. Spark-, Hive- oder MapReduce-Jobs bleiben gesperrt, bis die Dateibedingung erfüllt ist, um unvollständige Eingaben zu verhindern, die stromabwärts kaskadieren.
BELASTUNGSVERZÖGERUNG
Dein Sqoop-Import verspätet sich. Die nachgelagerte Hive-Verarbeitung wartet bereits.
Control-M verfolgt Sqoop und Hive im selben Workflow und wendet Abhängigkeiten zwischen ihnen an. Die Hive-Verarbeitung beginnt mit der tatsächlichen Upstream-Fertigstellung und nicht mit einem angenommenen Cron-Fenster, wodurch manuelle Überprüfungen und spröde Zeitplanverschiebungen eliminiert werden.
FUNKENAUSFALL
Dein Spark-Job scheitert über Nacht. Alles weiter unten muss aufhören.
Control-M erkennt den ausfallenden Jobzustand und verhindert, dass abhängige Verarbeitung voranschreitet. Wiederherstellungslogik kann angewendet werden, bevor nachgelagerte Jobs freigegeben werden, um den Fehler einzudämmen, anstatt schlechte oder fehlende Ausgaben durch die Pipeline weitergeben zu lassen.
OOZIE-KOORDINATION
Dein Oozie-Workflow ist lang. Das Lieferfenster nach unten wird immer kleiner.
Control-M kann Oozie-Workflows extrahieren und deren Aktionen in die Control-M-Planungsumgebung übertragen. Betriebsteams können diese Jobs mit umliegenden Abhängigkeiten und SLA-Anforderungen koordinieren, anstatt den Oozie-Workflow isoliert zu verwalten.
SLA-RISIKO
Die Hadoop-Verarbeitung läuft noch. Deine Lieferung um 6 Uhr morgens ist gefährdet.
Control-M verbindet Hadoop-Jobs mit dem Enterprise-SLA-Management und dem weiteren Produktionsworkflow. Teams können sehen, wie verzögerte Cluster-Verarbeitung die Lieferfrist beeinflusst und handeln, bevor ein langjähriger Job zu einem verpassten Geschäfts-SLA wird.
INTEGRATIONSFAKTEN
Control-M + Hadoop
|
workload.types |
Spark Python · Spark Scala/Java · Pig · Sqoop · Hive · DistCp · HDFS-Befehle · MapReduce · Oozie |
|
trigger.type |
Ankunft der HDFS-Datei · Zeitplan · Abschluss eines vorgelagerten Auftrags · Control-M-Ereignis · Workflow-Abhängigkeit |
|
cross_tool.deps |
Spark-Job · Sqoop Import/Export · Hive-Job · Oozie-Workflow · Datenbank-Job · Dateiübertragung · Downstream-Anwendung |
|
cloud.platforms |
Hadoop-Cluster · Linux-Edge-Node · Control-M SaaS · Control-M Selbstgehostet |
|
error_handling |
Fehlerbehandlung vor dem Befehl · Nachbefehlsfehlerbehandlung · Abhängigkeitsgating · Wiederherstellungsmaßnahmen · Ressourcenkontrollen · SLA-Überwachung |
|
Durchsatz |
Verteilte Batchverarbeitung · große Datensätze · Cluster-Ausführung · verteilte Kopie · Hadoop-Streaming |
|
Beobachtbarkeit |
Zentralisierte Auftragsüberwachung · YARN-aggregierte Logs · Ausführungsausgabe · Abhängigkeitssichtbarkeit · SLA-Nachverfolgung · Jobhistorie |
End-to-End-Orchestrierung
Ein Produktionsworkflow. Jedes Tool im Stack.
Control-M orchestriert Arbeitsabläufe über Hadoop, Spark, Hive, Sqoop, Datenbanken, Dateiübertragungen und Cloud-Dienste in einem einzigen Job-Flow – mit Abhängigkeitsverfolgung, SLA-Transparenz und automatisierter Wiederherstellung über alle hinweg.
- Cross-Tool-Abhängigkeit: Sqoop → Spark → Hive → Analytics-Handoff
- Datenbewusste Trigger: HDFS-Dateiankunft, Upstream-Abschluss, API-Ereignis, Jobstatus
|
Hadoop |
Verteilte Verarbeitung · Abhängigkeitsorchestrierung · SLA-Koordination |
|
Spark |
Python-Ausführung · Scala/Java-Ausführung · Anwendungsargumente & Spark-Submitt-Optionen |
|
Bienenstock |
Abfrageausführung · Parameter · Abhängigkeitssteuerung |
|
Sqoop |
Befehlsausführung · Importe/Exporte · Workflow-Sequenzierung |
|
HDFS |
Dateibeobachtung · HDFS-Befehle · Datenabhängigkeiten |
|
Oozie |
Workflow-Ausführung · Workflow-Extraktion · Aktionskoordination |
|
Dateiübertragung |
eingehende Daten · ausgehende Lieferung · Komplettabhängigkeiten |
Koexistenz des Luftstroms
Control-M ersetzt deine Airflow DAGs nicht. Es verläuft die Schicht darüber.
Der Einwand ist häufig: "Wir sind bereits auf Airflow." Das Problem ist nicht, was Airflow macht – sondern was vor und nach Airflow passiert. Genau hier versagen Pipelines tatsächlich.
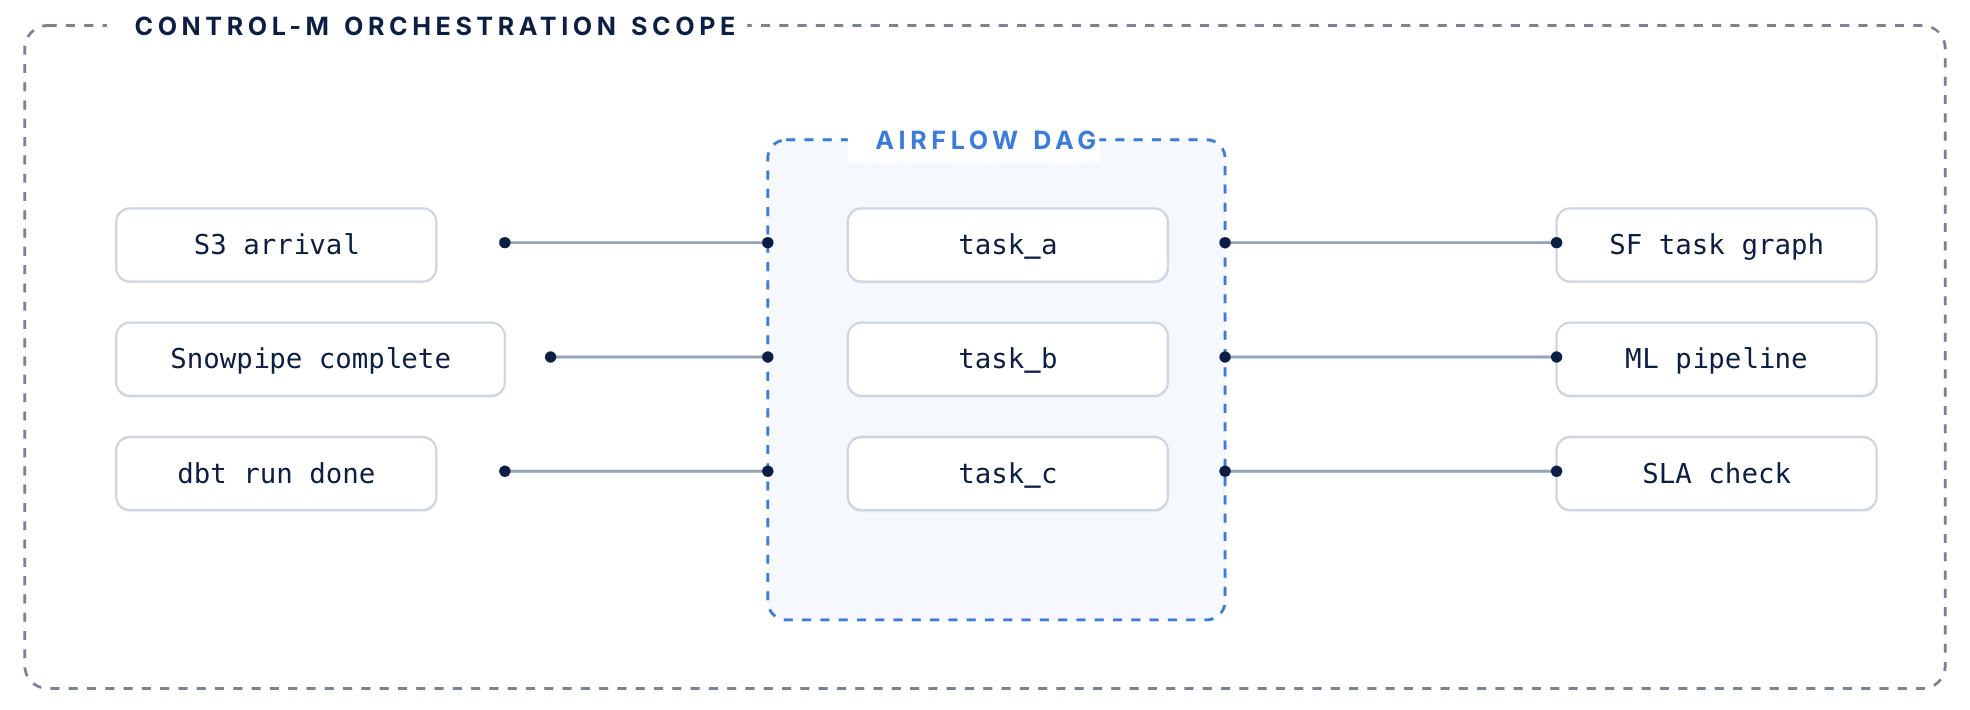
Der Luftstrom steuert seinen DAG. Control-M verwaltet alles Umliegende.
Luftstromregler
Orchestrierung auf DAG-Ebene innerhalb der Datenpipeline
- DAG-Level-Aufgabenorchestrierung innerhalb von Datenpipelines
- Python-Operatoren, Sensoren und Aufgabenabhängigkeiten
- Ausführungsgraph für Jobs, die in deiner Pipeline laufen
- Verwaltet erneute Versuche innerhalb eines einzigen DAG-Kontexts
Control-M fügt hinzu
Die Koordinationsschicht um deine DAGs herum
- Koordinationsschicht rund um DAGs – löst den Airflow basierend auf upstream-Bedingungen aus: Dateiankünfte, API-Ereignisse, andere Werkzeugabschlüsse
- Verfolgt den SLA-Beitrag jedes DAG über den gesamten End-to-End-Workflow, nicht nur über die eigene Routine
- Verwaltet die Fehlerwiederherstellung, wenn upstream-Abhängigkeiten ausfallen, bevor der Luftstrom überhaupt startet.
- Bestehende DAGs müssen nicht umgeschrieben oder migriert werden
PIPELINES ÜBERWACHEN
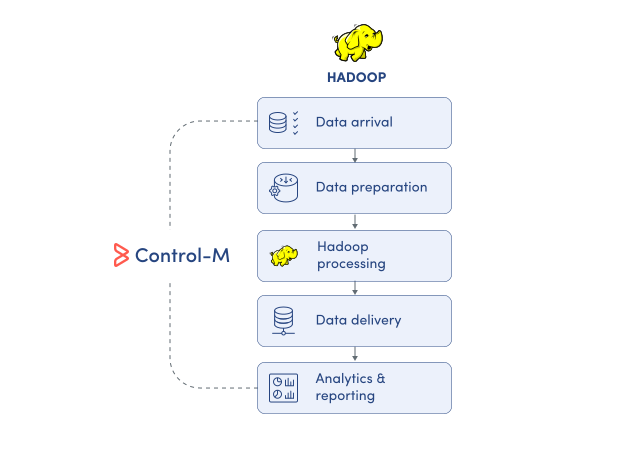
Überwachen Sie Hadoop-Jobs über die gesamte Datenpipeline.
Die Hadoop-Verarbeitung ist oft nur eine Stufe in einer Produktionsdatenpipeline. Control-M bietet eine zentrale Übersicht über Hadoop und umliegende Systeme hinweg und hilft Teams, die Ausführung vom Dateneingang im Vorfeld über die Verarbeitung bis hin zur nachgelagerten Lieferung zu verfolgen:
-
Hadoop-Job-Ausführungsstatus
-
Joblaufzeit und Historie
-
Upstream- und Downstream-Abhängigkeiten
-
Sichtbarkeit von Pipeline-Fehlern
-
SLA-Risikoindikatoren
SLA-SICHERUNG
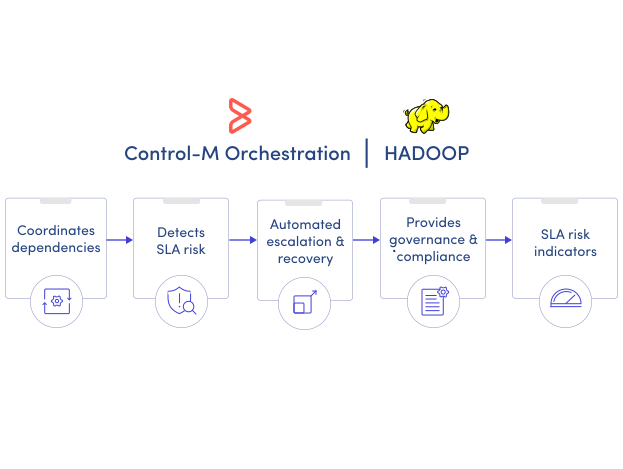
Halten Sie die Hadoop-Verarbeitung an die Auslieferungs-SLAs ausgerichtet.
Der native Jobstatus zeigt an, ob die Hadoop-Verarbeitung lief, nicht ob die gesamte Geschäftspipeline pünktlich abgeschlossen wird. Control-M verbindet Hadoop-Jobs mit dem End-to-End-SLA-Management, sodass Teams das Lieferrisiko identifizieren und angehen können:
-
End-to-End-SLA-Tracking
-
Sichtbarkeit der kritischen Pfad-Jobs
-
Verspätete Jobbenachrichtigungen
-
Abhängigkeitsbewusste Downstream-Steuerung
-
Zentralisierte Wiederherstellungsaktionen
Dokumentation
Bring Ordnung in komplexe Arbeitsabläufe
Erfahren Sie, wie Control-M Teams hilft, komplexe Prozesse mit größerer Transparenz, Koordination und Kontrolle zu orchestrieren.
