Sagen Sie uns, wie wir helfen können
Vertrieb & Preise
Speak to a rep about your business needs

Hilfe & Support
See our product support options
Allgemeine Anfragen und Standorte
Kontakt

 Control-M + Tajo
Ihr Tajo-Workflow startet, bevor eine verteilte SQL-Abfrage überhaupt ausgeführt wird – und er kann ausfallen, wenn etwas im Vorstrom kaputtgeht. Eine HDFS-Partition kommt unvollständig an. Eine Spark-Transformation endet nach ihrem Verarbeitungsfenster. Control-M orchestriert die gesamte Kette – HDFS-Datenankunft, Spark-Transformation und Tajo-Abfrageausführung über Control-M für Hadoop – bis zur nachgelagerten Lieferung.
Häufige Workflow-Probleme
Klingt das nach deiner Woche?
ANKUNFT DER HDFS
Deine 02:00 Tajo-Anfrage beginnt. Die HDFS-Eingabe ist noch unvollständig.
Control-M's HDFS File Watcher wartet auf den erforderlichen Pfad und die minimale Dateigröße, bevor der Tajo-Job freigegeben wird. Fehlende oder unterdimensionierte Daten halten die Ausführung gesperrt, sodass verhindert wird, dass die Abfrage gegen eine unvollständige Eingabe startet.
STROMVERZÖGERUNG
Deine Spark-Verwandlung verspätet sich. Tajo wartet bereits flussabwärts.
Control-M modelliert Spark und Tajo als abhängige Jobs im selben Workflow. Die Tajo-Abfrage wartet auf einen erfolgreichen Upstream-Abschluss, anstatt sich auf ein festes Cron-Fenster zu verlassen, wodurch die Ausführung mit der tatsächlichen Datenbereitschaft ausgerichtet bleibt
BEFEHLSFEHLER
Ein HDFS-Vorbereitungsbefehl schlägt fehl, bevor die Tajo-Abfrage überhaupt beginnt.
Control-M führt HDFS-Pre-Commands vor der Tajo-Ausführung aus und kann den Job scheitern, wenn ein Vorbereitungsbefehl fehlschlägt. Die Abfrage wird gestoppt, bevor kompromittierte Eingaben verarbeitet werden, während Operatoren einen klaren Jobfehler erhalten, der untersucht werden soll.
FRAGEFEHL
Eine Produktions-Tajo-Abfrage scheitert mitten in der nächtlichen Verarbeitungskette.
Control-M erfasst das Jobergebnis innerhalb des größeren Workflows, verhindert den Fortschreiten der abhängigen Verarbeitung und deckt das Scheitern für die Operationen auf. Die Wiederherstellung kann aus demselben Workflow-Kontext koordiniert werden, anstatt Fehler über getrennte Zeitpläne hinweg nachzuverfolgen.
SLA-RISIKO
Die Anfrage gelingt – aber die nachgelagerte Lieferung ist jetzt im späten Trend.
Control-M verfolgt Tajo als Teil des vollständigen Services und nicht als isolierte Abfrage. Das SLA-Management überwacht die kritische Auftragskette und kann Verzögerungsrisiken aufdecken, bevor die endgültige Lieferfrist verpasst wird.
INTEGRATIONSFAKTEN
Control-M + Tajo
|
workload.types |
Tajo-Öffnungsanfragen · Tajo-Eingabedatei-Jobs · verteilte SQL-Abfragen · HDFS-Analysen · Batch-ETL · Ad-hoc-Abfrageausführung |
|
trigger.type |
Ankunft der HDFS-Datei · HDFS-Mindestgrößenschwelle · Zeitplan · Abschluss des vorgelagerten Auftrags · Control-M-Ereignis · Einreichung der Automatisierungs-API |
|
cross_tool.deps |
Alle wurden über Control-M für Hadoop geliefert: HDFS File Watcher · HDFS-Befehle · Apache Spark · Apache Hive · Sqoop · Java MapReduce · Pig · Oozie-Workflows · Dateizustellung |
|
cloud.platforms |
On-premises Hadoop-Cluster (HDFS) · mindestens ein Control-M/Agent mit Control-M für Hadoop pro Cluster · Control-M SaaS-Orchestrierung des Hadoop-Clusters |
|
error_handling |
Fehlererkennung vor dem Befehl · Nachbefehls-Ausfallbehandlung · Downstream-Abhängigkeitsgating · Job-Ausfallwarnungen · SLA-Überwachung · kontrollierte Wiederherstellung |
|
Durchsatz |
verteilte SQL-Workloads · große HDFS-Datensätze · Batch-ETL · Ad-hoc-Analysen · Eingabedateigesteuerte SQL-Ausführung |
|
Beobachtbarkeit |
Job-Ausführungsstatus · Jobausgabe · Abhängigkeitssichtbarkeit · Workflow-Geschichte · SLA-Tracking · Ausfallwarnungen · End-to-End-Workflow-Überwachung |
End-to-End-Orchestrierung
Ein Produktionsworkflow. Jedes Tool im Stack.
Control-M orchestriert Workflows über Tajo, HDFS, Spark, Hive, Sqoop, Dateiübertragungen und Hadoop-Dienste in einem einzigen Job-Flow – mit Abhängigkeitsverfolgung, SLA-Transparenz und automatisierter Wiederherstellung über alle hinweg.
- Cross-Tool-Abhängigkeit: HDFS-Ankunft → Spark-Transformation → Tajo-Abfrage → Analytics-Handoff
- Datenbewusste Auslöser: HDFS-Dateiankunft, Mindestdateigröße, Abschluss eines vorgelagerten Auftrags, geplante Verarbeitung
|
Tajo (ein Hadoop-Jobtyp) |
Offen-Abfrage-Ausführung · Eingabedatei-Ausführung · Vor-/Nach-HDFS-Befehle · |
|
Workflow-Abhängigkeiten HDFS |
Dateiankunft beobachtet · Mindestgrößenkriterium · HDFS-Befehle · Datenbereitschafts-Sperrung |
|
Apache Spark |
Python-Ausführung · Java/Scala-Anwendungen · Orchestrierung der Upstream-Transformation |
|
Apache Hive |
Hive-Job-Ausführung · Skriptparameter · Hadoop-Workflow-Abhängigkeiten |
|
Sqoop |
Befehlsausführung · Datenbewegungsorchestrierung · abhängige Verarbeitung |
|
Oozie |
Workflow-Ausführung · Auftragseigenschaften · koordinierte Hadoop-Verarbeitung |
|
Control-M MFT |
verwaltete Dateibewegung · Lieferabhängigkeiten · Downstream-Workflow-Auslösung) |
Koexistenz des Luftstroms
Control-M ersetzt deine Airflow DAGs nicht. Es verläuft die Schicht darüber.
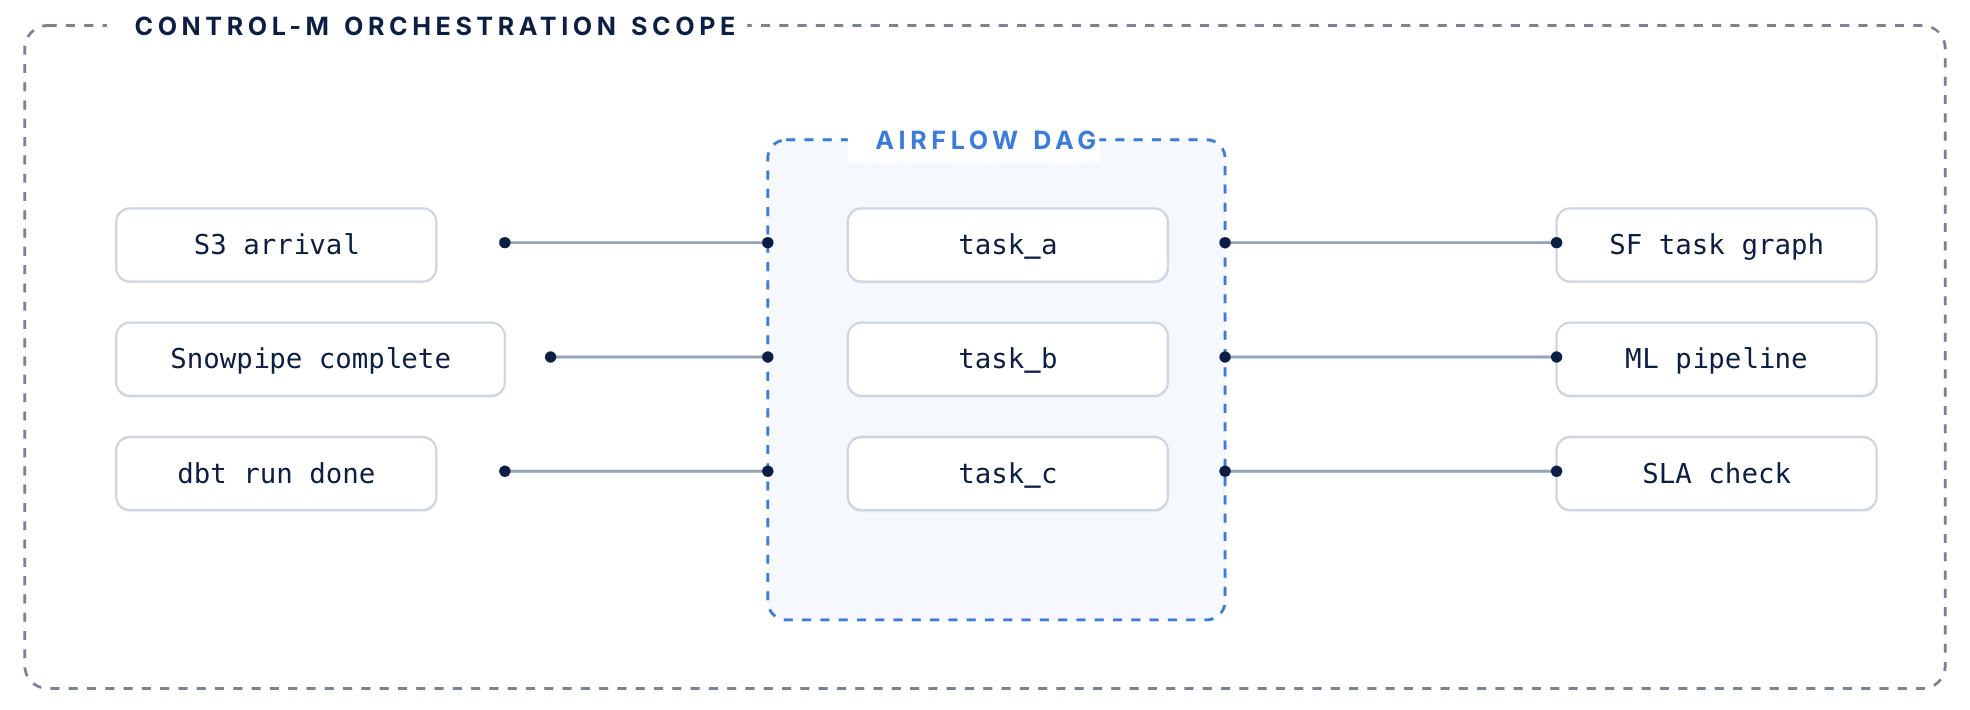
Der Luftstrom steuert seinen DAG. Control-M verwaltet alles Umliegende.
Luftstromregler
Orchestrierung auf DAG-Ebene innerhalb der Datenpipeline
- DAG-Level-Aufgabenorchestrierung innerhalb von Datenpipelines
- Python-Operatoren, Sensoren und Aufgabenabhängigkeiten
- Ausführungsgraph für Jobs, die in deiner Pipeline laufen
- Verwaltet erneute Versuche innerhalb eines einzigen DAG-Kontexts
Control-M fügt hinzu
Die Koordinationsschicht um deine DAGs herum
- Koordinationsschicht rund um DAGs – löst den Airflow basierend auf upstream-Bedingungen aus: Dateiankünfte, API-Ereignisse, andere Werkzeugabschlüsse
- Verfolgt den SLA-Beitrag jedes DAG über den gesamten End-to-End-Workflow, nicht nur über die eigene Routine
- Verwaltet die Fehlerwiederherstellung, wenn upstream-Abhängigkeiten ausfallen, bevor der Luftstrom überhaupt startet.
- Bestehende DAGs müssen nicht umgeschrieben oder migriert werden
PIPELINES ÜBERWACHEN
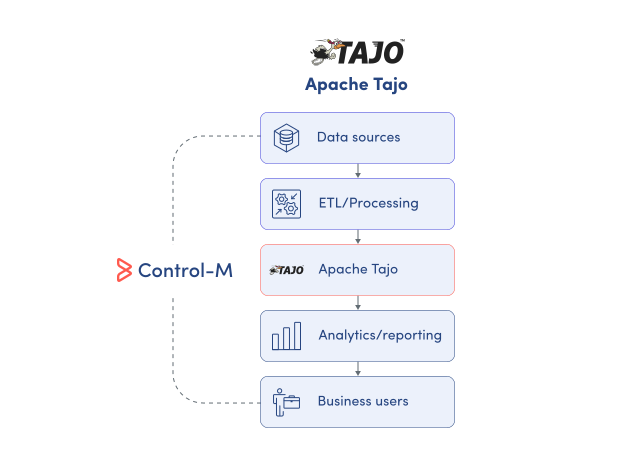
Siehe Tajo-Ausführung in der vollständigen Datenpipeline
Tajo zeigt, was in seiner verteilten Abfrageumgebung passiert; es bietet nicht die Betriebsansicht jeder externen Abhängigkeit rund um diese Abfrage. Control-M verbindet die Ausführung von Tajo mit dem größeren Produktionsworkflow und gibt Datenteams Transparenz in:
-
Tajo-Jobausführungsstatus
-
Upstream- und Downstream-Abhängigkeiten
-
Joboutput und Fehlschläge
-
End-to-End-Workflow-Geschichte
-
Plattformübergreifender Verarbeitungsstatus
SLA-SICHERUNG
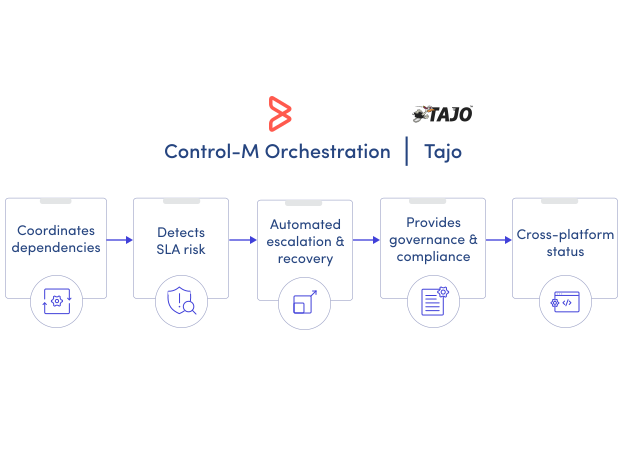
Halte Tajo-abhängige Datendienste im Zeitplan
Eine erfolgreiche Tajo-Abfrage kann dennoch zu einer verpassten Lieferung beitragen, wenn die Upstream-Verarbeitung spät beginnt oder Downstream-Arbeit ins Stocken gerät. Control-M verwaltet den Service über die gesamte Abhängigkeitskette, sodass Teams das Planungsrisiko erkennen können, bevor die Lieferung beeinträchtigt wird:
-
End-to-End-SLA-Tracking
-
Sichtbarkeit der kritischen Pfadabhängigkeit
-
Prädiktive Verzögerungsdetektion
-
Automatisierte Ausfallwarnungen
-
Koordinierte nachgelagerte Bergung
