


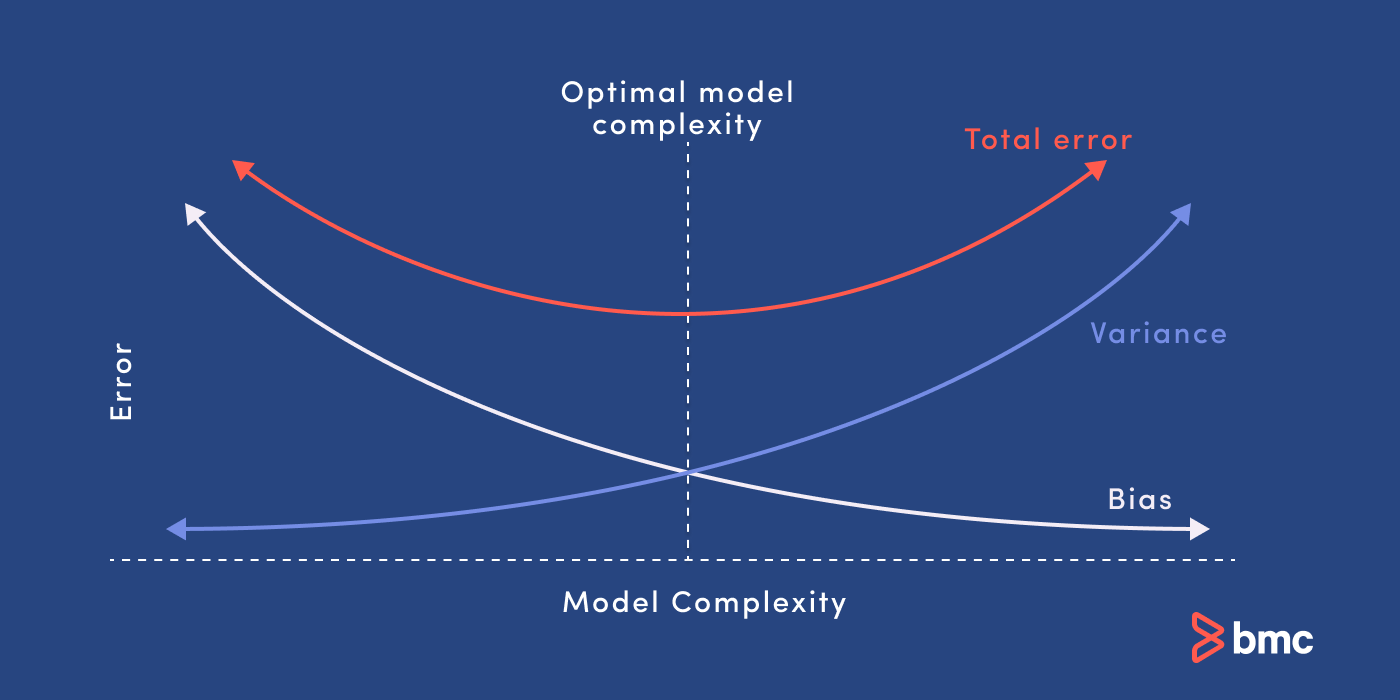


Auf einen Blick: Das Verständnis des Bias-Varianz-Kompromisses ist entscheidend für die Erstellung effektiver Machine-Learning-Modelle, da Bias zu systematischen Fehlern führt, während die Varianz aus einer Überempfindlichkeit gegenüber Datenschwankungen resultiert.
- Das Ausbalancieren von Bias und Varianz hilft, Underfitting und Overfitting zu vermeiden.
- Eine steigende Modellkomplexität oder die Menge an Trainingsdaten kann helfen, diesen Kompromiss zu managen.
Jeder Data Engineer muss ein Verständnis für den Kompromiss zwischen Verzerrung und Varianz im maschinellen Lernen (ML) entwickeln. ML wird täglich in immer mehr Anwendungen eingesetzt. Sprach- und Bilderkennung, Betrugserkennung, Chatbots und generative KI sind mittlerweile gängige Anwendungen dieser Technologie. Die zunehmende Nutzung von ML bringt die Feinheiten der Funktionsweise von Machine-Learning-Algorithmen aus spezialisierten Laboren in den Mainstream der Informationstechnologie. Maschinelle Lernmodelle dürfen keine Blackbox sein. Data Engineers und Nutzer großer Datensätze müssen verstehen, wie sie verschiedene Algorithmen und Lernanforderungen erstellen und bewerten, wenn sie ihre ML-Modelle erstellen und bewerten. Verzerrung und Varianz im maschinellen Lernen beeinflussen die Gesamtgenauigkeit jedes Modells (was aus einer Verwirrungsmatrix interpretiert werden kann), das Vertrauen in seine Ergebnisse und Ergebnisse sowie seine Fähigkeit, Maschinen zum Lernen zu trainieren. In diesem Artikel werden wir erläutern, was Verzerrung und Varianz im maschinellen Lernen sind. Wir werden auch darauf eingehen, wie man mit dem Kompromiss zwischen Verzerrung und Varianz umgeht, wenn man nützliche Algorithmen für Ihre ML-Anwendungen entwickelt. (Neu bei ML? Lesen Sie unsere Erklärung zu ML vs. KI.)
Voreingenommenheit vs. Varianz und der Kompromiss
Bias und Varianz sind zwei Fehlerquellen in prädiktiven Modellen. Das richtige Gleichgewicht zwischen Verzerrung und Varianz ist grundlegend für effektive maschinelle Lernalgorithmen. Hier ist eine kurze Erklärung dieser Konzepte:
- Verzerrung. Verzerrung bezieht sich auf Fehler, die durch ein Modell zur Lösung komplexer Probleme verursacht werden, das zu vereinfacht ist, bedeutende Annahmen trifft und wichtige Beziehungen in Ihren Daten übersieht.
- Varianz. Varianz ist ein Fehler, der durch einen Algorithmus verursacht wird, der zu empfindlich auf Datenschwankungen reagiert und ein überkomplexes Modell schafft, das Muster in den Daten erkennt, die in Wirklichkeit nur Zufall sind.
- Bias-Varianz-Kompromiss. Die Minimierung von Fehlern, die durch Vereinfachung und übermäßige Komplikationen verursacht werden, erfordert das richtige Gleichgewicht oder den richtigen Kompromiss zwischen beiden.
Was ist Voreingenommenheit im maschinellen Lernen?

Verzerrung im ML wird manchmal als das "zu einfache" Problem bezeichnet. Verzerrung wird als systematischer Fehler betrachtet, der im maschinellen Lernmodell selbst aufgrund falscher Annahmen im ML-Prozess auftritt. Technisch gesehen können wir Verzerrung als den Fehler zwischen der durchschnittlichen Modellvorhersage und der Grundwahrheit definieren. Außerdem beschreibt er, wie gut das Modell mit dem Trainingsdatensatz übereinstimmt:
- Hoher Bias. Ein Modell mit einem höheren Bias würde dem Datensatz nicht eng übereinstimmen.
- Geringer Bias. Ein Modell mit niedriger Verzerrung entspricht dem Trainingsdatensatz sehr genau.
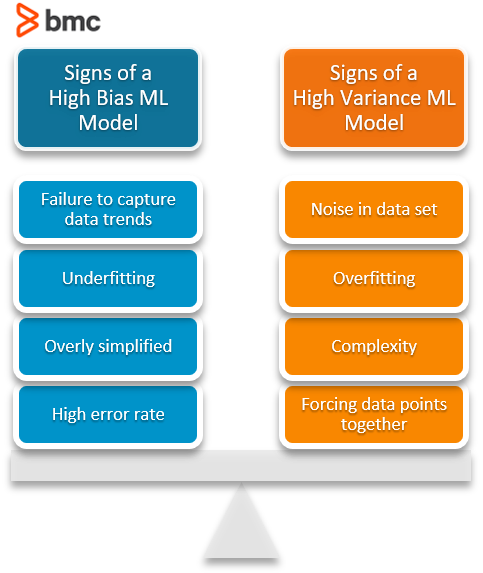
Merkmale eines High-Bias-Modells umfassen:
- Versäumnis, korrekte Datentrends zu erfassen
- Potenzial für Underfitting
- Verallgemeiner/zu sehr vereinfacht
- Hohe Fehlerquote
Was ist Varianz im maschinellen Lernen?
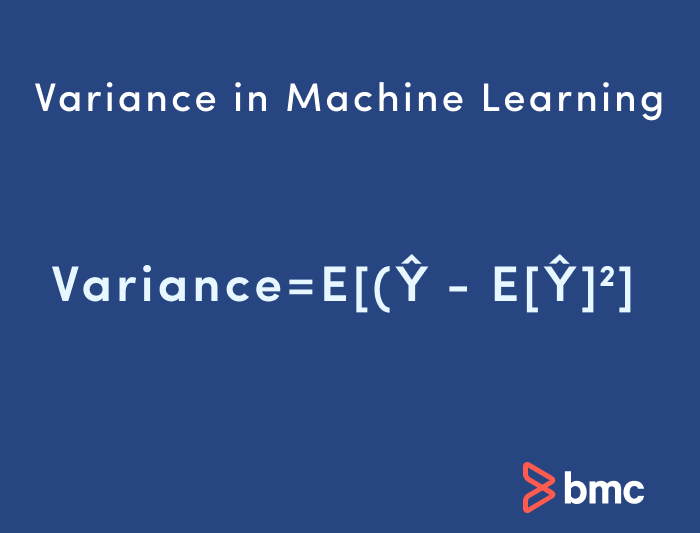
Varianz im maschinellen Lernen wird manchmal als das "zu sensible" Problem bezeichnet. Varianz im ML bezeichnet die Änderungen im Modell bei Verwendung verschiedener Teile des Trainingsdatensatzes. Einfach ausgedrückt ist Varianz die Variabilität in der Modellvorhersage – wie sehr sich die ML-Funktion je nach gegebenem Datensatz anpassen kann. Varianz stammt aus hochkomplexen Modellen mit einer großen Anzahl von Merkmalen.
- Geringe Varianz. Modelle mit hohem Bias haben eine geringe Varianz.
- Hohe Varianz. Modelle mit hoher Varianz haben eine geringe Verzerrung.
All dies trägt zur Flexibilität des Modells bei. Ein Modell, das beispielsweise nicht einem Datensatz mit hoher Verzerrung entspricht, erzeugt ein unflexibles Modell mit geringer Varianz, das zu einem suboptimalen Machine-Learning-Modell führt. Merkmale eines Hochvarianzmodells umfassen:
- Rauschen im Datensatz
- Potenzial für Overfitting
- Komplexe Modelle
- Ich versuche, alle Datenpunkte so nah wie möglich zu platzieren
Der Einstieg mit AIOps ist einfach. Erfahren Sie, wie Sie die steigende IT-Komplexität problemlos bewältigen können! ›
Underfitting und Overfitting
Anhand unseres Fruchtbeispiels sehen Sie, wie wichtig es ist, dass Ihr Modell die Daten abstimmt. Wie gut Ihr Modell zu den Daten passt, korreliert direkt mit der Genauigkeit, wie genau es bei Identifikationen oder Vorhersagen aus einem Datensatz abschneidet.
- Underfitting tritt auf, wenn dein Modell zu einfach ist, um Variationen und Muster in deinen Daten zu erfassen. Die Maschine lernt nicht die richtigen Eigenschaften und Beziehungen aus den Trainingsdaten und schneidet daher schlecht mit nachfolgenden Datensätzen ab. Sie könnte an einem roten Apfel trainiert werden und eine rote Kirsche mit einem Apfel verwechseln.
- Overfitting tritt auf, wenn ein Modell zu komplex ist, mit zu vielen Details und zufälligen Schwankungen oder Störungen im Trainingsdatensatz. Die Maschine erkennt dieses Rauschen fälschlicherweise als echte Muster an und kann daher nicht verallgemeinern und reale Muster in nachfolgenden Datensätzen erkennen. Sie kann auf viele Details eines bestimmten Apfeltyps trainiert werden und daher keine Äpfel finden, wenn sie nicht all diese Details enthalten.
Bias–Varianz-Kompromiss
Verzerrung und Varianz sind umgekehrt verbunden. Es ist unmöglich, ein ML-Modell mit geringem Bias und niedriger Varianz zu haben. Wenn ein Data Engineer den ML-Algorithmus so modifiziert, dass er einen gegebenen Datensatz besser anpasst, führt dies zu geringem Bias – aber es erhöht die Varianz. So passt das Modell zum Datensatz und erhöht die Wahrscheinlichkeit ungenauer Vorhersagen. Dasselbe gilt bei der Erstellung eines niedrigen Varianzmodells mit höherem Bias. Obwohl das das Risiko ungenauer Vorhersagen reduziert wird, passt das Modell den Datensatz nicht richtig ab. Es ist ein empfindliches Gleichgewicht zwischen diesen Verzerrungen und der Varianz. Wichtig ist jedoch, dass eine höhere Varianz nicht auf einen schlechten ML-Algorithmus hinweist. Maschinelle Lernalgorithmen sollten mit einigen Varianzen umgehen können. Wir können den Kompromiss auf verschiedene Arten angehen...
- Erhöht die Komplexität des Modells, um auf Verzerrung und Varianz zu zählen, wodurch die Gesamtverzerrung verringert und die Varianz auf ein akzeptables Niveau erhöht wird. Dadurch wird das Modell mit dem Trainingsdatensatz ausgerichtet, ohne signifikante Varianzfehler zu verursachen.
- Die Vergrößerung des Trainingsdatensatzes kann ebenfalls helfen, diesen Kompromiss bis zu einem gewissen Grad auszugleichen. Dies ist die bevorzugte Methode beim Umgang mit Overfitting-Modellen. Darüber hinaus ermöglicht dies den Nutzern, die Komplexität ohne Varianzfehler zu erhöhen, die das Modell wie bei einem großen Datensatz verschmutzen.
Ein großer Datensatz bietet dem Algorithmus mehr Datenpunkte, um die Daten leicht zu verallgemeinern. Das Hauptproblem bei der Vergrößerung des Handelsdatensatzes besteht jedoch darin, dass Underfitting- oder Low-Bias-Modelle nicht sehr empfindlich auf den Trainingsdatensatz reagieren. Daher ist die Erhöhung der Daten die bevorzugte Lösung im Umgang mit Modellen mit hoher Varianz und hohem Bias. Diese Tabelle listet gängige Algorithmen und ihr erwartetes Verhalten in Bezug auf Bias und Varianz auf:
| Algorithmus | Voreingenommenheit | Varianz |
| Lineare Regression | Hohe Verzerrung | Weniger Varianz |
| Entscheidungsbaum | Niedrige Verspannungen | Hohe Varianz |
| Einpacken | Niedrige Verspannungen | Hohe Varianz (kleiner als Entscheidungsbaum) |
| Zufälliger Wald | Niedrige Verspannungen | Hohe Varianz (weniger als Entscheidungsbaum und Bagging) |
Bias- und Varianzberechnung Python-Beispiel
Lassen Sie uns diese Konzepte in die Praxis umsetzen – wir berechnen Verzerrung und Varianz mit Python. Am einfachsten ist die Verwendung einer Bibliothek namens mlxtend (Machine Learning Extension), die für Data-Science-Aufgaben gedacht ist. Diese Bibliothek bietet eine Funktion namens bias_variance_decomp, mit der wir Bias und Varianz berechnen können. Wir werden den in mlxtend enthaltenen Iris-Datensatz als Basisdatensatz verwenden und die bias_variance_decomp mit zwei Algorithmen durchführen: Decision Tree und Bagging.
Beispiel für Entscheidungsbäume
    from mlxtend.evaluate import bias_variance_decomp
from sklearn.tree import DecisionTreeClassifier
from mlxtend.data import iris_data
from sklearn.model_selection import train_test_split

# Get Data Set
X, y = iris_data()
X_train_ds, X_test_ds, y_train_ds, y_test_ds = train_test_split(X, y,
                                                    test_size=0.3,
                                                    random_state=123,
                                                    shuffle=True,
                                                    stratify=y)

# Define Algorithm
tree = DecisionTreeClassifier(random_state=123)

# Get Bias and Variance - bias_variance_decomp function
avg_expected_loss, avg_bias, avg_var = bias_variance_decomp(
        tree, X_train_ds, y_train_ds, X_test_ds, y_test_ds,
        loss='0-1_loss',
        random_seed=123,
        num_rounds=1000)

# Display Bias and Variance
print(f'Average Expected Loss: {round(avg_expected_loss, 4)}n')
print(f'Average Bias: {round(avg_bias, 4)}')
print(f'Average Variance: {round(avg_var, 4)}')
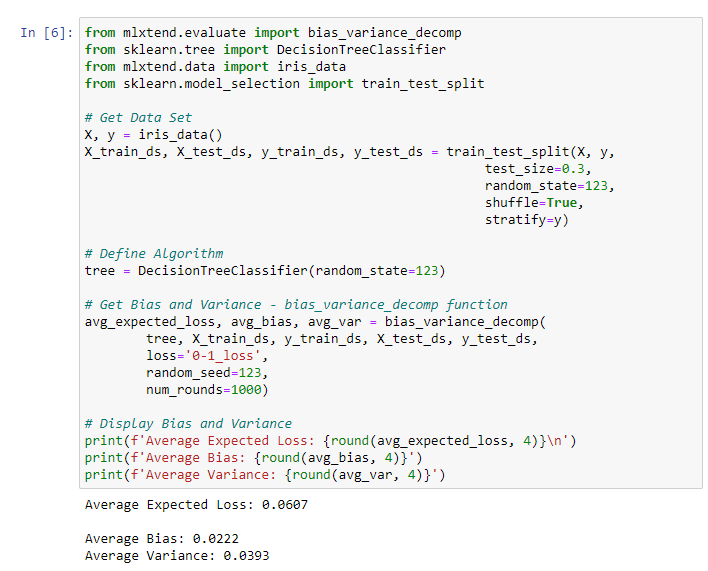
Ergebnis:
Beispiel zum Beuteln
    from mlxtend.evaluate import bias_variance_decomp
from sklearn.tree import DecisionTreeClassifier
from mlxtend.data import iris_data
from sklearn.model_selection import train_test_split
from sklearn.ensemble import BaggingClassifier

# Get Data Set
X, y = iris_data()
X_train_ds, X_test_ds, y_train_ds, y_test_ds = train_test_split(X, y,
                                                    test_size=0.3,
                                                    random_state=123,
                                                    shuffle=True,
                                                    stratify=y)

# Define Algorithm
tree = DecisionTreeClassifier(random_state=123)
bag = BaggingClassifier(base_estimator=tree,
                        n_estimators=100,
                        random_state=123)

# Get Bias and Variance - bias_variance_decomp function
avg_expected_loss, avg_bias, avg_var = bias_variance_decomp(
        bag, X_train_ds, y_train_ds, X_test_ds, y_test_ds,
        loss='0-1_loss',
        random_seed=123,
        num_rounds=1000)

# Display Bias and Variance
print(f'Average Expected Loss: {round(avg_expected_loss, 4)}n')
print(f'Average Bias: {round(avg_bias, 4)}')
print(f'Average Variance: {round(avg_var, 4)}')
Ergebnis:
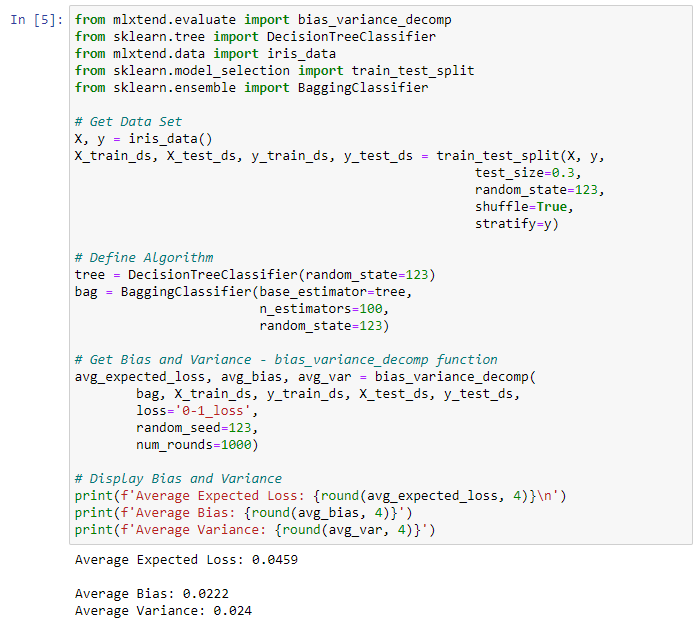
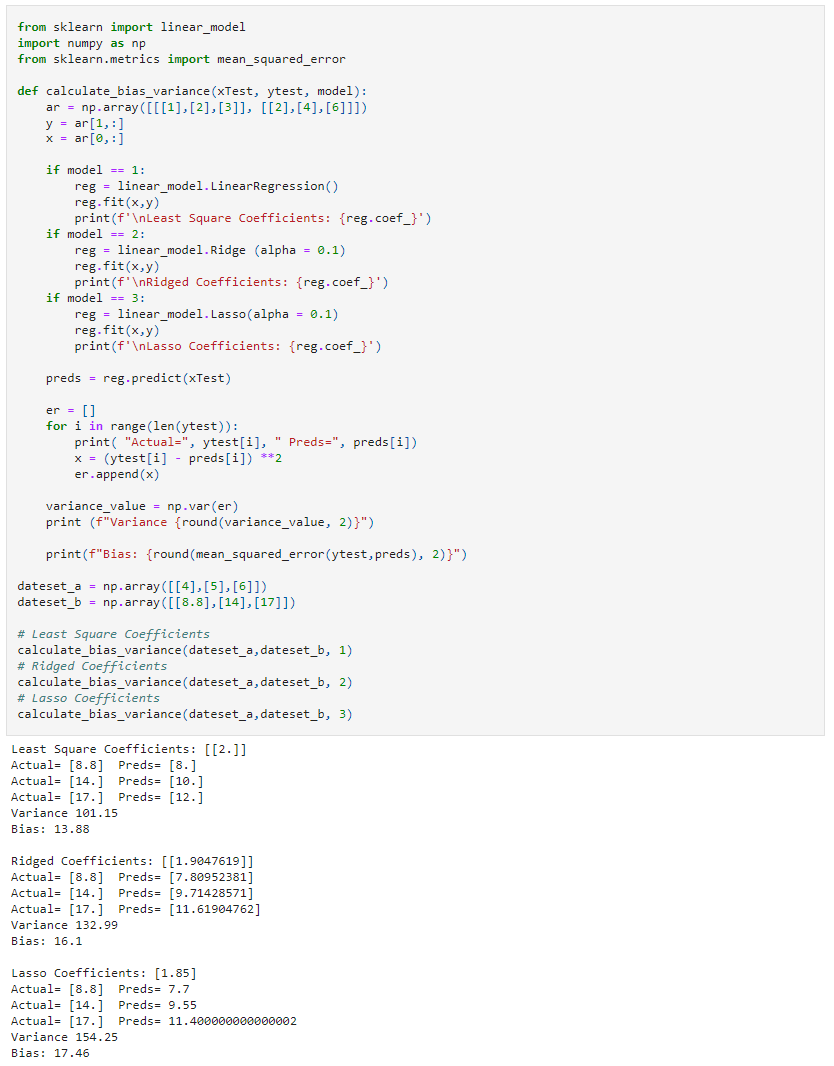
Jede der oben genannten Funktionen führt 1.000 Runden (num_rounds=1000) durch, bevor die durchschnittlichen Werten von Bias und Varianz berechnet werden. Wir können die Varianz reduzieren, ohne den Bias zu beeinflussen, indem wir einen Bagging-Klassifikator verwenden. Je höher die Algorithmuskomplexität, desto geringer die Varianz. Im folgenden Beispiel betrachten wir drei verschiedene lineare Regressionsmodelle: Least-squares, Ridge und Lasso mit der Sklearn-Bibliothek. Da sie alle lineare Regressionsalgorithmen sind, wird ihr Hauptunterschied der Koeffizientenwert sein. Wir sehen, dass diese unterschiedlichen Algorithmen zu unterschiedlichen Ergebnissen im ML-Prozess führen (Bias und Varianz).
    from sklearn import linear_model
import numpy as np
from sklearn.metrics import mean_squared_error

def calculate_bias_variance(xTest, ytest, model):
    ar = np.array([[[1],[2],[3]], [[2],[4],[6]]])
    y = ar[1,:]
    x = ar[0,:]

    if model == 1:
        reg = linear_model.LinearRegression()
        reg.fit(x,y)
        print(f'nLeast Square Coefficients: {reg.coef_}')
    if model == 2:
        reg = linear_model.Ridge (alpha = 0.1)
        reg.fit(x,y)
        print(f'nRidged Coefficients: {reg.coef_}')
    if model == 3:
        reg = linear_model.Lasso(alpha = 0.1)
        reg.fit(x,y)
        print(f'nLasso Coefficients: {reg.coef_}')

    preds = reg.predict(xTest)

    er = []
    for i in range(len(ytest)):
        print( "Actual=", ytest[i], " Preds=", preds[i])
        x = (ytest[i] - preds[i]) **2
        er.append(x)

    variance_value = np.var(er)
    print (f"Variance {round(variance_value, 2)}")

    print(f"Bias: {round(mean_squared_error(ytest,preds), 2)}")

dateset_a = np.array([[4],[5],[6]])
dateset_b = np.array([[8.8],[14],[17]])

# Least Square Coefficients
calculate_bias_variance(dateset_a,dateset_b, 1)
# Ridged Coefficients
calculate_bias_variance(dateset_a,dateset_b, 2)
# Lasso Coefficients
calculate_bias_variance(dateset_a,dateset_b, 3)
Ergebnis:
Die Berücksichtigung von Verzerrung und Varianz ist entscheidend
Bias und Varianz sind zwei Schlüsselkomponenten, die Sie bei der Entwicklung eines guten, genauen Machine-Learning-Modells berücksichtigen müssen.
- Bias erzeugt konsistente Fehler im ML-Modell, das ein einfacheres ML-Modell darstellt, das für eine bestimmte Anforderung nicht geeignet ist.
- Varianz hingegen erzeugt Varianzfehler, die zu falschen Vorhersagen führen und zu Trends oder Datenpunkten führen, die nicht existieren.
Nutzer müssen beide Faktoren bei der Erstellung eines ML-Modells berücksichtigen. Im Allgemeinen ist es Ihr Ziel, die Verzerrung so gering wie möglich zu halten und gleichzeitig akzeptable Varianzen einzuführen. Dies kann entweder durch Erhöhung der Komplexität oder durch Erhöhung des Trainingsdatensatzes erreicht werden. Auf diese ausgewogene Weise können Sie ein akzeptables Machine-Learning-Modell erstellen.
Verwandte Literatur
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.