




Auf einen Blick: Hadoop Analytics bietet ein Framework zum Erstellen von Analysemodellen, das auf Wissen über MapReduce, Statistik und maschinelles Lernen basiert. Es dient als Plattform für Datenmanipulation, wobei Spark aufgrund seiner nativen maschinellen Lernfähigkeiten als schnellere Alternative anerkannt wird.
- Hadoop erleichtert die Erstellung von Analysemodellen durch Manipulation von Datenstrukturen.
- Die Kompetenz in Statistik und maschinellem Lernen ist entscheidend für eine effektive Analyse.
Hadoop Analytics 101
Apache Hadoop allein betreibt keine Analytik. Aber es bietet eine Plattform und Datenstruktur, auf der man Analysemodelle aufbauen kann. Dafür muss man MapReduce-Funktionen verstehen, damit man die Eingabedaten in das von den Analysealgorithmen benötigte Format erstellen und einfügen kann. Das erklären wir hier und betrachten einige Analysefunktionen.
Hadoop war die erste und beliebteste große Datenbank. Produkte, die später kamen, in der Hoffnung, den Erfolg von Hadoop zu nutzen, ließen ihre Produkte damit funktionieren. Dazu gehören Spark, Hadoop, Hbase, Flink und Cassandra. Spark wird jedoch wirklich als Hadoop-Ersatz gesehen. Es hat das, was Hadoop nicht hat, nämlich eine native maschinelle Lernbibliothek, Spark ML. Außerdem arbeitet es viel schneller als Hadoop, da es eine In-Memory-Datenbank ist.
Was Analysepakete betrifft, die nativ mit Hadoop funktionieren – diese sind auf Frink und Mahout beschränkt. Mahout ist auf dem Weg, daher solltest du das nicht verwenden. Deine besten Optionen sind also, Flink entweder mit Hadoop- oder Flink-Tabellen zu verwenden oder die Spark ML (Maschinensprache) Bibliothek mit Daten in Hadoop oder anderswo zu verwenden und die Ergebnisse entweder in Spark oder Hadoop zu speichern.

(Dieser Artikel ist Teil unseres Hadoop-Leitfadens. Nutzen Sie das rechte Menü zur Navigation.)
Analytics definiert
Um Analytics zu verstehen, musst du grundlegende deskriptive Statistik verstehen (die wir unten erklären) sowie lineare Algebra, Matrizen, Vektoren und Polynome, die du im College lernst – zumindest bei denen, die einen naturwissenschaftlichen Abschluss gemacht haben. Ohne jegliches Verständnis davon wirst du nie verstehen, was ein K-Means-Klassifikationsmodell oder sogar lineare Regression bedeuten. Das ist einer der Gründe, warum normale Programmierer nicht immer Data Science betreiben können. Analytics ist Data Science.
Analytics ist die Anwendung von Mathematik, Statistik und künstlicher Intelligenz auf Big Data. Künstliche Intelligenz wird auch als maschinelles Lernen bezeichnet. Dies sind mathematische Funktionen. Es ist wichtig, die logische Begründung hinter jedem Algorithmus zu verstehen, damit Sie die Ergebnisse korrekt interpretieren können. Andernfalls könnten Sie falsche Schlussfolgerungen ziehen,
Analytics erfordert eine verteilte, skalierbare Architektur, da sie Matrizen und lineare Algebra verwendet. Die Multiplikation von sogar zwei großen Matrizen kann den gesamten Speicher einer einzigen Maschine verbrauchen. Daher muss die Aufgabe dafür in kleinere Aufgaben unterteilt werden.
Eine Matrix ist eine Struktur wie:
    [a11, a12, a13,...,a1n
A21, a22, a23, … a2n
…
A i1, ai2, ai3, …, ain]
Diese Matrizen sind Koeffizienten zu einer Formel, von der der Analyst hofft, dass sie ein geschäftliches oder wissenschaftliches Problem löst. Zum Beispiel könnte der optimale Preis für ihr Produkt p = ax + durch + c sein, wobei x und y einige Inputs für Fertigung und Verkauf sind und c eine Konstante ist.
Aber das ist ein kleines Beispiel. Die Menge an Variablen, mit denen der Analyst arbeiten muss, ist in der Regel viel größer. Außerdem muss der Analyst oft mehrere Gleichungen gleichzeitig lösen. Deshalb verwenden wir Matrizen.
Matrizen werden in ML-Algorithmen mit Scala, Python, R, Java, Python und anderen Programmiersprachen gespeist. Diese Objekte können alles sein. Zum Beispiel kann man Strukturen mischen und kombinieren:
    Tuple(a,b,a)

Tuple(int, float, complex number, class Object)

Array (“employees:” “Fred”, “Joe”, “John”, “William)
Um Hadoop für Analysen zu nutzen, musst du wissen, wie man Daten in Hadoop in verschiedene Datenstrukturen umwandelt. Das bedeutet, du musst MapReduce verstehen.
MapReduce
MapReduce ist in zwei Schritte unterteilt: Map und Reduce. (Manche sagen, combine sei ein dritter Schritt, aber eigentlich ist es Teil des Reduce-Schritts.)
Man muss nicht immer sowohl Mapping als auch Reduce machen, besonders wenn man nur einen Satz Eingabedaten in ein Format umwandeln will, das in einen ML-Algorithmus passt. Map läuft über die Werte aus, die man eingibt, und liefert die gleiche Anzahl an Werten zurück, die man eingegeben hat, ändert diese aber in ein neues Ausgabeformat. Die Reduce-Operation ist so konzipiert, dass sie einen Wert zurückgibt. Das ist eine Art Vereinfachung, aber größtenteils wahr. (Reduce kann mehr als eine Ausgabe zurückgeben. Zum Beispiel geschieht das im unten gezeigten Beispielprogramm.)
MapReduce-Beispielprogramm
Hier ist das Word Count-Programm, das direkt von der Apache Hadoop-Website übernommen wurde. Im Folgenden zeigen wir, wie man es ausführt, und erklären, was jeder Abschnitt bedeutet.
Zuerst musst du eine Textdatei erstellen und sie nach Hadoop kopieren. Im Folgenden ist der Inhalt dargestellt:
    hadoop fs -cat /analytics/input.txt

Hello World Bye World
Das Programm nimmt jedes Wort in dieser Zeile und erstellt dann diese Schlüssel->Wert-Abbildungen:
    (Hello, 1)
(World, 1)
(Bye, 1)
(World, 1)
Und dann reduzieren wir sie, indem man jeden Wert nach Schlüssel gruppiert, um diese Schlüssel->Wert-Abbildungen zu erzeugen:
    (Hello, 1)
(World, 2)
(Bye, 1)
Hier ist der Java-Code.
    package com.bmc.hadoop.tutorials;

import java.io.IOException;
import java.util.StringTokenizer;

import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.fs.Path;
import org.apache.hadoop.io.IntWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Job;
import org.apache.hadoop.mapreduce.Mapper;
import org.apache.hadoop.mapreduce.Reducer;
import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;
import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;
public class WordCount {
public static class TokenizerMapper
extends Mapper<object , Text, Text, IntWritable>{
private final static IntWritable one = new IntWritable(1);
Text ist ein gewöhnliches Textfeld, nur dass es von Hadoop serialisiert werden kann.
private Text word = new Text();
Hadoop ruft die Map-Operation für jede Zeile in der Eingabedatei auf. Diese Datei hat nur 1 Zeile, //, teilt die Wörter jedoch mit dem StringTokenizer als ersten Schritt zur Erstellung von Schlüssel->Wert-/Paare auf.
    public void map(Object key, Text value, Context context
 ) throws IOException, InterruptedException {
 StringTokenizer itr = new StringTokenizer(value.toString());
 while (itr.hasMoreTokens()) {
word.set(itr.nextToken());
Dabei wird die Ausgabe als Key>Value-Abbildung (Word, 1) geschrieben.
    context.write(word, one);
      }
    }
  }
Dieser Reduktionscode ist direkt aus dem Hadoop-Quellcode kopiert. Er wird hier kopiert // Sie können ihn also hier lesen. Dieser Reduce schreibt seine Ausgabe als Schlüssel->Wert-Paar (Schlüssel, Ergebnis)
    public static class IntSumReducer
       extends Reducer {
    private IntWritable result = new IntWritable();

    public void reduce(Text key, Iterable values,
                       Context context
                       ) throws IOException, InterruptedException {
      int sum = 0;
      for (IntWritable val : values) {
        sum += val.get();
      }
      result.set(sum);
      context.write(key, result);
    }
  }

  public static void main(String[] args) throws Exception {
    Configuration conf = new Configuration();
    Job job = Job.getInstance(conf, "word count");
    job.setJarByClass(WordCount.class);
Hier geben wir an, welche Klasse für das Abbilden, Kombinieren und Reduzieren von Funktionen verwendet werden soll.
    job.setMapperClass(TokenizerMapper.class);
job.setCombinerClass(IntSumReducer.class);
job.setReducerClass(IntSumReducer.class);
job.setOutputKeyClass(Text.class);
job.setOutputValueClass(IntWritable.class);
FileInputFormat.addInputPath(job, new Path(args[0]));
FileOutputFormat.setOutputPath(job, new Path(args[1]));
System.exit(job.waitForCompletion(true) ? 0 : 1);
  }
}
Um das auszuführen, musst du zuerst den /analytics-Ordner in Hadoop erstellen:
hadoop fs -mkdir /analytics
Führe den Code so aus:
yarn jar /tmp/WordCount.jar com.bmc.hadoop.tutorials.WordCount /analytics/input.txt /analytics/out.txt
Dann überprüfe die Ausgabe. Zuerst benutze hadoop fs -ls /analytics/out.txt, um den Dateinamen zu erhalten, da die Ergebnisse im output.txt-Ordner gespeichert sind
hadoop fs -cat /analytics/out.txt/part-r-00000
Hier ist die resultierende Zählung.
    Bye	1
Hello	1
World	2
Deskriptive Statistiken
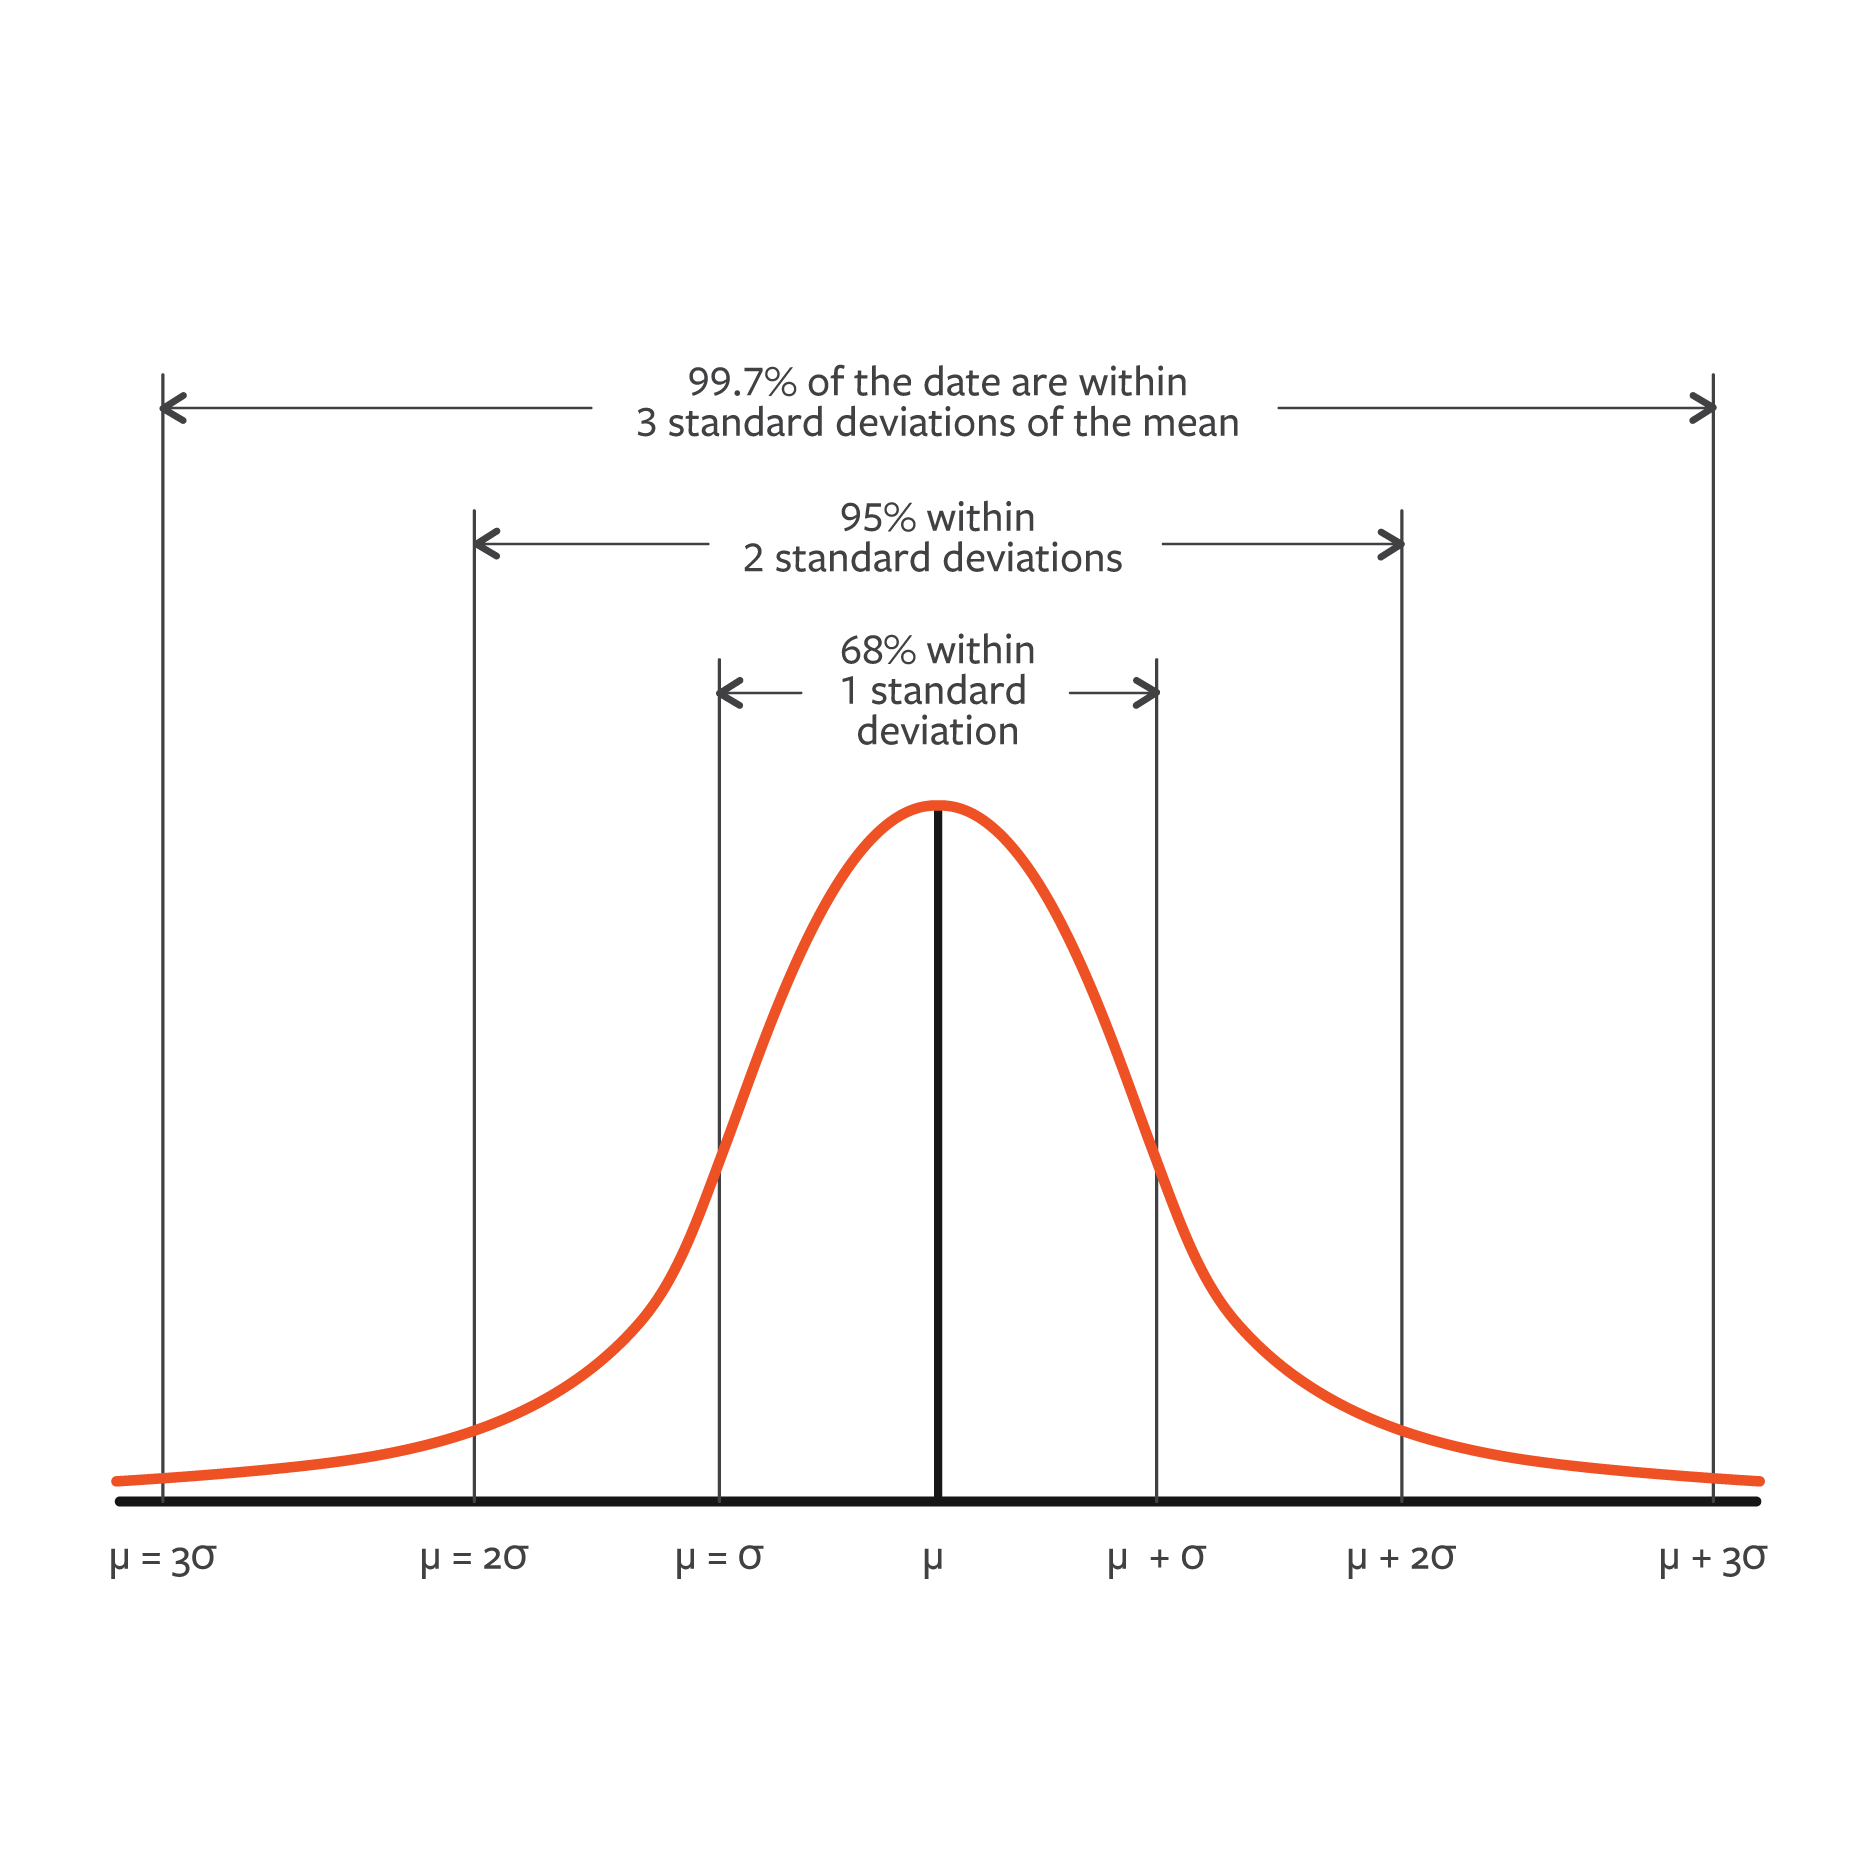
Um diese analytischen Modelle zu verstehen, ist es notwendig, die deskriptive Statistik zu verstehen. Dies ist der Durchschnitt, der Mittelwert (μ), die Varianz (σ2) und Standardabweichung (□) im College oder in der High School gelehrt werden. In der Statistik wird die Normalverteilung verwendet, um die Wahrscheinlichkeit eines Ereignisses zu berechnen. Je höher die Kurve und je näher die Punkte beieinander stehen, desto kleiner die Varianz und damit die Standardabweichung.
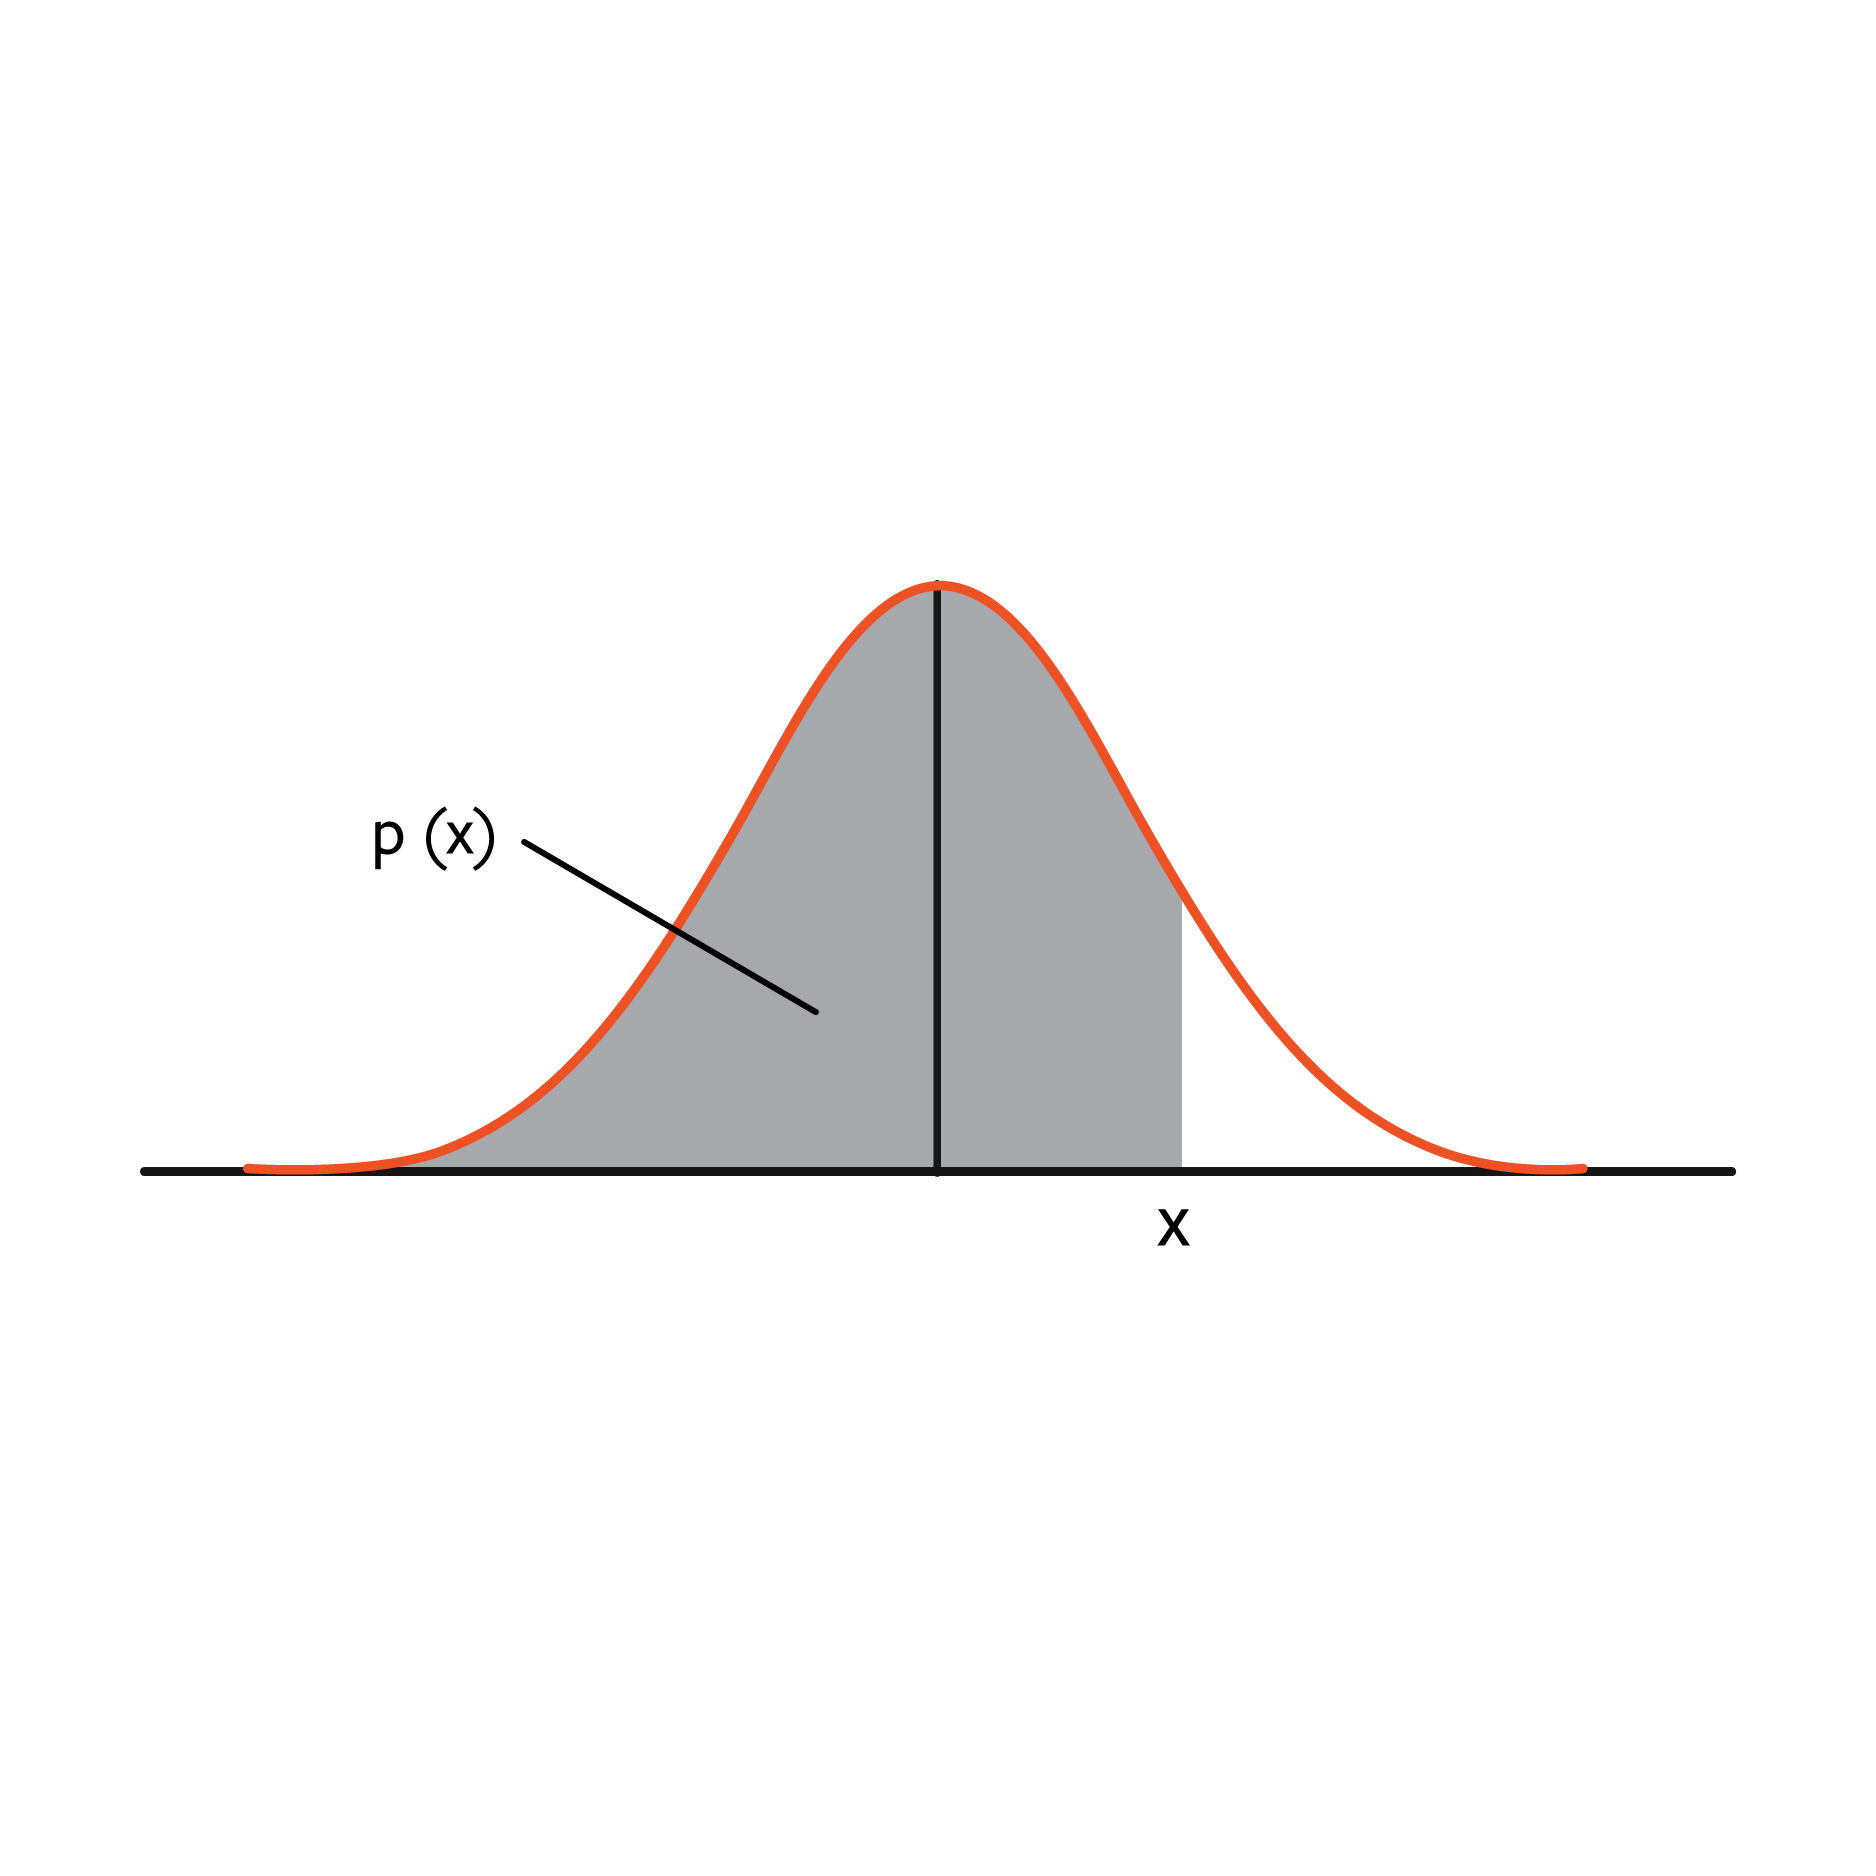
Die Normalkurve ist eine grafische Darstellung der Wahrscheinlichkeit: p(x). Zum Beispiel ist die Wahrscheinlichkeit, dass ein Wert kleiner oder gleich x darüber ist, p(x).
Lineare Regression
Jetzt sprechen wir allgemein darüber, wie einige der Analysealgorithmen funktionieren.
Lineare Regression ist ein prädiktives Modell. Im Bereich maschinelles Lernen ist es das einfachste. Es ist eine gute Idee, es zuerst zu lernen, da das Grundformat und die lineare Beziehung bei komplexeren ML-Algorithmen gleich bleiben.
In ihrer einfachsten Form hat die lineare Regression eine unabhängige Variable x und eine abhängige Variable y=mx +b.
Das können wir so grafisch darstellen:
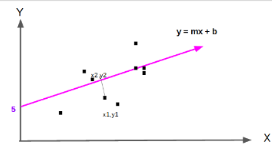
Die Linie y = mx +b ist diejenige, bei der die Entfernung von den Datenpunkten zur violetten Linie am kürzesten ist.
Der Algorithmus zur Berechnung der Leitung in Apache Spark lautet:
org.apache.spark.ml.regression.LinearRegression
Logistische Regression
In einer linearen Regression betrachten wir eine Linie, die am besten zu den Datenpunkten passt. Für die logistische Regression wandeln wir das in eine Wahrscheinlichkeit um. Dieses Ergebnis der logistischen Regression ist einer von zwei Werten (0, 1). Dies ist mit einer Wahrscheinlichkeitsfunktion p(x) verbunden. Konventionell gilt: wenn p(x) 0,5 >, dann logit(p(x))=1 und sonst 0.
Die logistische Regression ist die unten gezeigte kumulative Verteilungsfunktion, wobei e die Konstante e und s die Skalenparameter sind.
1 / (1 + e**-((x -□) /s))
Wenn das seltsam aussieht, keine Sorge, denn weiter unten sehen wir die vertrauten linearen Funktionen, die wir bisher verwendet haben.
Um zu verstehen, dass die logistische Regression die kumulative Verteilung unter der Normalkurve darstellt, betrachtet man den Punkt, an dem x = □ in der Normalkurve liegt. An diesem Punkt x - □ = 0, also 1 / (1 + e**-((x - □) /s)) = 1 / (1 + e**((1 - 1 )/s)) = 1/ (1 + e**0) = 1/ (1 +1) = 1/2 = 0,5. Das ist die schattierte Fläche links von der y-Achse, bei der x = □ Mit anderen Worten: Es besteht eine 50%ige Wahrscheinlichkeit, dass ein Wert kleiner als der Mittelwert ist. Das Diagramm, das zeigt, wird hier erneut gezeigt:

Der logistische Regressionsalgorithmus erfordert eine LabeledPoint-Struktur in Spark ML.
(labels, points)
Diesen haben wir in den LogisticRegressionWithLBFGS-Algorithmus eingefügt. Die Bezeichnungen müssen 1 oder 0 sein. Die Punkte (Merkmale) können eine Sammlung beliebiger Werte sein, wie unten gezeigt.
    (1: {2,3,4})
(0:{4,5,6})
Die Daten, die wir einführen, nennt man das Trainingsset. Mit anderen Worten: Es handelt sich um eine Stichprobe tatsächlicher Daten. Diese stammen aus der vergangenen Geschichte. So kann der Computer die Gleichung finden, die am besten zu den Daten passt. Dann kann er Vorhersagen treffen. Also, wenn:
model = LogisticRegressionWithLBFGS (LabeldPoint of values)
Dann können wir die Vorhersagefunktion verwenden, um die Wahrscheinlichkeit zu berechnen, die 1 oder 0 ist:
model.predict(1,2,3) = 1 or 0.
Quoten
Logistische Regression ist schwer zu verstehen, aber leichter zu verstehen, wenn man sie in Bezug auf Quoten betrachtet. Menschen, die auf Pferderennen und Fußball wetten, verstehen das definitiv.
odds =(probability of successes / probability of failure)
Wenn du einen Würfel wirfst, sind die Chancen (1/7)/(6/7) = 1/6. In der logistischen Regression ist das Ergebnis entweder 0 von 1.So die Chancen sind:
odds (y) = p(y=1)/ p(y=0) = p(y=1)/ (1 - p(y=1))
Logistische Regression ist der Logarithmus der Odds. Denken Sie daran, dass die Wahrscheinlichkeit von einer linearen Funktion wie:
Odds (x) = a1x1 + b1x2 + c1x3 + d
Der Logarithmus davon lautet:
log(Odds (x)) = log(a1x1 + b1x2 + c1x3 + d)
Das machen wir rückgängig, indem wir seitlich auf e erhöhen und die ursprüngliche Quotenformel angeben:
odds(x) = e**(a1x1 + b1x2 + c1x3 + d)
Wenn das schwer zu erkennen ist, betrachten Sie die Situation eines Patienten mit Herzkrankheit. Wir haben eine lineare Formel, die aus jahrelanger Untersuchung abgeleitet wurde. Wir können sagen, dass die Wahrscheinlichkeit, an Herzkrankheiten zu erkranken, in einigen Funktionen von:
(a1 * cholesterol) + (b1 * smoking) + ( c1 + genetic factors) + constant
Das ist eine lineare Gleichung.
Unterstützungsvektormaschinen
Mit Support Vector Machine (SVM) sind wir daran interessiert, einem von zwei möglichen Ergebnissen einen Datensatz zuzuweisen: -1 oder 1. (Wenn Sie denken, das sei dasselbe wie logistische Regression, haben Sie damit recht gerade. Aber es gibt einige nuancierte Unterschiede.)
Wie ist das nützlich? Ein Beispiel ist die Klassifizierung von Krebs in zwei verschiedene Typen basierend auf seinen Merkmalen. Ein weiteres ist die Handschrifterkennung oder Textsentiment-Analyse, also die Frage, ob beispielsweise ein Kundenkommentar positiv oder negativ ist.
Natürlich wäre eine SVM nicht besonders nützlich, wenn wir nur zwischen zwei Ergebnissen a oder b wählen könnten. Aber wir können sie erweitern, um Daten zwischen n möglichen Ergebnissen durch paarweise Vergleiche zu klassifizieren.
Zur Veranschaulichung: Wenn wir die möglichen Ergebnisse a, b, c und d haben, können wir jeden dieser vier Werte in drei Schritten überprüfen. Zuerst betrachten wir paarweise (a,b), dann (a,c), dann (a,d) und so weiter. Oder wir betrachten eins gegen alle, wie in (a, (b,c,d)), (b, (a,c,d)) usw.
Wie bei logistischer und linearer Regression und sogar neuronalen Netzen besteht der grundlegende Ansatz darin, die Gewichte (w) und den Bias (b) zu finden, die diese Formeln korrekt machen mx + b = 1 und mx + b = -1 für die Trainingsmenge x. m und x sind Vektoren und m * x ist das Skalarprodukt m • x.
Zum Beispiel, wenn m (m1,m2,m3,m4,m5) und x (x1,x2,x3,x4,x5) ist, dann ist m •x + b (m1x1 + m2x2 + m3x3 + m4x4 + m5x5) + b.
Für die lineare Regression haben wir den Ansatz mit dem kleinsten Quadratfehler verwendet. Wir SVM machen etwas Ähnliches. Wir finden etwas, das Hyperebene genannt wird. Diese fädelt die Naht und findet eine Ebene oder eine Linie, die alle Datenpunkte trennt, sodass alle Gewichte und Eingabevariablen auf einer oder der anderen Seite der Hyperebene liegen. Das klassifiziert die Daten in eine oder andere Kategorie.
Im zweidimensionalen Raum sieht das Bild wie unten gezeigt aus. Die Gerade m • x + b = 0 ist die Hyperebene. Sie befindet sich auf dem maximalen Abstand zwischen m • x + b = 1 und m • x + b = -1, wodurch die Daten in die Ergebnisse 1 und -1 getrennt werden.
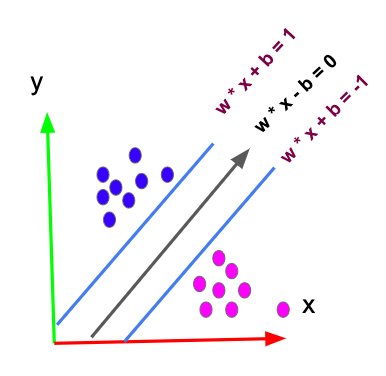
In höheren Dimensionen sehen die Punkte aus wie ein ununterscheidbarer Fleck. Man kann eine gekrümmte Hyperebene nicht leicht erkennen, die diese sauber trennt, also bilden wir diese n-dimensionalen Punkte mit einer Transformationsfunktion namens Kernel auf eine höhere Dimension n+1 ab. Dann sieht es wieder wie ein flacher zweidimensionaler Raum aus, was leicht vorstellbar ist. Dann ziehen wir eine gerade Linie zwischen diesen Punkten. Dann kollabieren wir die Punkte wieder in einen Raum mit n Dimensionen, um unsere Hyperebene zu finden. Fertig.
Klingt das einfach? Vielleicht nicht, aber es bietet einen mechanischen Prozess, um sorgfältig eine Trennlinie zwischen einem Datensatz in mehreren Dimensionen zu weben, um diesen in eine bestimmte Menge zu klassifizieren.
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.