




Auf einen Blick: Hadoop ist ein verteiltes Dateisystem und Batch-Verarbeitungsframework, das eine Master-Slave-Architektur für effizientes Datenmanagement über mehrere Rechner nutzt. Wichtige Komponenten sind Namenode, Datanode und JobTracker, die Fehlertoleranz und Datenverarbeitung ermöglichen.
- Hadoop verwendet MapReduce für die Datenverarbeitung.
- Es unterstützt verschiedene Speicherformate und integriert sich mit Tools wie Apache Spark und Hive.
Überblick
Hadoop ist ein verteiltes Dateisystem und Batch-Verarbeitungssystem zum Ausführen von MapReduce-Jobs. Das bedeutet, es ist dafür konzipiert, Daten in lokalem Speicher über ein Netzwerk von Standardmaschinen zu speichern, also dieselben PCs, die für virtuelle Maschinen in einem Rechenzentrum verwendet werden. MapReduce besteht tatsächlich aus zwei Programmen. Map bedeutet, Elemente wie eine Zeichenkette aus einer CSV-Datei zu nehmen und eine Operation über jede Zeile der Datei auszuführen, zum Beispiel in eine Liste von Feldern aufzuteilen. Diese werden zu (Schlüssel->Wert-)Paare. Reduzieren Sie diese (Schlüssel->Wert-)Paare und führen Sie eine Operation aus, um sie beispielsweise zu einer Zeichenkette zu verketten oder zu summieren wie (Schlüssel->Summe).
Reduzieren kann bei jeder assoziativen Operation funktionieren. Das ist das mathematische Prinzip a + b = b + a. Und es funktioniert auf mehr als nur Zahlen, und jedes Programmierobjekt kann Additions-, Multiplikations- und Subtraktionsmethoden implementieren. (Division ist nicht assoziativ, da 1 /2 <> 2 /1 nicht assoziativ ist). Die assoziierte Eigenschaft ist eine Voraussetzung für ein paralleles Verarbeitungssystem, da Hadoop Elemente aus der Reihenfolge bringt, indem es sie in separate Abschnitte teilt, um daran zu arbeiten.
Hadoop ist darauf ausgelegt, fehlertolerant zu sein. Du sagst ihm, wie oft Daten repliziert werden sollen. Wenn ein Datenknoten dann abstürzt, geht die Daten nicht verloren.
Hadoop verwendet eine Master-Slave-Architektur. Das Grundprinzip seines Designs ist, das Rechnen zu den Daten zu bringen, statt die Daten zur Rechenleistung. Das ergibt Sinn. Es speichert Datendateien, die zu groß sind, um auf einem Server über mehrere Server verteilt zu werden. Wenn es dann Mapping- und Reduce-Operationen ausführt, wird diese weiter aufgeteilt und jeder Server im Knoten kann die Berechnung übernehmen. Jeder Knoten ist also ein Computer und nicht nur ein Festplattenlaufwerk ohne Rechenleistung.

(Dieser Artikel ist Teil unseres Hadoop-Leitfadens. Nutzen Sie das rechte Menü zur Navigation.)
Architekturdiagramm
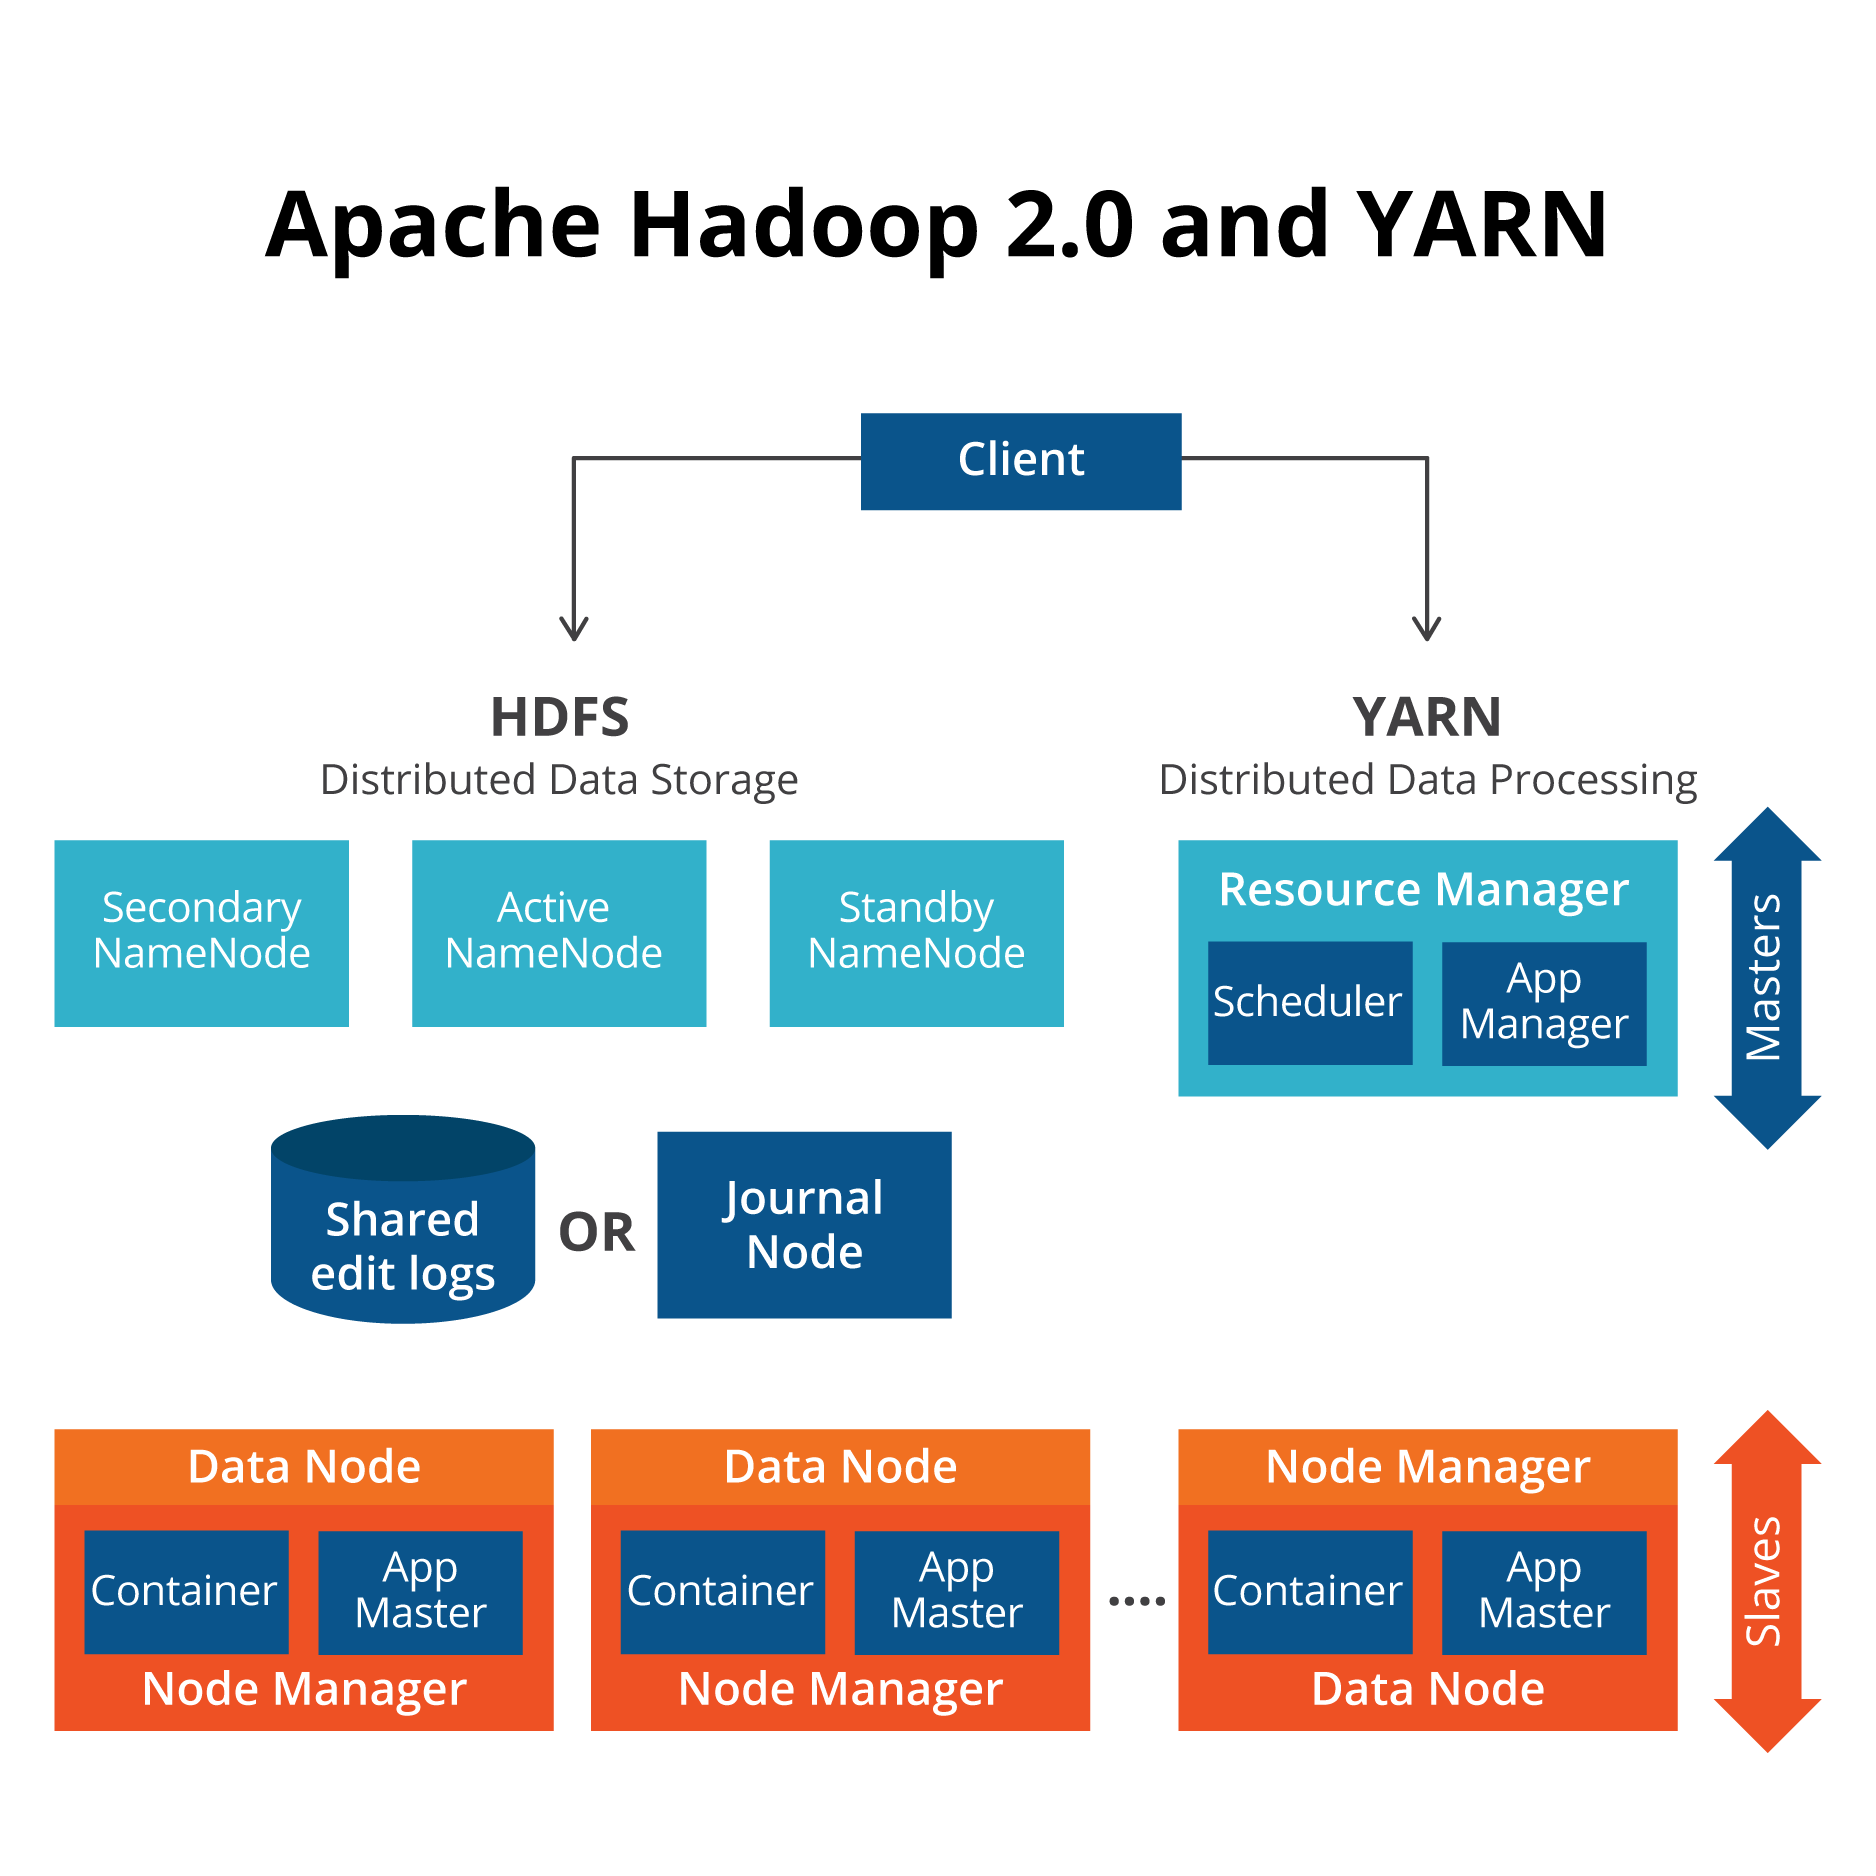
Hier sind die Hauptbestandteile von Hadoop.
- Namenode – steuert den Betrieb der Datenjobs.
- Datanode – dies schreibt Daten in Blöcken auf lokalen Speicher. Und es repliziert Datenblöcke auf andere Datanodes. DataNodes sind ebenfalls rack-aware. Man möchte nicht alle Daten auf dasselbe Serverrack replizieren, da ein Ausfall dort dazu führen würde, dass man alle Daten verliert.
- SecondaryNameNode – dieser übernimmt, wenn der primäre Namenode offline geht.
- JobTracker – sendet MapReduce-Jobs an Knoten im Cluster.
- TaskTracker – akzeptiert Aufgaben aus dem Job Tracker.
- Yarn – führt die Yarn-Komponenten ResourceManager und NodeManager aus. Dies ist ein Ressourcenmanager, der auch als eigenständige Komponente ausgeführt werden kann, um anderen Anwendungen die Möglichkeit zu geben, in einer verteilten Architektur zu laufen. Zum Beispiel kannst du Apache Spark mit Yarn verwenden. Du könntest auch dein eigenes Programm schreiben, das Yarn verwendet. Aber das ist kompliziert.
- Client-Anwendung – das ist das Programm, das Sie geschrieben haben, oder ein anderer Client wie Apache Pig. Apache Pig ist eine einfach zu bedienende Shell, die SQL-ähnliche Befehle nimmt, sie in Java MapReduce-Programme übersetzt und auf Hadoop ausführt.
- Application Master – führt Shell-Befehle in einem Container wie von Yarn vorgeschrieben aus.
Cluster versus Einzelknoten
Wenn man Hadoop zum ersten Mal installiert, zum Beispiel um es zu lernen, läuft es in einem einzelnen Knoten. In der Produktion würde man es jedoch so einrichten, dass es in einem Cluster-Knoten läuft, also Datenknoten auf verschiedenen Maschinen zuweisen. Das gesamte Set von Maschinen wird Cluster genannt. Ein Hadoop-Cluster kann enorm skalieren, um Petabytes an Daten zu speichern.
Den Status Ihres Clusters können Sie hier sehen
http://localhost:50070/dfshealth.html#tab-datanode.
MapReduce-Beispiel: Berechnen e
Hier zeigen wir ein Beispiel für ein Java MapReduce-Programm, das wir gegen einen Hadoop-Cluster ausführen. Wir berechnen den Wert der mathematischen Konstante e.
e ist die Summe der unendlichen Reihe Σ i = 0 zu n (1 + 1 /n!). Das ist:
e = 1 + (1 / (1 * 2)) + (1 / (1 * 2 * 3*) + (1 / (1 * 2* 3* 4)) + …
Je weiter wir n berechnen, desto näher kommen wir dem wahren Wert von e.
Wir listen also diese 9 Werte von n in einer Textdatei in.txt auf:
    in.txt
1
2
3
4
5
6
7
8
9
In der Abbildungsoperation erstellen wir diese Schlüsselwertpaare:
    (x, 1!)
(x, 2!)
…
(x,9!)
Wir verwenden die Zeichenkette x als Schlüssel für jeden Schlüssel, sodass der Reduce-Schritt diese auf eine Taste (x,e) zusammenfügt.
Dann summieren wir die laufende Summe Σ i = (1 /n!) und addieren im Reduktionsschritt 1 zum Wert, um unsere Näherung von e zu erhalten.
Zuerst kopieren wir die Datei in.txt ins Hadoop-Dateisystem. (Zuerst musst du dann formatieren und dann ein Verzeichnis erstellen).
hadoop fs -put /home/walker/Downloads/in.txt /data/in.txt
Nachfolgend ist der Quellcode für CalculateE.java: Um es zu kompilieren und auszuführen, müssen Sie:
    export  HADOOP_CLASSPATH=${JAVA_HOME}/lib/tools.jar
hadoop com.sun.tools.javac.Main CalculateE.java
jar cf e.jar CalculateE*.class
hadoop jar e.jar CalculateE /data/in.txt /data/out.txt
Code:
    import java.io.IOException;
import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.fs.Path;
import org.apache.hadoop.io.DoubleWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Job;
import org.apache.hadoop.mapreduce.Mapper;
import org.apache.hadoop.mapreduce.Reducer;
import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;
import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;

public class CalculateE {

public static class Factorial extends Mapper {public void map(Object key, Text value, Context context) throws IOException, InterruptedException {int n = Integer.parseInt(value.toString());double f = factorial(n);double x = (1 / f);DoubleWritable y = new DoubleWritable(x);Text ky = new Text("x");System.out.println("key=" + ky + " y= " + y);context.write(ky, y);}}public static int factorial(int f) {return ((f == 0) ? 1 : f * factorial(f - 1)); }  public static class DoubleSumReducer extends Reducer {		private DoubleWritable x = new DoubleWritable(0);		public void reduce(Text key, Iterable values, Context context)throws IOException, InterruptedException {			double sum = 0;			for (DoubleWritable val : values) {				sum += val.get();                                System.out.println("val=" + val + " sum=" + sum);			}                        sum += 1;			System.out.println("key=" + key.toString() + " e = " + sum);			x.set(sum);			context.write(key, x);		}	}	public static void main(String[] args) throws Exception {				Path inputPath = new Path(args[0]);	    Path outputPath = new Path(args[1]);	    		Configuration conf = new Configuration();		Job job = Job.getInstance(conf, "calculate e");				FileInputFormat.setInputPaths(job, inputPath);	    FileOutputFormat.setOutputPath(job, outputPath);	   	    		job.setJarByClass(CalculateE.class);		job.setMapperClass(Factorial.class);		job.setReducerClass(DoubleSumReducer.class);		job.setOutputKeyClass(Text.class);		job.setOutputValueClass(DoubleWritable.class);	 		System.exit(job.waitForCompletion(true) ? 0 : 1);	}}
Wenn das Programm läuft, speichert es die Ergebnisse im Ordner /data/out.txt in der Datei part-r-00000. Du kannst die Endergebnisse so sehen:
    hadoop fs -ls /data/out.txt
hadoop fs -cat /data/out.txt/part-r-00000
 x 2.7182815255731922
Das ist ziemlich nah am tatsächlichen Wert von e, 2,71828. Um das Programm beim Schreiben zu debuggen, kannst du dir das Stdout-Logbuch ansehen. Oder du kannst den Job History Tracking-Server aktivieren und ihn im Browser ansehen: Die Stdout-Ausgabe enthält viele Hadoop-Nachrichten, einschließlich unserer Debug-Ausdrucke:
    key=x y= 1.0
key=x y= 0.5
key=x y= 0.16666666666666666
key=x y= 0.041666666666666664
key=x y= 0.008333333333333333
key=x y= 0.001388888888888889
key=x y= 1.984126984126984E-4
key=x y= 2.48015873015873E-5
key=x y= 2.7557319223985893E-6


val=2.7557319223985893E-6 sum=2.7557319223985893E-6
val=2.48015873015873E-5 sum=2.755731922398589E-5
val=1.984126984126984E-4 sum=2.259700176366843E-4
val=0.001388888888888889 sum=0.0016148589065255732
val=0.008333333333333333 sum=0.009948192239858907
val=0.041666666666666664 sum=0.05161485890652557
val=0.16666666666666666 sum=0.21828152557319222
val=0.5 sum=0.7182815255731922
val=1.0 sum=1.7182815255731922
key=x e = 2.7182815255731922
Hadoop-Speichermechanismen
Hadoop kann seine Daten in mehreren Dateiformaten speichern, hauptsächlich damit es mit verschiedenen Cloud-Anbietern und Produkten zusammenarbeiten kann. Hier sind einige:
    Hadoop—these have the hdfs:// file prefix in their name.For example hdfs://masterServer:9000/folder/file.txt is a valid file name.

S3—Amazon S3.  The file prefix is s3n://

file—file:// causes Hadoop to use any other distributed file system.
Hadoop unterstützt außerdem Windows Azure Storage Blobs (WASB), MapR, FTP und andere.
Schreiben in Datendateien
Hadoop ist keine Datenbank. Das bedeutet, es gibt keinen zufälligen Zugriff auf Daten und man kann keine Zeilen in Tabellen oder Zeilen mitten in Dateien einfügen. Stattdessen kann Hadoop nur Dateien schreiben und löschen, obwohl man sie abschneiden und anhängen kann, was jedoch nicht üblich ist.
Hadoop als Plattform für andere Produkte
Es gibt viele Systeme, die Hadoop benutzerfreundlicher machen und eine SQL-ähnliche Oberfläche bieten. Zum Beispiel Pig, Hive und HBase.
Viele andere Produkte nutzen Hadoop ebenfalls als Teil ihrer Infrastruktur. Dazu gehören Pig, Hive, HBase, Phoenix, Spark, ZooKeeper, Cloudera Impala, Flume, Apache, Oozie und Storm.
Und dann gibt es viele Produkte, die Hadoop-Connectoren geschrieben haben, damit ihr Produkt Daten lesen und schreiben kann, wie ElasticSearch.
Hadoop-Prozesse und Eigenschaften
Gib jps ein, um zu sehen, welche Prozesse laufen. Es sollten NameNode und SecondaryNameNode auf dem Master und dem Backup-Master aufgeführt werden. DataNodes laufen auf den Datenknoten.
Wenn du es zum ersten Mal installierst, musst du keine Konfiguration ändern. Aber es gibt viele Konfigurationsmöglichkeiten, um es abzustimmen und einen Cluster einzurichten. Hier sind ein paar.
| Prozess oder Eigenschaft | Häufig verwendeter Port | Konfigurationsdatei | Name des Eigenschaftskonfigurationselements |
| NameNode | 50070 | hdfs-site.xml | dfs.namenode.http-address |
| SekundärNameNode | 5090 | hdfs-site.xml | dfs.namenode.secondary.http-address |
| fs.defaultFS | 9000 | core-site.xml | Die URL, die für den Dateizugriff verwendet wird, wie hdfs://master:9000. |
| dfs.namenode.name.dir | file:///usr/local/hadoop |
| dfs.datanode.name.dir | file:///usr/local/hadoop |
| dfs.replication | Setze den Replikationswert. 3 wird häufig verwendet. Das bedeutet, es macht 3 Kopien von jedem geschriebenen Daten. |
Hadoop-Analysen
Hadoop betreibt keine Analytik, entgegen der landläufigen Meinung, was bedeutet, dass es keine Clustering, lineare Regression, lineare Algebra, k-Means-Clustering, Entscheidungsbäume und andere Data-Science-Tools gibt, die in Hadoop integriert sind. Stattdessen werden die Extraktions- und Transformationsschritte der Analyse nur durchgeführt.
Für Data-Science-Anaytics muss man Spark ML (Machine Learning Library) oder scikit-learn für Python oder Cran R für die R-Sprache verwenden. Aber nur das erste läuft auf einer verteilten Architektur. Für die anderen beiden müsste man die Eingabedaten in eine einzelne Datei auf einem einzigen Server kopieren. Es gibt die Mahout-Analyseplattform, aber die Autoren sagen, dass sie sie nicht mehr entwickeln werden.
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.