




Auf einen Blick: Die Anomalieerkennung ist entscheidend, um Ausreißer in Datensätzen zu identifizieren und die Systemüberwachung sowie die Ursachenanalyse zu verbessern. Maschinelles Lernen verbessert die Erkennungseffizienz, erfordert jedoch strukturierte Daten, große Datensätze und qualifizierte Ingenieure.
- Anwendungen umfassen Betrugserkennung, Eindringlingserkennung und Gesundheitsüberwachung.
- Herausforderungen betreffen Datenanforderungen und den Bedarf an Ingenieurtalenten.
Die Anomalieerkennung spielt eine entscheidende Rolle in robusten verteilten Softwaresystemen. Anomalieerkennung kann:
- Verbesserung der Kommunikation rund um das Systemverhalten
- Verbesserung der Ursachenanalyse
- Reduziere Bedrohungen für das Software-Ökosystem
Die traditionelle Anomalieerkennung erfolgt manuell. Maschinelle Lernmethoden verbessern jedoch den Erfolg von Anomaliedetektoren. Natürlich gibt es bei allem maschinellen Lernen auch neue Kosten – Datenbedarf und Ingenieurtalente.
In diesem Artikel werfen wir einen Blick auf:
Was ist Anomalieerkennung?
Anomalieerkennung ist jeder Prozess, der die Ausreißer eines Datensatzes findet; jene Elemente, die nicht dazugehören. Diese Anomalien könnten auf ungewöhnlichen Netzwerkverkehr hinweisen, einen defekten Sensor aufdecken oder einfach Daten zur Reinigung identifizieren, bevor sie analysiert werden.
In der heutigen Welt verteilter Systeme ist das Management und die Überwachung der Systemleistung eine lästige Pflicht – wenn auch eine notwendige Pflicht. Mit Hunderten oder Tausenden von Gegenständen, die man beobachten kann, kann die Anomalieerkennung helfen, Fehler aufzuzeigen, was die Ursachenanalyse verbessert und schnell technischen Support für das Problem bekommt. Die Anomalieerkennung hilft bei der Überwachung der Ursache von Chaos Engineering , indem sie Ausreißer erkennt und die verantwortlichen Parteien zum Handeln informiert.
In der Unternehmens-IT wird die Anomalieerkennung häufig verwendet für:
- Datenbereinigung
- Eindringlingserkennung
- Betrugserkennung
- Systemgesundheitsüberwachung
- Ereigniserkennung in Sensornetzwerken
- Ökosystemstörungen
Die Herausforderung der Anomalieerkennung
Aber selbst in diesen oben genannten gängigen Anwendungsfällen gibt es einige Nachteile bei der Anomalieerkennung. Aus einem Konferenzpapier von Bram Steenwinckel:
"Anomalie Detection (AD)-Systeme werden entweder manuell von Experten gebaut, die Schwellenwerte für Daten festlegen, oder automatisch durch das Lernen aus den verfügbaren Daten mittels Machine Learning (ML)."
Es ist mühsam, ein Anomalie-Erkennungssystem von Hand zu bauen. Dies erfordert Fachwissen und – noch schwieriger zugänglich – Voraussicht.
Für ein Ökosystem, in dem sich die Daten im Laufe der Zeit ändern, wie bei Betrug, kann das keine gute Lösung sein. Eine Mauer zu bauen, um Menschen fernzuhalten, funktioniert, bis sie einen Weg finden, drüber, darunter oder um sie herumzugehen. Wenn das System ausfällt, müssen die Bauarbeiter zurückkehren und manuell weitere Sicherheitsmaßnahmen hinzufügen.
Unter der Brille der Chaos-Technik ist manuelles Erstellen von Anomalieerkennung schlecht, weil sie ein System schafft, das sich nicht anpassen kann (oder kostspielig und unzeitig ist).
Anomalieerkennung mit ML
Maschinelles Lernen dient dem Zweck des Ingenieurs, ein AD-System zu schaffen, das:
- Funktioniert besser
- Ist anpassungsfähig und pünktlich
- Verarbeitet große Datensätze
Trotz dieser Vorteile kann die Anomalieerkennung mit maschinellem Lernen nur unter bestimmten Bedingungen funktionieren.
Unstrukturierte Daten: Was ist die Anomalie?
Die Anwendung von maschinellem Lernen auf die Anomalieerkennung erfordert ein gutes Verständnis des Problems, insbesondere in Situationen mit unstrukturierten Daten.
Strukturierte Daten implizieren bereits ein Verständnis des Problembereichs. Anomalie-Daten sind oft leicht zu erkennen, weil sie bestimmte Regeln brechen. Wenn ein Sensor niemals 300 Grad Fahrenheit anzeigen sollte und die Daten zeigen, dass der Sensor 300 Grad Fahrenheit zeigt – dann liegt deine Anomalie. Es gibt eine klare Schwelle, die durchbrochen wurde.
Die Betrugserkennung in den frühen Anomalie-Algorithmen konnte funktionieren, weil die Daten Bedeutung mit sich trugen. Die Daten waren strukturiert, das heißt, die Menschen hatten bereits eine interpretierbare Einstellung zur Datenerhebung erstellt. Ihre Daten hatten eine Bedeutung, sodass es möglich war, zufällige Bäume zu erstellen und nach Betrug zu suchen.
Dunkle und unstrukturierte Daten, wie Bilder als Pixelfolge kodiert oder als Zeichenfolge kodierte Sprache, tragen jedoch wenig Interpretation und machen die alten Algorithmen nutzlos... bis die Daten strukturiert werden. Struktur findet sich in den letzten Schichten eines konvolutionellen neuronalen Netzwerks (CNN) oder in einer Vielzahl von Sortieralgorithmen.
Große Datensätze werden benötigt
Zweitens ist ein großer Datensatz notwendig. Ein Grundprinzip jedes guten Machine-Learning-Modells ist, dass Datensätze benötigt werden. Wie im Recht gilt: Wenn es keine Daten zur Untermauerung des Anspruchs gibt, kann der Anspruch nicht vor Gericht geltend gemacht werden.
Maschinelles Lernen benötigt Datensätze; Schlussfolgerungen können nur gezogen werden, wenn Vorhersagen validiert werden können. Die Anomalieerkennung profitiert von noch größeren Datenmengen, da angenommen wird, dass Anomalien selten sind.
Knappheit kann nur bei vorhandener Fülle auftreten.
Benötigtes Talent
Drittens sind Machine-Learning-Ingenieure notwendig. Offensichtlich, aber manchmal übersehen. Maschinelles Lernen ist keine Ware, und wie bei Autowerkstätten sind nicht alle Ingenieure gleich.
Es erfordert Können und Handwerk, ein gutes Machine-Learning-Modell zu erstellen. Die Kosten für einen Anomaliedetektor von 95 % auf 98 % Erkennung könnten einige Jahre und einige ML-Einstellungen betragen.
Anomalieerkennung in drei Einstellungen
In einem Vortrag im Jahr 2018 erklären Dr. Thomas Dietterich und sein Team an der Oregon State University, wie die Anomalieerkennung unter drei verschiedenen Bedingungen erfolgt. Sie hängen alle vom Zustand der Daten ab. Die drei Einstellungen sind:
- Überwacht
- Sauber
- Unbeaufsichtigt

Schauen wir uns jedes Setting genauer an.
1. Überwacht
Trainingsdaten sind mit "nominal" oder "Anomalie" gekennzeichnet.
Das überwachte Setting ist das ideale Setting. Es ist der Fall, in dem ein Datensatz ordentlich für den Data Scientist vorbereitet wird, wobei alle Datenpunkte als Anomalie oder Nominal gekennzeichnet sind. In diesem Fall sind alle anomalen Punkte im Voraus bekannt. Das bedeutet, es gibt Datenmengen, die anomal sind, aber nicht als solche identifiziert werden, damit das Modell trainieren kann.
Beliebte ML-Algorithmen für strukturierte Daten:
- Unterstützung des Vektor-Maschinellen Lernens
- k-nächstgelegene Nachbarn (KNN)
- Bayessche Netzwerke
- Entscheidungsbäume
2. Sauber
In der Clean-Einstellung gelten alle Daten als "nominal", und sie sind mit "Anomalie"-Punkten kontaminiert.
Die saubere Einstellung ist ein weniger idealer Fall, bei dem dem Modellierer eine Menge Daten präsentiert werden, die sauber und vollständig sind, aber alle Daten als nominale Datenpunkte gelten. Dann liegt es am Modellierer, die Anomalien innerhalb dieses Datensatzes zu erkennen.
3. Unbeaufsichtigt
In unüberwachten Umgebungen sind die Trainingsdaten unbeschriftet und bestehen aus "nominalen" und "Anomalie"-Punkten.
Der schwierigste Fall, und der immer größer werdende Fall für Modellierer in den immer größer werdenden Mengen an dunklen Daten, ist die unüberwachte Instanz. Die Datensätze im unüberwachten Fall haben ihre Teile nicht als nominal oder anomal gekennzeichnet. Es gibt keine Grundwahrheit, von der aus das Ergebnis erwartet werden kann. Das Modell muss dem Modellierer zeigen, was anomal und was nominal ist.
"Die häufigsten Aufgaben im unüberwachten Lernen sind Clustering, Repräsentationslernen und Dichteschätzung. In all diesen Fällen möchten wir die inhärente Struktur unserer Daten erlernen, ohne explizit angegebene Labels zu verwenden." - Devin Soni
Im Unsupervised-Umfeld werden verschiedene Werkzeuge benötigt, um Ordnung in den unstrukturierten Daten zu schaffen. Bei unstrukturierten Daten besteht das Hauptziel darin, aus den Daten Cluster zu erstellen und dann die wenigen Gruppen zu finden, die nicht dazugehören. Tatsächlich sind alle Anomalieerkennungsalgorithmen eine Form der approximativen Dichteschätzung.
Beliebte ML-Algorithmen für unstrukturierte Daten sind:
- Selbstorganisierende Karten (SOM)
- K-bedeutet
- C-bedeutet
- Erwartungsmaximierungs-Metaalgorithmus (EM)
- Adaptive Resonanztheorie (ART)
- Ein-Klassen-Unterstützungsvektormaschine
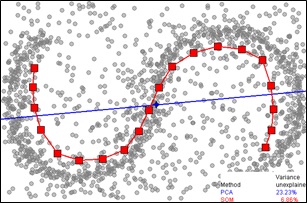

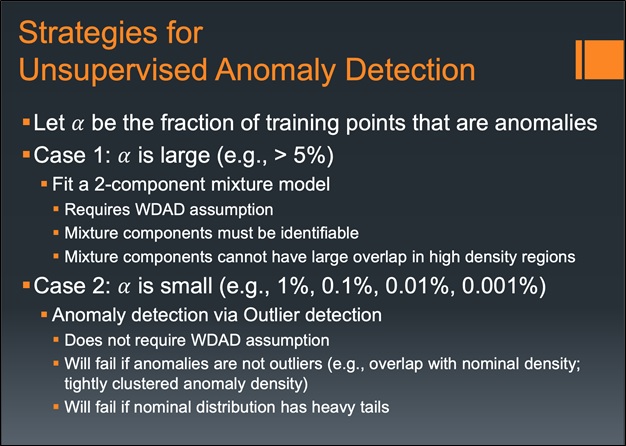
Aus den Vorlesungsfolien von Dr. Dietterich werden die Strategien zur Anomalieerkennung im Fall der unbeaufsichtigten Umgebung in zwei Fälle unterteilt:
Wo maschinelles Lernen nicht geeignet ist, gehören zu den wichtigsten Nicht-ML-Erkennungsalgorithmen:
- IFOR: Isolationswald (Liu et al., 2008)
- LODA: Leichter Online-Detektor von Anomalien (Pevny, 2016)
Benchmarking von Anomalieerkennung
Ingenieure nutzen Benchmarks, um die Leistung eines Algorithmus mit der eines anderen vergleichen zu können. Verschiedene Arten von Modellen verwenden unterschiedliche Benchmarking-Datensätze:
- Die Bildklassifizierung umfasst MNIST und IMAGENET.
- Sprachmodellierung verwendet Penn TreeBank und Wiki Text-2.
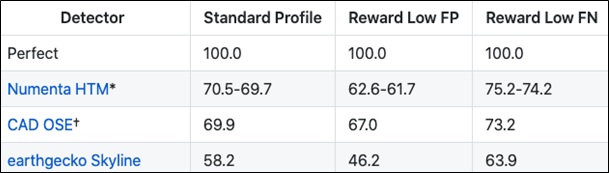
Bei der Anomalieerkennung ist noch kein einzelner Datensatz zum Standard geworden. Das liegt zum Teil daran, wie vielfältig die Anwendungen sein können. Allerdings entwickelt sich eine Einheit zu einer kontinuierlichen Präsenz – der Numenta Anomaly Benchmark. Aus dem GitHub-Repo:
"NAB ist ein neuartiger Benchmark zur Bewertung von Algorithmen zur Anomalieerkennung in Streaming-Echtzeitanwendungen. Er besteht aus über 50 beschrifteten Echtzeit- und künstlichen Zeitreihendatendateien sowie einem neuartigen Bewertungsmechanismus, der für Echtzeitanwendungen entwickelt wurde."
Bisher erfasst der leistungsfähigste Anomaliedetektor-Algorithmus in den NAB-Benchmarks 70 % der Anomalien aus einem Echtzeitdatensatz.
Fang mit der ML-Anomalieerkennung an
Wenn du mit der Erkennung von maschinellen Anomalien anfangen möchtest, empfehle ich, hier zu starten:
- Entwicklung eines Echtzeit-Anomalie-Erkennungssystems für Zeitreihen bei Pinterest (Softwareingenieure Kevin Chen und Brian Overstreet)
- Anomalie-Erkennungstechniken in Python (Christopher Jose)
- Ausreißer- und Anomalie-Erkennung mit scikit-lernendem maschinellem Lernen (Walker Rowe)
Zusätzliche Ressourcen
Für mehr zu diesem und verwandten Themen entdecken Sie diese Ressourcen:
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.