




Auf einen Blick: Die durchschnittliche Erkennungszeit (MTTD) misst die durchschnittliche Zeit vom Beginn eines IT-Vorfalls bis zu seiner Entdeckung, was für die Aufrechterhaltung der Servicequalität und die Abschwächung der Umsatzauswirkungen unerlässlich ist. Eine genaue Nachverfolgung ermöglicht ein proaktives Vorfallmanagement.
- MTTD hilft, die Zuverlässigkeit und Verfügbarkeit des Systems zu bewerten.
- Die Verbesserung der MTTD erfordert strategische Investitionen und Automatisierung.
DevOps-Teams verlassen sich auf datenbasierte Erkenntnisse, um eine effiziente SDLC-Pipeline aufzubauen und aufrechtzuerhalten. Eine Vielzahl von IT-Incident-Kennzahlen unterstützt die Bewertung der Leistungsbewertung Ihrer IT-Infrastruktur insgesamt sowie einzelner IT-Vorfälle. Die Herausforderung für ITOps und Service Desks besteht darin, die aussagekräftigsten Kennzahlen zu identifizieren, insbesondere solche, die dazu beitragen, die Auswirkungen von IT-Vorfällen auf Endnutzer zu minimieren.
In diesem Artikel werden wir die durchschnittliche Erkennungszeit besprechen, eine Kennzahl, die darauf abzielt, IT-Vorfälle schneller zu finden, unabhängig von der Problemlösungskapazität und Leistung. Sowohl DevOps- als auch ITOps-Teams können MTTD nutzen.
[Helix-Video]
Was ist die durchschnittliche Zeit zum Detektieren?
Ein Key Performance Indicator (KPI) im IT-Incident-Management, die mittlere Detektionszeit (MTTD), bezeichnet die durchschnittliche Zeit zwischen Beginn eines IT-Vorfalls und dessen Entdeckung.
MTTD kann mathematisch mit folgender Formel berechnet werden:
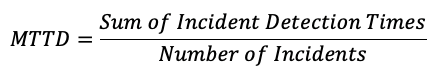
Obwohl die mathematische Berechnung des MTTD einfach ist, erfordert sie eine genaue Kenntnis des Startzeitpunkts von IT-Vorfällen. Dies kann eine Auswertung historischer KPI-Daten der Infrastruktur erfordern. Nehmen Sie den Durchschnitt der Zeit zwischen Beginn und tatsächlicher Entdeckung mehrerer IT-Vorfälle. Diese Berechnungen können über verschiedene Zeiträume (z. B. täglich, wöchentlich oder vierteljährlich) durchgeführt werden, um Veränderungen in der MTTD-Leistung im Laufe der Zeit zu bewerten.
Die mittlere Erkennungszeit ist eine von mehreren Kennzahlen, die die Systemzuverlässigkeit und -verfügbarkeit unterstützen
MTTD für effektives Vorfallmanagement
Incident Management läuft nicht nur darauf hinaus, Vorfälle zu erkennen, sondern auch zu bestimmen, welche Vorfälle die Endnutzerleistung oder Ihren Einnahmestrom beeinflussen können. Vorfälle, die Leistung und Umsatz nicht beeinflussen, werden wahrscheinlich priorisiert. MTTD kann Ihnen helfen, beides zu verfolgen:
- Zahlreiche Infrastruktur-Kennzahlen, nicht nur einzige, sollten umsatzbeeinflussende Vorfälle melden. Das ist zwar gut, aber es gibt einige Schwächen: Das enorme Volumen an Log-Metriken, die bei jeder IT generiert werden, sorgt für viel Lärm. IT-Teams mit traditionellen ITSM-Tools können Schwierigkeiten haben, IT-Probleme proaktiv zu erkennen.
- Endnutzer helfen außerdem, IT-Vorfälle zu identifizieren, wenn sie leistungsbeeinträchtigende Vorfälle wie Serviceausfälle, Unterbrechungen oder andere Leistungsprobleme melden. Wenn die zugrunde liegenden Vorfälle Ihrem Team nicht bekannt oder sichtbar sind, könnten die Art und der Umfang der Endnutzerberichte auf eine Unstimmigkeit bei Ihren Incident-Management-Methoden und/oder auf eine Unzulänglichkeit Ihrer Überwachungslösungen hinweisen, um die Probleme proaktiv zu erkennen.
Die Behandlung dieser beiden MTTD-bezogenen Probleme kann sowohl technischer als auch strategischer Natur sein:
- DevOps muss möglicherweise neu bewerten, wie sie die Impact Tolerance eines Vorfalls definieren.
- Die IT muss möglicherweise in technologische Lösungen investieren, die granulare Einblicke mithilfe der Logmetrik-Big Data liefern können. Einige ITSM-Ereignistools sind in der Lage, Informationen aus mehreren Quellen von IT-Vorfallinformationen zu korrelieren, um versteckte Muster von Erkenntnissen zu erkennen.
Diese aufzudecken kann Ihnen helfen, einen bedeutenden IT-Vorfall zu identifizieren, bevor er Auswirkungen auf Leistung und Umsatz hat. Sobald ein IT-Vorfall als höher priorisiert anerkannt wird, können DevOps-Teams vorgefertigte Problemlösungsprotokolle verfolgen, um Probleme basierend auf Priorität und Auswirkungen auf die SDLC-Leistung zu adressieren.
MTTD-Best Practices
Die Verbesserung von MTTD bietet DevOps-Teams die Möglichkeit, IT-Vorfälle zu beheben, bevor die Auswirkungen Endnutzer erreichen oder den SDLC-Prozess verlangsamen. Selbst bei Vorfällen mit niedrigerer Priorität, die möglicherweise nicht sofort gelöst werden müssen, kann ITOps genaue vorfallbezogene Informationen sammeln.
Viele Servicestörungen lösen eine Kette von IT-Vorfällen über mehrere Infrastrukturknoten hinweg aus. An jedem Knoten stellt ein einzelner IT-Vorfall möglicherweise kein ausreichendes Risiko dar, um Korrekturmaßnahmen zu rechtfertigen. Durch die Verbesserung des MTTD kann ITOps jedoch seinen Aufgabenbereich zur Bewertung von IT-Vorfällen und Infrastrukturknoten auf eine proaktive Maßnahme ausweiten, die großflächige Servicestörungen reduziert.
In diesem Zusammenhang – proaktivem, präventivem Vorfallmanagement – können die folgenden MTTD-Best Practices nützlich sein:
Strategie entwickeln
Wie jede einzelne Kennzahl liefert MTTD allein kein ausreichendes Bild der Infrastrukturleistung. Ebenso sind nicht alle Vorfälle gleich: Sie müssen bei der Bewertung der MTTD-Leistung die unterschiedlichen Arten von IT-Vorfällen berücksichtigen. Strategische Maßnahmen ermöglichen es DevOps-Teams, besser in Ressourcen zu investieren, die die Überwachung und das Management von Vorfällen verbessern.
In einer DevOps-Umgebung erfordert die Strategie auch einen schlanken Ansatz für ITSM. Anstatt einem festen Satz von Protokollen zur Berücksichtigung des IT-Incident-Managements im Vergleich zu MTTD zu folgen, benötigen Sie eine breitere ITSM-Perspektive. ITOps muss die Ursache und Wirkung von IT-Veränderungen beobachten , bevor verbesserte oder gelockerte MTTD-Ziele im gesamten Spektrum der IT-Vorfälle gezielt werden.
Verleihe deinem Volk die Fähigkeit
Trotz der komplexen Natur der IT-Infrastruktur und der Komplexität von IT-Incident-Monitoring-Lösungen spielt menschliches Versagen weiterhin eine bedeutende Rolle bei ungenauen MTTD-Kennzahlen.
- Angesichts der umfangreichen Erkenntnisse aus den Überwachungstools benötigt Ihr ITOps-Team ein tiefes Verständnis der Technologien und ITSM-Prozesse, die mit der Vielzahl der auftretenden IT-Vorfälle zusammenhängen. Ihr ITSM-Tool kann Vorfälle markieren – oft überwältigend –, daher sollte Ihr ITOps-Team mit dem menschlichen Wissen, der Expertise und den Fähigkeiten ausgestattet sein, um die richtigen Informationen über Vorfälle zu gewinnen, die zu erheblichen Servicestörungen führen können.
- Menschliche Fehler oder mangelndes Bewusstsein können ebenfalls zu ungenauen oder unzureichenden MTTD-Informationen führen. Gerade wenn Messungen manuell durchgeführt werden müssen, muss Ihr Servicetechniker sorgfältig handeln, um die notwendigen Messungen regelmäßig zu protokollieren.
- Schließlich muss Ihr IT-Servicedesk auch proaktiv auf Vorfallberichte und Beschwerden der Endnutzer reagieren. Ein optimierter Servicedesk-Prozess ist für ITOps entscheidend, um IT-Vorfälle von Endnutzern zu entdecken, die sonst unter dem Radar geblieben wären.
Automatisieren und kodifizieren
Obwohl Automatisierung das Herzstück von DevOps ist, sollte sie ebenso kritisch auf den IT-Incident-Management-Prozess angewendet werden, insbesondere im Hinblick auf Vorfallerkennung und -lösung. (Wenn Automatisierung nicht möglich oder in der Lage ist, volle Transparenz zu bieten, muss Ihr ITOps-Team einen systematischen Ansatz zur Vorfallerkennung entwickeln und anwenden.)
Die Klarheit, die sich aus der Automatisierung der Vorfallerkennung und -verwaltung ergibt, bietet mehrere Vorteile:
- Das erleichtert ITOps, geeignete ITSM-Prozesse zu kodifizieren.
- Hilft ITOps, eine genaue Dokumentation der Vorfallprotokolle und der bei verschiedenen Wertschwellenwerten der KPI-Kennzahlen durchgeführten Maßnahmen zu führen.
- Fördert flexible, agile Umgebungen. Wenn die Prozesse zur Problemerkennung und -lösung nicht mit den strategischen ITSM- und DevOps-Zielen übereinstimmen, kann ITOps die codierten Parameter einfach anpassen.
- Sorgt für eine konsistente Datenerfassung und -berichterstattung, selbst wenn sich die Anforderungen der IT-Teams ändern.
Zuerst Erkennung, dann Auflösung
Der nächste Schritt zur Verbesserung des ITSM-Prozesses ist die Lösung von Problemen mit der Service Desk Mean Time to Solving (MTTR).
BMC Blogs bietet viele Ressourcen zu IT-Kennzahlen. Durchstöbern Sie unser Enterprise IT Glossar oder sehen Sie sich diese Artikel an:
- Mittlere Zeit zur Auflösung (MTTR) als Service-Desk-Metrik
- MTBF vs. MTTF vs. MTTR: Definition von Fehlern für IT- und Rechenzentrumsumgebungen
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.