




Auf einen Blick: Die N-Tier-Architektur organisiert Software in mehrere verschiedene Schichten und verbessert Skalierbarkeit, Sicherheit und Widerstandsfähigkeit. Sie trennt Präsentation, Geschäftslogik und Datenebenen in verschiedenen Umgebungen, optimiert die Leistung und ermöglicht gleichzeitig flexible Wartung.
- Verbessert Skalierbarkeit und Sicherheit durch Tier-Trennung.
- Ermöglicht eine verbesserte Flexibilität bei der Katastrophenwiederherstellung und Wartung.
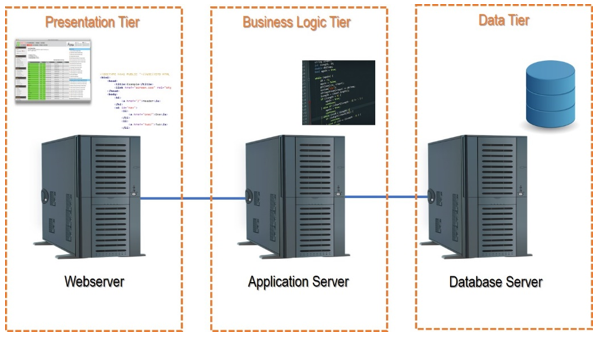
Als Business Computing vom Großrechner auf erschwinglichere Standardmaschinen wechselte, wählte man einen bestimmten Computer aus und "beförderte" ihn zum Serverstatus, indem man eine Datenbank-Engine, eine Art Codeinterpreter plus Compiler installierte und Softwarecode entwickelte, der dann das benötigte Softwarewerkzeug erstellte. Das bedeutete, dass die Benutzeroberflächensoftware (UI), das Programm selbst und die Datenbank auf derselben Plattform (Betriebssystem und Computer) liefen. Es dauerte nicht lange, bis die IT-Branche erkannte, dass Dinge wie unterschiedliche Patch-Zeitfenster von Betriebssystem- und Datenbankengine-Herstellern, wiederkehrende häufige Vorfälle oder sogar die Notwendigkeit, Komponenten zu aktualisieren/aufzurüsten, dringend behoben werden mussten, indem Verarbeitungs- und Datenbankebenen physisch und logisch getrennt wurden. So begannen die Nutzung von Tier-2-Architekturlösungen . Als das Internet in den 1990er Jahren populär wurde, brachte es eine Revolution in Bezug auf eine leistungsfähigere und leistungsfähigere Benutzeroberfläche mit sich, die jedoch einen spezifischen Webserver erforderte. Dies ermöglichte weitgehend die Verbreitung der Tier-3-Architektur , bei der die UI-Komponente vom Kerncomputing und der Datenbank getrennt war. Die untenstehende Grafik zeigt, wie sich dies im Web abspielt:
Was ist N-Tier-Architektur?
Die N-Tier- (oder Multi-Tier-) Architektur bezeichnet Software, deren mehrere Schichten von unterschiedlichen IT-Umgebungen (Tiers) unter einer Client-Server-Logik gerendert werden. Die Benutzeroberfläche (Präsentationsebene) läuft in einer separaten Umgebung als die "Berechnung" (Business Logic Tier), die wiederum ebenfalls in einer eigenen Umgebung von der Datenbank-Engine und den Instanzen (Data Tier) läuft. Diese unterschiedlichen Umgebungen (Tiers) umfassen typischerweise verschiedene Server, Rechenzentrumsnetzwerke und oft Geografien. Bevor wir weiter gehen, ist es wichtig, den Unterschied zwischen "Tier" und "Layer" zu klären. Eine Schicht ist eine Logikkomponente innerhalb einer Softwaresuite, die eine bestimmte Funktionalität erfüllt, während eine Tier die logische und Hardwareplattform ist, auf der diese Schicht läuft. Meistens ist es sinnvoll, die oben genannten Tiers zu trennen, um weitere Architekturflexibilität, Synergie, Sicherheit und Effizienz zu erreichen. Betrachten Sie Amazon.com als Beispiel:
- Amazon muss von überall, jederzeit und auf jeder Plattform (PC; Tablet; Smartphone) zugänglich sein, daher gibt es allein auf der Präsentationsstufe tatsächlich mehrere Stufen mit unterschiedlichen "Varianten" (Windows, iOS, Android).
- Die Business Logic Tier selbst umfasst nicht nur Server, die über mehrere Geografien verteilt sind und Daten verarbeiten, sondern auch automatisierte Eingaben von Lagern und Logistikkomponenten (Tiers), die Daten selbst verarbeiten (verschiedene Softwareschichten), um Informationen an die Amazon Business Logic Tier zu übertragen (also auch mehrere Tiers).
- Schließlich wird die Data Tier nicht nur repliziert und verteilt, sondern auch in verschiedene Ebenen von Dateninstanzen (Schichten) in separaten Servern (Tiers) aufgeteilt.
Ein detailliertes Beispiel der N-Tier-Architektur
Schauen wir uns ein konkretes Beispiel aus der Automobilindustrie an, das Logistiksoftware betrifft, die darauf abzielt, die Montagelinie des Herstellers mit Sekundenbruchteilen aktuellen Informationen über den Lieferstatus der Teile zu versorgen und daher mit Daten aus folgenden Quellen versorgt werden muss:
- Der Werksboden (Fließband) – sind die Teile angekommen oder nicht
- Drei Drittanbieter-Teilezulieferfirmen – waren die hergestellten Teile
- Logistiklagerhäuser – sind die Teile im Lager verlassen oder angekommen
- LKWs auf der Straße – wo sind sie, und transportieren welche Teile
- Logistik-"Kontrollraum" – wo sich jeder und alles befindet
- Produktionsvorausplanung der Fabrik – welche Teile benötigen wir wann, um optimierte Produktionszyklen zu erreichen
Um dies zu erreichen, ist ein System erforderlich, das Folgendes ermöglicht:
- Sammeln Sie ständig Informationen aus verschiedenen verschiedenen Quellen (intern und extern/remote) über den Status.
- Anschließend werden sie verarbeitet und wertvolle Statusinformationen zurückgegeben, die Entscheidungsträgern ein genaues, durchsetzungsfähiges Bewusstsein darüber ermöglichen, wie Fortschritte bei der Produktionsprognose erzielt werden, sodass diese Maßnahmen ergreifen können, um potenzielle Risiken der Nichteinhaltung zu minimieren.
- Erlauben Sie dem Vorausplanungsteam, Produktionsaufträge für die folgenden Tage zu erteilen, um dem festgelegten Produktionsplan zu entsprechen.
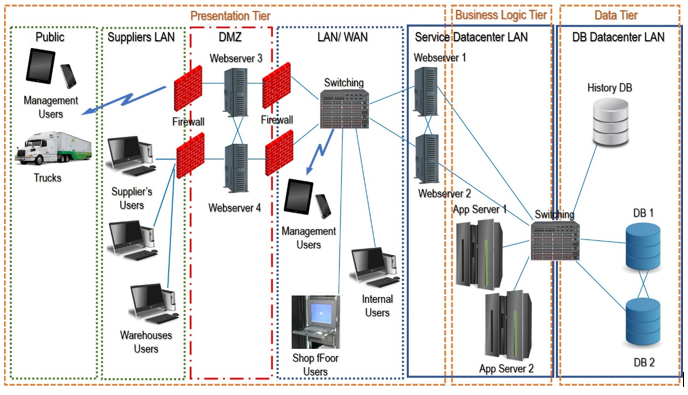
Nachfolgend ist die Systemarchitektur für die notwendigen Softwarestufen aufgeführt:
Präsentationsstufe
Die Präsentationsebene muss mehrere Arten von Benutzeroberflächenprotokollen und -plattformen abdecken, insbesondere:
- Die internen Nutzer des Autoherstellers, sowohl aus dem Logistikkontrollraum als auch aus den Produktionsplanungsbereichen, wo Nutzer Änderungen an Geschäftsregeln und Prozessen vornehmen können. Dies erfordert eine robuste, sichere Benutzeroberfläche (wie eine Desktop-Client-Anwendung); zusätzlich müssen Schlüsselanwender auf der Werkstatt Teile abfragen und einchecken, sobald sie ankommen. Dies würde von einer Client-Service-Softwareschicht auf einer Maschine laufen, die physisch im Netzwerk des Herstellers liegt und von der gesamten LAN/WAN-Infrastruktur bedient wird (was Redundanz, zusätzliche Sicherheit und Geschwindigkeit gewährleistet).
- Die Drittanbieter und Logistiklager-Nutzer befinden sich auf den IT-Landschaften von Drittanbietern und haben daher keinen Zugriff auf das LAN oder WAN des Herstellers. Daher wäre die geeignetste, sicherste und schnellste Lösung die Entwicklung einer webbasierten Client-Service-Softwareschicht, die auf einen Webserver-Cluster zurückgreift und einen Maschinencluster im Rechenzentrum des Herstellers und einen weiteren in der DMZ (wo autorisierte Anbieter über starke Authentifizierungsprotokolle zugreifen können). Beide Cluster-Knoten (intern und DMZ) sollten in unterschiedlichen Regionen installiert werden, um Redundanz und hohe Verfügbarkeit zu gewährleisten.
- Die Fahrzeuge müssten mit automatisierten I/O-Clients ausgestattet sein, die die GPS-Koordinaten und die Listen-ID des Materials über einen öffentlichen mobilen Webdatendienst über Webserver auf der DMZ und zwei ISPs aus verschiedenen Ländern übertragen, um Redundanz und hohe Verfügbarkeit zu gewährleisten.
- Einige spezielle Nutzer, wie Bereichsleiter und Werksleiter, müssten Benachrichtigungen und Nachrichten erhalten, um das System unter einer Management-Reporting-Perspektive über zentralisierte Webserver im Netzwerk des Herstellers (zwei Regionen zur Redundanzsicherung) sowie unterwegs über die ISPs zu erreichen.
Geschäftslogik-Schicht
Die Business Logic Tier würde aus mehreren Ebenen von Anwendungsserver-Clustern bestehen, die von mehreren Rechenzentren in verschiedenen Regionen verteilt sind, wobei eine Produktionsschicht auf einem Server läuft und eine Qualitäts-/Testschicht auf einem anderen Server in jedem Rechenzentrum läuft.
Datenschicht
Die Datenschicht besteht aus einem aktiven Datenbankserver-Cluster mit mehreren Knoten (Servern), die jeweils ihre Schicht ausführen, die von zwei Rechenzentren in verschiedenen Regionen verteilt sind, sowie einer historischen Daten-/Schnellwiederherstellungsstufe an einem weiteren geografischen Standort. Dieses Beispiel setzt voraus, dass die Organisation für die gesamte Infrastruktur verantwortlich ist – eine cloudbasierte Architektur mit virtualisierten Umgebungen würde der gesamten Lösung noch mehr Flexibilität, Widerstandsfähigkeit und "Tiers" sowie "Layers" bieten.
Vorteile der N-Tier-Architektur
- Skalierbarkeit – Mehrere getrennte Komponenten in der Architektur ermöglichen eine einfache Skalierbarkeit, indem eine oder mehrere dieser einzelnen Komponenten aufgerüstet werden. Wenn beispielsweise die Zahl der öffentlichen Clients wächst, kann es erforderlich sein, den Webservice durch Hinzufügen neuer Kapazitäten zur Bewältigung der Client-Nachfrage zu teilen, was mehr Webserver auf der Präsentationsebene bedeutet; ein weiteres Beispiel wäre ein Online-Projekt, das sein Produktportfolio erweitert; in diesem Fall liegt der Bedarf an Wachstum höchstwahrscheinlich im Data Tier.
- Erweiterte Sicherheit – Eine Architektur, die in mehreren Stufen verteilt ist, ermöglicht es, diese in unterschiedliche Sicherheitszonen (sowohl logische als auch geografische) zu platzieren, um sicherzustellen, dass jede Komponente entsprechend ihrer zentralen geschäftlichen Kritikalitätsstufe geschützt ist. Im dargestellten Beispiel haben die Webserver, obwohl sie sich in einer firewall-geschützten DMZ befinden, einen geringeren Bedarf an Sicherheitsabdeckung als Anwendungsserver oder Datenbankserver, auf denen alle kritischen Kerndaten verarbeitet werden oder sich befinden.
- Resilienz und Redundanz – Kritische Komponenten können leicht in Stufen aufgeteilt werden, die gruppiert und geografisch getrennt sind, um ein Failover zu gewährleisten, was ein widerstandsfähigeres System bedeutet.
- Wartungsflexibilität – Wie bei der Skalierbarkeit ermöglicht die Definition von Stufen präzise Wartungsmaßnahmen, die keine unerwünschten Kollateraleffekte verursachen. Das bedeutet, dass Wartungsplanung weniger Abhängigkeiten von Drittanbietern aufweist.
- Disaster Recovery – Eine N-Tier-Architektur ermöglicht es einzelnen Komponenten, im Falle einer teilweisen Serviceunterbrechung wiederherzustellen, egal ob schwerwiegend oder nicht, und ermöglicht so kürzere Service-Wiederherstellungszeiten. Bei robusten, redundanten, gut verteilten Systemen (wie solche, die Google, Amazon, PayPal usw. unterstützen) werden die Wiederherstellungsaktivitäten von Endnutzern aufgrund der vorhandenen Redundanz gar nicht bemerkt.
- Entwicklerfreundliche Umgebung – Da die mehreren Programmierschichten in verschiedene Stufen unterteilt sind, können sich Entwickler auf ihre individuellen Aufgaben konzentrieren, ohne Ressourcen teilen oder potenzielle Kollateralauswirkungen auf die Aufgaben/Bereiche des jeweils anderen berücksichtigen zu müssen. Dies ist die Art von Architektur, die auch Frameworks und Programmierkulturen wie DevOps und Agile/Lean stärkt.
Nachteile der N-Tier-Architektur
- Leistung – Es scheint ein Paradoxon zu sein, dass die Aufteilung mehrerer Komponenten zur Verbesserung von Effizienz und Leistung das Risiko einer geringeren Leistung mit sich bringen kann. Dieses Risiko betrifft im Grunde Komponenten oder Dienste vonDrittanbietern . Da die Architektur über unterschiedliche Geografien und Stufen verteilt ist, wird das gesamte System stark vom I/O-Fluss abhängig. Innerhalb eines geschlossenen Netzwerks (ein LAN/WAN) ist das kritische Element die gesamte Verkabelungs-, Switching- und Routing-Infrastruktur, während bei der Nutzung cloudbasierter Infrastruktur das Thema zusätzlich aus mehreren ISPs besteht, deren individuelle Kommunikationsinfrastruktur in Bezug auf die Leistung möglicherweise nicht synchron ist.
- Höhere CAPEX und OPEX – die Hinzufügung von Komponenten zur Architektur erfordert zusätzliche Anfangsinvestitionen, ein laufendes Wartungsbudget sowie Support-Services. Dies ist besonders besorgniserregend, wenn man nicht auf cloudbasierte Dienste angewiesen ist.
Wie N-Tier in die Cloud übergegangen ist
In den letzten Jahrzehnten sind IT-Systeme zu einer der Säulen unserer globalen Wirtschaft geworden, und Schlüsselfaktoren wie Sicherheit, hohe Verfügbarkeit und Flexibilität haben die meisten Unternehmen dazu veranlasst, ihre geschäftsbezogenen IT-Kernsysteme auf eine N-Tier-Architektur umzustellen. Was war also das Problem? OPEX und CAPEX! Die Anzahl der Tiers und Softwareschichten innerhalb einer geografisch verteilten Architektur zu multiplizieren, um sicherzustellen, dass die oben genannten Schlüsselfaktoren sichergestellt werden, war für die meisten Unternehmen nicht kosteneffizient, aber dann ... reagierte der Markt mit einem robusten Cloud-Computing-Angebot. Unternehmen wie IBM oder AWS (Amazon Web Services) schufen IT-Landschaften für groß angelegte IT-Anlagen, und Unternehmen konnten nun schrittweise auf diese Cloud-Landschaften migrieren, ohne nur eine Gebühr zu zahlen, die nur einen kleinen Prozentsatz der Kosten für die Implementierung und Wartung eigener N-Tier-Architektur-basierter IT-Umgebungen darstellte.
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.