




Auf einen Blick: Neuronale Netze ahmen Gehirnfunktionen nach, um Daten zu verarbeiten und Entscheidungen zu treffen, indem sie Gewichte anpassen, um den Verlust während des Trainings zu reduzieren. Sie sind besonders gut in Aufgaben wie Handschrift und Gesichtserkennung.
- Neuronale Netzwerke nutzen Perzeptrone, um hohe Genauigkeit mit binären Eingaben zu erreichen.
- Das Training beinhaltet die Minimierung der Abnehmfunktion durch Gewichtsanpassungen.
Wir wollen maschinelles Lernen auf einer tieferen Ebene erforschen, indem wir neuronale Netzwerke diskutieren. Das werden wir tun, indem wir erklären, wie man TensorFlow nutzen kann, um Handschrift zu erkennen. Dafür müssen wir jedoch zuerst verstehen, was neuronale Netze sind.
Wir beginnen unsere Diskussion basierend auf unserem Wissen über lineare Modelle und ziehen einige Einführungsmaterialien aus diesem Buch von Michael Nielsen. Es wird von TensorFlow empfohlen .
Was sind neuronale Netze?
Um unsere Diskussion darüber zu beginnen, wie man TensorFlow zur Arbeit mit neuronalen Netzen nutzen kann, müssen wir zunächst erläutern, was neuronale Netze eigentlich sind.
Denken Sie an das lineare Regressionsproblem, das wir hier schon mehrfach betrachtet haben. Wir haben das Konzept einer Verlustfunktion. Ein neuronales Netzwerk konzentriert sich auf die richtige Antwort auf ein Problem, indem es die Verlustfunktion minimiert.
Angenommen, wir haben diese einfache lineare Gleichung: y = mx + b. Dies sagt einen Wert von y voraus, gegebene Werte von x.
Prädiktive Modelle sind nicht immer zu 100 % korrekt. Das Maß dafür, wie falsch es ist, ist der Verlust. Das Ziel des maschinellen Lernens ist es, ein Trainingsset zu verwenden, um die Verlustfunktion zu minimieren. Das gilt für lineare Regression, neuronale Netze und andere ML-Algorithmen.
Angenommen, m = 2, x = 3 und b = 2. Dann gilt unser vorhergesagter Wert von y = 2 * 3 + 2 = 8. Aber unser tatsächlich beobachteter Wert ist 10. Der Verlust beträgt also 10 – 8 = 2.
Was sind Perzeptrons?
In einem neuronalen Netz haben wir dasselbe Grundprinzip, nur dass die Eingaben binär und die Ausgaben binär sind. Die Objekte, die die Berechnungen durchführen, sind Perzeptrons. Sie passen sich an, um die Verlustfunktion zu minimieren, bis das Modell sehr genau ist. Zum Beispiel können wir die Handschriftenanalyse zu 99 % genau erreichen.
Neuronale Netzwerke sind so konzipiert, dass sie genauso funktionieren wie das menschliche Gehirn. Im Fall der Handschrift oder Gesichtserkennung trifft das Gehirn sehr schnell einige Entscheidungen. Zum Beispiel kann das Gehirn bei Gesichtserkennung mit "Es ist weiblich oder männlich?" beginnen. Ist es schwarz oder weiß? Ist es alt oder jung? Gibt es eine Narbe?" und so weiter.
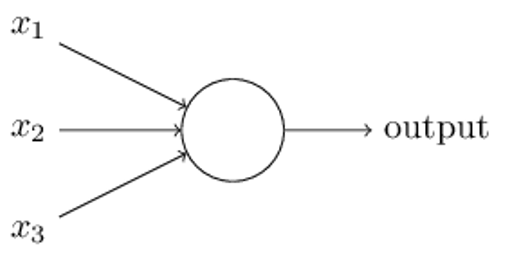
Michael Nielsen beschreibt dies in seinem Buch wie im untenstehenden Diagramm. Alle diese Eingaben (x1, x2, x3) werden in ein Perzeptron eingespeist. Dieses trifft dann eine Ja-oder-Nein-Entscheidung und gibt sie an das nächste Perzeptron für die nächste Entscheidung weiter. Dieser Prozess wiederholt sich bis zum finalen Perzeptron. Dann wissen wir, was die Handschrift ist oder wessen Gesicht wir sehen.
Lassen Sie uns das mit einem kleinen Beispiel veranschaulichen. Dieses Thema ist komplex, daher werden wir hier das erste Konzept präsentieren und im nächsten Beitrag noch einen Schritt weiter gehen.
Wie gesagt, ist ein Perzeptron ein Objekt, das binäre Eingaben nimmt und eine binäre Ausgabe ausgibt. Es verwendet eine gewichtete Summe und eine Schwellewert, um zu entscheiden, ob das Ergebnis ja (1) oder nein (0) sein soll.
Angenommen, du möchtest nach Frankreich gehen, aber nur, wenn:
- x1 -> Das Flugticket kostet weniger als 1.000 Dollar.
- x2 -> Deine Freundin oder dein Freund kann mitkommen.
Du stellst diese Entscheidung mit diesem einfachen Vektor möglicher Eingaben dar:
(1,0), (0,1), (1,1) und (0,0).
Im ersten Fall (1,0) beträgt das Ticket 1.000 > und deine Freundin oder dein Freund kann nicht mitkommen.
Du gibst jedem dieser beiden Berechnungen ein gewisses Gewicht. Zum Beispiel, wenn du ein Budget hast und die Kosten wichtig sind, gib dem Gewicht w1=4. Und ob dein Partner gehen darf oder nicht, ist nicht so wichtig. Gib ihm also ein Gewicht von w2=3.
Sie haben also diese Funktion für Go to France:
(x1 * w1) + (x2 * w2) = (x1 * 4) + (x2 * 3) > eine Schwelle, b, sagen wir, 4.
Wir verschieben b auf die andere Seite und schreiben:
Wenn (x1 * 4) + (x2 * 3) -4 > 0 dann nach Frankreich gehen (d. h. Perceptron sagt 1)-
Dann füge Vektoren in die Gleichung ein. Offensichtlich, wenn das Ticket 1.000 $ > und deine Freundin nicht mitfahren kann (0,0), dann machst du die Reise nicht, denn
(0 * 3) + (0 * 4) – 4 ist offensichtlich < 0.
Wenn das Ticket günstig ist, du aber alleine fährst, dann geh trotzdem:
(1 * 4) + (0 * 3) – 4 = 0, was nicht größer als 0 ist.
Handschrifterkennung mit neuronalen Netzwerken
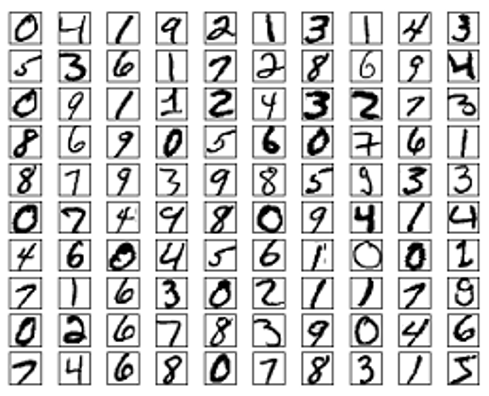
Handschrift und Gesichtserkennung mit neuronalen Netzen bewirken dasselbe, das heißt, sie treffen eine Reihe von binären Entscheidungen. Das liegt daran, dass jedes Bild in sein kleinstes Objekt, den Pixel, zerlegt werden kann. Im Fall der Handschrift, wie unten gezeigt, ist jedes Pixel entweder schwarz (1) oder weiß (also leer oder 0).
Bilderkennung mit neuronalen Netzwerken
Wir haben bereits das Konzept der Perzeptronen eingeführt, die Eingaben aus einfachen linearen Gleichungen nehmen und 1 (wahr) oder 0 (falsch) ausgeben. Sie sind die linke Seite des neuronalen Netzwerks.
Aber wie Michael Nielsen in seinem Buch erklärt, sind Perzeptrone für Aufgaben wie Bilderkennung nicht geeignet, weil kleine Änderungen der Gewichte und Verzerrungen große Veränderungen des Outputs verursachen. Schließlich ist ein Übergang von 0 zu 1 eine große Veränderung. Es wäre besser, zum Beispiel von 0,6 auf 0,65 zu gehen.
Angenommen, wir haben ein einfaches neuronales Netzwerk mit zwei Eingabevariablen x1 und x2 und einer Verzerrung von 3 mit Gewichten von -2 und -3. Die Gleichung dafür lautet:
Wenn -2×1 + -3×2 + 3 < 0, dann gilt 1 (wahr), ansonsten 0 (falsch).
(Das ist zwar nicht ganz die richtige Art, das in der Algebra auszudrücken, aber es ist nah genug dran. Das Ziel ist hier, die Mathematik auf ein Minimum zu beschränken, um sie verständlicher zu machen. Michaels Arbeit ist für Menschen ohne mathematischen Hintergrund schwer verständlich.)
Maschinelles Lernen passt die Gewichte und Verzerrungen an, bis die resultierende Formel den korrekten Wert am genauesten berechnet. Erinnere dich aus dem letzten Beitrag, dass dies dasselbe ist wie zu sagen, dass die Anpassung von Gewichten und Verspannungen die Verlustfunktion auf ihr Minimum reduziert. Die meisten ML-Probleme funktionieren so. Zum Beispiel lineare Regression.
Wie vermeiden wir also die große Änderung, von 0 auf 1 zu gehen, die unser Modell durcheinanderbringen würde? Wir erlauben Eingabe- und Ausgabezahlen zwischen 0 und 1 statt nur 0 oder 1.
Am einfachsten ist es, die Gleichung in die Zahl 1 zu unterteilen, indem man eine ähnliche Formel verwendet wie bei der logistischen Regression. Und dann übernehmen wir die Konvention, dass, wenn der endgültige Ausgabewert des neuronalen Netzes eine Schwelle hat, sagen wir 0,5, daraus schließen können, dass das Ergebnis 1 ist.
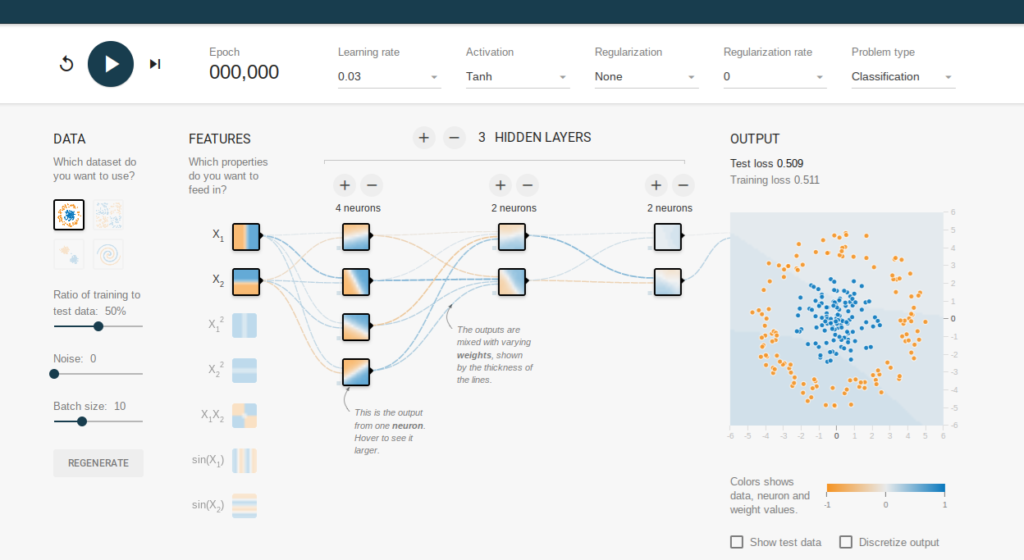
Aber ist das nicht nur eine umständliche Methode, etwas zu berechnen, das entweder zu 0 oder 1 führt? Nein. Denn in einem neuronalen Netzwerk gibt es nicht nur die Anfangswerte und die resultierende Ausgabe. In der Mitte gibt es Zwischenschritte, sogenannte versteckte Schichten. Diese müssen nicht auf 0 oder 1 ausgewertet werden.
(Du kannst mit einem neuronalen Netzwerk experimentieren, um versteckte Ebenen mit diesem Online-Tool hinzuzufügen oder zu entfernen.)
Zur Veranschaulichung: Sei z=x1w1 + x2w2 + b die obige Funktion. Dann erzeugen wir eine modifizierte Wahrnehmung, die als Sigma-Neuronfunktion (δ) bezeichnet wird, wie diese.

Nun stellen wir fest, dass die Werte von x1 und x2 in der Funktion z keine ganzen Zahlen sein müssen. Sie können jeden Wert zwischen 0 und 1 haben, wodurch die Funktion des Sigmoidneurons δ zwischen 0 und 1 variiert.
Denk daran, dass exp, die Konstante e = 2,714. Auf eine negative Potenz zu erhöhen ist dasselbe wie die Division in 1, also exp(-z) = 1 / exp(z).
Wenn der Wert von z groß ist, dann ist exp(-z) klein (nahe an null). Denn 1 geteilt durch etwas Großes ist klein. In diesem Fall ist die Funktion des Sigmoid-Neurons nahe bei 1. Umgekehrt, wenn z klein ist, ist 1/(1 + exp(-z) nahe bei 0. Aber bei Werten, die weder groß noch klein sind, variiert δ nicht stark.
Training zu neuronalen Netzwerken
Mit künstlicher Intelligenz trainieren wir das neuronale Netz, indem wir die Gewichte x1, x2, x3, ... , xn und die Verspannung b variieren. Das heißt, wir variieren die Eingaben, um die Verlustfunktion zu minimieren. Das unterscheidet sich nicht von einfacher linearer Regression.
Denken Sie daran, dass die Verlustfunktion einfach die Differenz zwischen dem vorhergesagten und dem beobachteten Wert ist. Wenn es nur 1 oder 2 Eingaben gibt, ist das einfach. Aber bei Handschrifterkennung gibt es Hunderte oder Tausende von Eingaben.
(Für ein Bild mit 256 Pixeln gibt es 256 * 256 Eingänge in unserem neuronalen Netzwerk, es sieht ungefähr so aus, nur dass es verkleinert wurde, damit man es visualisieren kann. Und dieses Netzwerk betrachtet nur Ziffern und nicht das ganze Alphabet.)
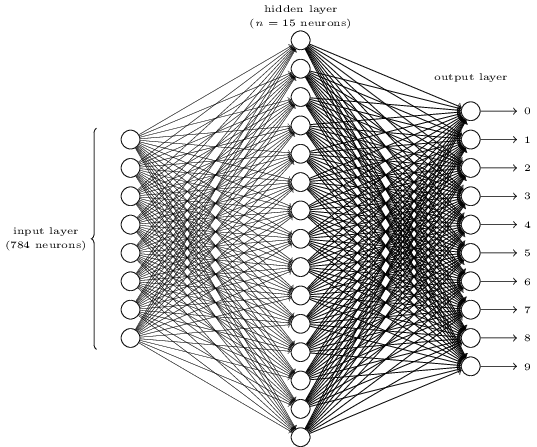
Bei der einfachen linearen Regression ist die Verlustfunktion der Abstand zwischen dem beobachteten Wert z und dem vorhergesagten Wert p, also z – p. Bei neuronalen Netzen verwenden wir etwas Komplizierteres namens stochastischer Gradientenabstieg, der nicht unbedingt verstanden werden muss. Es genügt zu sagen, dass es im Grunde dasselbe ist. Aber den Minimalwert in einer Funktion mit Tausenden von Eingabevariablen zu finden, ist schwer zu erreichen, daher macht der stochastische Gradientenabstieg zunächst eine Vermutung und arbeitet dann von dort aus.
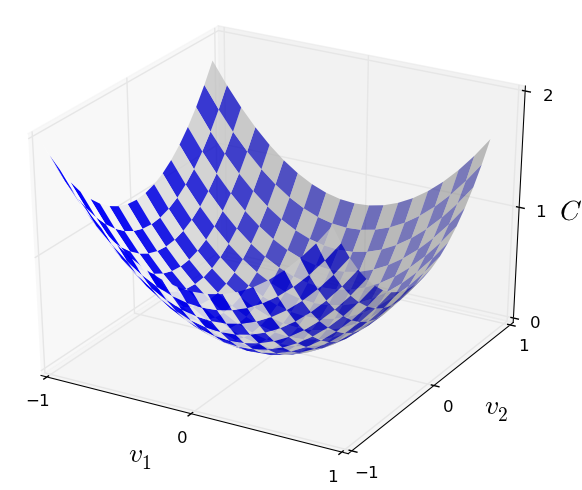
Michael Nielsen gibt diese Analogie. Unten ist ein Diagramm einer Verlustfunktion f(x,y), also einer Funktion mit zwei Eingaben. Wenn man eine Murmel in diese Schale wirft, rollt sie zum tiefsten Punkt. Der stochastische Gradientenabstieg ist ein Algorithmus, um diesen Punkt für eine Verlustfunktion mit vielen Eingabevariablen zu finden. (Für diejenigen, die sich mit Analysis auskennen, könnte man sagen: Warum nimmt man nicht einfach die Ableitung dieser Funktion und findet ihr Minimum? Die Antwort ist, dass man die Ableitung einer Funktion mit tausenden Variablen nicht leicht finden kann.)
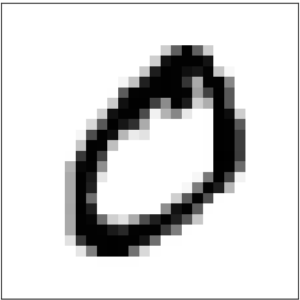
Wie auch immer, schauen wir uns nun an, wie das mit der Handschrifterkennung funktioniert. Hier ist ein Bild der Zahl "0". Das neuronale Netzwerk betrachtet jeden Pixel und wie dunkel der Pixel ist, um herauszufinden, welche Pixel ausgefüllt sind. Dann wird das mit Handschriftproben abgeglichen, von denen bekannt ist, dass sie die Zahl 0 repräsentieren.
Das MNIST-Trainingsset nimmt Handschriftproben von 250 Personen auf. Diese Daten nehmen die Kombination der Pixel jeder Zeichnung und geben an, ob es sich um eine 0, 1, 2, ...oder 9 handelt.
Das neuronale Netzwerk wird dann auf Basis dieser Daten trainiert , d. h. es passt die Koeffizienten und den Bias an, bis es die genauste Ziffer bestimmt.
Dann fügen Sie Handschriftbeispiele von Personen ein, die nicht im Trainingsset anwesend sind. Dieser neue Datensatz wird als Testset bezeichnet, was es ermöglicht, das zu lesen, was diese Personen geschrieben haben.
Verwandte Literatur
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.