




Auf einen Blick: Control-M von BMC ist eine Workflow-Orchestrierungsplattform, die die Abläufe von Datenprojekten optimiert und die Sichtbarkeit und Effizienz verbessert. Sie hilft Organisationen, Herausforderungen bei der Operationalisierung von Dateninitiativen zu überwinden, indem sie Pipelines automatisiert und verschiedene Technologien integriert.
- Control-M bietet eine Automatisierungs-API für die Zusammenarbeit zwischen Dev und Ops.
- Es bietet integrierte Unterstützung für Cloud-Ressourcen und Dateiübertragungsmanagement.
Um Datenprojekte zu operationalisieren, benötigen Organisationen automatisierte, orchestrierte End-to-End-Transparenz in jeder Phase der Datenpipeline. Ohne ein strukturiertes Operationalisierungsrahmen stocken selbst die ausgefeiltesten Dateninitiativen, bevor sie in die Produktion gelangen. Eine einheitliche Workflow-Orchestrierungsplattform, die die Komplexität unterschiedlicher Datentools abstrahiert, ist die entscheidende Brücke zwischen einem funktionierenden Prototyp und der Bereitstellung im Unternehmensmaßstab.
Die Daten sind reichlich vorhanden – und wachsen exponentiell. Aber allein die Daten zu haben, reicht nicht aus. Unternehmen haben ständig Schwierigkeiten, Datenprojekte von der Entwicklung in die Produktion zu bringen, und die Kosten dieser Lücke sind erheblich. Im Jahr 2018 sagte Gartner® in ihrem Bericht mit dem Titel "Predicts 2019: Artificial Intelligence Core Technologies" voraus, dass bis 2022 nur 15 Prozent der modernsten Datenprojekte in die Produktion gehen würden – was bedeutet, dass 85 Prozent keine Ergebnisse liefern würden. Separat warnte Gartner in seinem Bericht Top Trends in Data and Analytics 2022, dass Unternehmen ohne einen nachhaltigen Rahmen zur Daten- und Analyse-Operationalisierung Gefahr laufen, ihre Initiativen um bis zu zwei Jahre zurückzuwerfen.
Warum haben Datenprojekte Schwierigkeiten, in die Produktion zu gelangen?
Die zentrale Herausforderung ist die Skalierung. Ein Projekt kann als Prototyp an einem Ort gut funktionieren, aber wenn es national oder global nicht skalierbar ist, ist es im Grunde gescheitert.
Da Unternehmen die Notwendigkeit erkennen, Operationalisierung in ihre Pläne einzubauen, hat sich die Branche wieder auf IT-Betrieb (ITOps) konzentriert – und eine Reihe disziplinspezifischer Ops-Frameworks entwickelt: DataOps für Daten, MLOps für maschinelles Lernen, AIOps für künstliche Intelligenz und ModelOps für Analysemodellierung. Diese Verbreitung hat sogar den Sammelbegriff XOps hervorgebracht – ein Platzhalter, wie einige in der Branche es ausdrücken, für "Wir wissen nicht, was als Nächstes kommt , aber es wird irgendwie Ops beinhalten." Das Problem ist nicht der Ehrgeiz. Es ist die Komplexität.
Was sind die vier Phasen einer Datenpipeline?
Jedes Datenprojekt teilt die gleichen vier grundlegenden Phasen, die die Bausteine von Datenpipelines bilden:
1. Datenaufnahme
Die Orchestrierung von Daten aus traditionellen Quellen wie Enterprise Resource Planning (ERP) und Customer Relationship Management (CRM), Finanzplattformen und anderen Datensystemen – kombiniert mit Daten von Geräten, Sensoren, sozialen Medien, Weblogs sowie IoT-Sensoren und -Geräten.
2. Datenspeicherung
Wo und wie Daten gespeichert werden, hängt maßgeblich von der Persistenz, dem relativen Wert der Datensätze, der Aktualisierungsrate für Analysemodelle und der Geschwindigkeit ab, mit der Daten zur Verarbeitung gelangen können.
3. Datenverarbeitung
Die Verarbeitungsanforderungen variieren stark: Wie viel Rechenkraft wird benötigt? Ist sie konstant oder variabel? Ist die Arbeitslast geplant, ereignisgesteuert oder ad hoc? Wie werden die Kosten minimiert?
4. Einsichtsvermittlung
Die letzte Meile – die Datenausgabe in Analysesysteme verlagern. Die Insights-Schicht ist komplex und verändert sich ständig, da Märkte neue Technologien einführen . Ein neuer Datenanalysedienst, der nicht in großem Umfang produziert wird, liefert keine umsetzbaren Erkenntnisse und keinen Geschäftswert, egal ob gemessen an Umsatzgenerierung oder operativer Effizienz.
Warum ist End-to-End-Orchestrierung für Datenpipelines unerlässlich?
Das operative Ziel ist es, Datenpipelines hochautomatisiert mit minimalem menschlichem Eingreifen und vollständiger Transparenz über jede Komponente zu betreiben. Aber fast jede Technologie in der Datenpipeline verfügt über eigene integrierte Automatisierungstools und -tools – Tools, die oft nicht dafür ausgelegt sind, miteinander zu arbeiten. Das Zusammennähen dieser für End-to-End-Automatisierung und Orchestrierung ist der Punkt, an dem Teams an die Wand stoßen.
Diese Herausforderung hat den Aufstieg von Anwendungs- und Daten-Workflow-Orchestrierungsplattformen vorangetrieben: Lösungen, die in der Produktion schnell und skalierbar arbeiten und die zugrunde liegenden Automatisierungsprogramme abstrahieren, sodass Teams sich auf Ergebnisse statt auf Infrastruktur konzentrieren können.
Wie hilft Control-M, Datenprojekte operationalisiert zu machen?
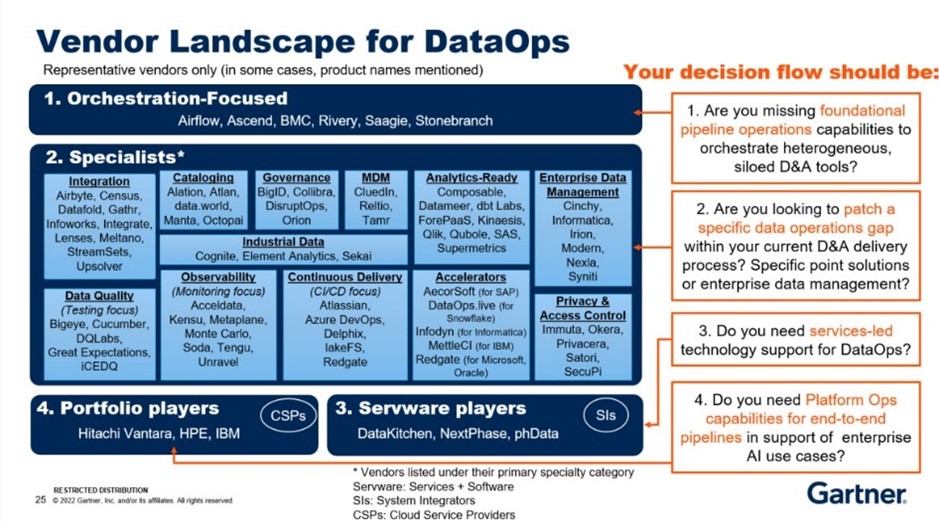
Control-M von BMC ist eine Plattform zur Orchestrierung und Automatisierung von Anwendungs- und Datenworkflows, die als Abstraktionsschicht dient, um die komplexe Datenpipeline zu vereinfachen. Control-M ermöglicht End-to-End-Transparenz und prädiktive Service Level Agreements (SLAs) über jede Datentechnologie oder Infrastruktur hinweg, liefert datengetriebene Erkenntnisse in der Produktion im großen Maßstab und integriert neue technologische Innovationen selbst in die komplexesten Datenpipelines.
Die Control-M-Plattform bietet eine Reihe von Funktionen zur Automatisierung und Orchestrierung von Anwendungs- und Datenabläufen:
- Die Control-M Automation API fördert die Zusammenarbeit zwischen Dev und Ops, indem sie Entwicklern ermöglicht, produktionsfähige Workflow-Automatisierung während der Entwicklung von Anwendungen einzubetten.
- Fertige Unterstützung für Cloud-Ressourcen wie Amazon Web Services (AWS), Lambda sowie Azure Logic Apps, Functions und Batch, um Ihnen zu helfen, die Flexibilität und Skalierbarkeit Ihrer Cloud-Ökosysteme zu nutzen.
- Integrierte Dateiübertragungen mit all Ihren Anwendungen, die es Ihnen ermöglichen, interne und externe Dateiübertragungen auf eine zentrale Schnittstelle zu verschieben, um Sichtbarkeit und Kontrolle zu verbessern.
- Self-Service-Funktionen , die es Mitarbeitern im gesamten Unternehmen ermöglichen, auf die für sie relevanten Arbeitsdaten zuzugreifen.
- Application Integrator, der die Erstellung benutzerdefinierter Jobtypen unterstützt und diese schnell und einfach in Ihrer Control-M-Umgebung bereitstellt.
- Konvertierungstools , die die Konvertierung durch Terminplaner von Drittanbietern vereinfachen.
Datenprojekte werden weiterhin an strategischer Bedeutung gewinnen. Die erfolgreiche Operationalisierung von Datenworkflows als Kernbestandteil der Projektplanung und -umsetzung ist für Geschäftsergebnisse unerlässlich. Eine Plattform zur Orchestrierung vonAnwendungs- und Datenworkflows sollte ein grundlegender Schritt auf jeder DataOps-Reise sein.
Um mehr darüber zu erfahren, wie Control-M Ihnen bei DataOps helfen kann, Erfolg zu finden, besuchen Sie unsere Website.
Häufig gestellte Fragen
Was bedeutet es, ein Datenprojekt operationalisiert zu machen?
Die Operationalisierung eines Datenprojekts bedeutet , es vom Prototyp oder der Entwicklung in eine zuverlässige, wiederholbare Produktion im großen Maßstab zu bringen . Die Operationalisierung erfordert die Automatisierung der Kernphasen der Pipeline – Aufnahme, Speicherung, Verarbeitung und Erkenntnisse – sodass Datenprojekte konsequent umsetzbare Ergebnisse ohne manuelles Eingreifen liefern.
Warum schaffen es die meisten Datenprojekte nicht in die Produktion?
Die meisten Datenprojekte schaffen es nicht , in die Produktion zu gelangen, da sie im großen Maßstab komplex sind. Jede Pipeline-Phase basiert auf unterschiedlichen Werkzeugen und Technologien, die sich nicht nativ integrieren, was eine End-to-End-Automatisierung erschwert. Ohne eine Orchestrierungsschicht, die diese Komponenten vereint, können Teams nicht die Sichtbarkeit und Kontrolle aufrechterhalten , die nötig sind, um Pipelines zuverlässig in der Produktion zu betreiben.
Was ist der Unterschied zwischen Datenautomatisierung und Datenorchestrierung?
Datenautomatisierung bezeichnet die Ausführung einzelner Aufgaben oder Prozesse ohne menschliches Eingreifen. Datenorchestrierung koordiniert mehrere automatisierte Aufgaben über Werkzeuge, Systeme und Umgebungen hinweg, um eine vollständige Datenpipeline als einen einzigen verwalteten Workflow auszuführen. Orchestrierung ermöglicht Automatisierung im Unternehmensmaßstab .
Welche Rolle spielt DataOps bei der Operationalisierung von Datenprojekten?
DataOps wendet DevOps-Prinzipien – kontinuierliche Integration, Automatisierung und Zusammenarbeit – auf die Entwicklung und den Betrieb von Datenpipelines an. Ein DataOps-Framework hilft Organisationen, von Anfang an eine Operationalisierung in Datenprojekte einzubauen, wodurch die Zeit vom Prototyp bis zur Produktion verkürzt und die Zuverlässigkeit datengetriebener Ergebnisse verbessert wird.
Worauf sollte ich bei einer Workflow-Orchestrierungsplattform achten?
Eine Workflow-Orchestrierungsplattform für Datenprojekte sollte End-to-End-Transparenz der Pipeline, Unterstützung für heterogene Datentechnologien und Cloud-Umgebungen, ereignisgesteuerte und geplante Arbeitslastfunktionen, integriertes Dateiübertragungsmanagement, Self-Service-Zugriff für Geschäftsanwender und APIs bieten, die die Zusammenarbeit zwischen Dev und Ops während der Entwicklung ermöglichen.
GARTNER ist eine eingetragene Marke und Dienstleistungsmarke von Gartner, Inc. und/oder dessen Tochtergesellschaften in den USA und international und wird hier mit Genehmigung verwendet. Alle Rechte vorbehalten.
Die in diesem Beitrag geäußerten Ansichten und Meinungen sind die des Autors und spiegeln nicht unbedingt die offizielle Position von BMC wider.
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.