




Auf einen Blick: Eine automatisierte KI-Governance-Pipeline integriert Control-M, Amazon Bedrock und Snowflake, um Portfolio-Rebalancing-Prozesse zu verbessern. Sie gewährleistet zuverlässige Ergebnisse durch Datenvalidierung, Berichterstattung und Orchestrierung von Arbeitsabläufen für zeitnahe Entscheidungen.
- Control-M verwaltet den gesamten Workflow-Lebenszyklus für die operative Steuerung.
- AWS DataBrew validiert Daten, um unzuverlässige Ausgaben zu vermeiden.
Erfahren Sie, wie Control-M eine produktionsfähige KI-Governance-Pipeline mit Amazon Bedrock, Snowflake, DataBrew, SES und QuickSight – zuverlässig inszeniert.
Einen KI-Agenten dazu zu bringen, auf einem Spielplatz eine überzeugende Antwort zu liefern, ist unkompliziert. Denselben Agenten jedes Quartal zuverlässige, vertrauenswürdige Ergebnisse liefern zu lassen – auf frischen Daten, in der richtigen Reihenfolge, mit Ergebnissen an die richtigen Personen und Systeme – ist ein ganz anderes Problem.
Die Lücke zwischen einem Demo- und einem Produktions-KI-Workflow liegt meist nicht im Agenten selbst. Es handelt sich um alles drumherum, wie Datenvalidierung, Orchestrierung, Synchronisation und operative Sichtbarkeit.
Agenten benötigen validierte Upstream-Daten, bevor sie darüber argumentieren. Eine Halluzination, die durch einen veralteten Governance-Snapshot oder einen fehlenden Risikoindikator verursacht wird, ist nicht einfach ein Modellproblem – es handelt sich um ein Problem der Zuverlässigkeit der Pipeline. Gleichzeitig müssen nachgelagerte Systeme korrekt auf die Ergebnisse des Agenten reagieren: Berichte müssen generiert, Dashboards aktualisiert, Empfehlungen archiviert und Governance-Entscheidungen zur Prüfbarkeit erhalten bleiben.
All dies muss in der richtigen Reihenfolge geschehen, mit operativer Transparenz, Abhängigkeitsmanagement und Fehlerbewältigung im gesamten Arbeitsablauf.
Das ist das Orchestrierungsproblem. Es ist auch eine der größten Herausforderungen, denen Organisationen gegenüberstehen, wenn sie KI-Agenten von Experimenten in die Produktion bringen.
In diesem Beitrag zeigen wir, wie Sie eine End-to-End-Pipeline für KI-Governance auf Produktionsniveau aufbauen können, indem Sie Control-M von BMC für die Workflow-Orchestrierung, Amazon Bedrock Agents für KI-gestützte Portfolio-Argumentation und AWS-Analysedienste wie AWS DataBrew, Amazon Simple Email Service (Amazon SES), Amazon QuickSight und Amazon Simple Storage Service (Amazon S3) aufbauen. Die Pipeline nimmt S&P 500-Governance-Daten von Snowflake auf, ruft einen Amazon Bedrock Agent auf, um strategische Empfehlungen zur Portfolio-Neuausgleichung zu erstellen, und orchestriert den gesamten Downstream-Lebenszyklus einschließlich PDF-Berichtsgenerierung, E-Mail-Verteilung, Entscheidungspersistenz und Dashboard-Aktualisierung.
Was wir gebaut haben und warum
Dies ist Phase 3 einer dreiteiligen Serie zur Operationalisierung von Daten- und KI-Workflows mit Control-M. Phase 1 umfasste den Aufbau einer zuverlässigen ETL- und deskriptiven Analysepipeline für S&P-500-Marktdaten, orchestriert von Control-M und visualisiert über Amazon QuickSight. Phase 2 erweiterte diese Grundlage auf prädiktive Analytik, die von Control-M orchestriert wurde, um Renditeprognosen, Volatilitätsschätzungen, Konfidenzwerte und Kauf-/Verkaufssignale zu erstellen.
Phase 3 macht den nächsten Schritt: Anstatt nur prädiktive Scores zu generieren, überlegt ein KI-Agent nun die aktuellen Marktbedingungen, bewertet Governance-Signale und erstellt Empfehlungen zur Portfolio-Neuausrichtung, die nachgelagerte operative Maßnahmen vorantreiben.
Das Geschäftsergebnis ist ein vierteljährlicher Governance-Workflow zur strategischen Portfolio-Rebalancing.
Ein Amazon Bedrock Agent – der Sentinel-1 Strategic Asset Allocator / Portfolio Rebalancing Agent – nimmt governance-fähige Marktinformationen von Snowflake auf, vergleicht sie mit der aktuellen Portfolioallokation und bestimmt, ob Marktfragilitätssignale wie abnehmende Breite, Volatilitätsexpansion und Renditestreuung eine defensivere Allokationsstrategie rechtfertigen.
Wenn erhöhte Risikobedingungen festgestellt werden, empfiehlt der Workflow, die Technologie-Exposition zu reduzieren und die Zuweisungen auf Staples, Utilities und Bargeld umzuverteilen.
Control-M orchestriert den nachgelagerten operativen Lebenszyklus, erstellt Executive PDF-Governance-Berichte, archiviert Berichte in Amazon S3, verteilt Berichte über Amazon SES, überträgt Governance-Entscheidungen zurück in Snowflake und aktualisiert Amazon QuickSight-Dashboards für operative Transparenz.
Das ist es, was einen KI-Workflow von einer isolierten Modellinvocation in eine produktionswürdige Governance-Plattform verwandelt.
Architektur
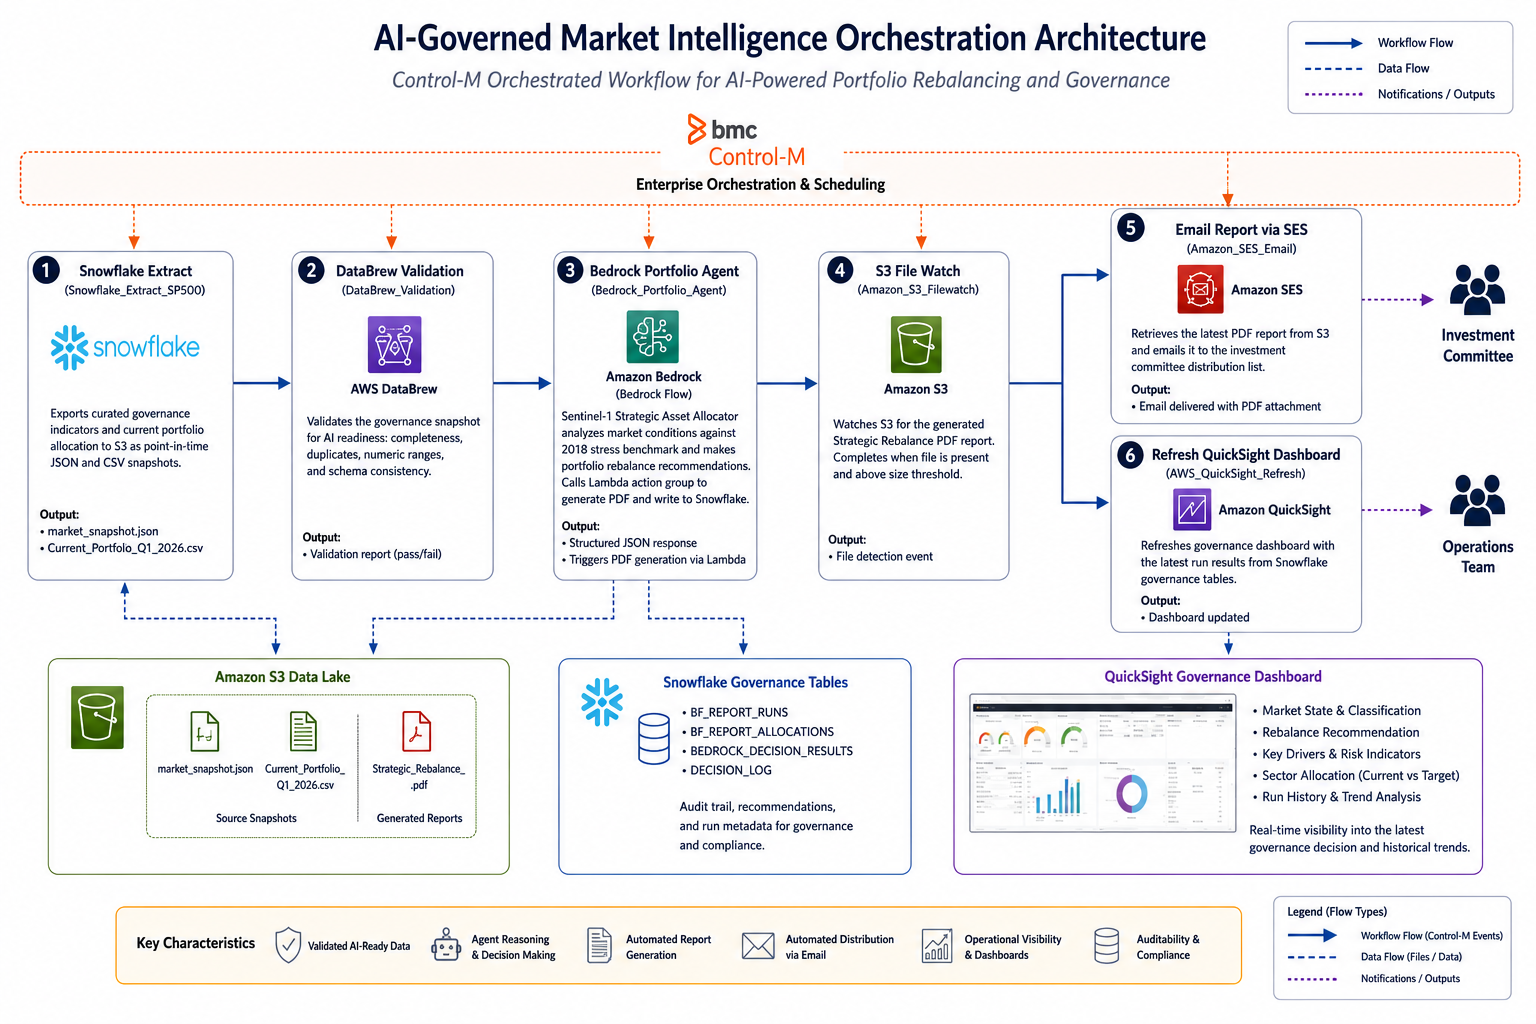
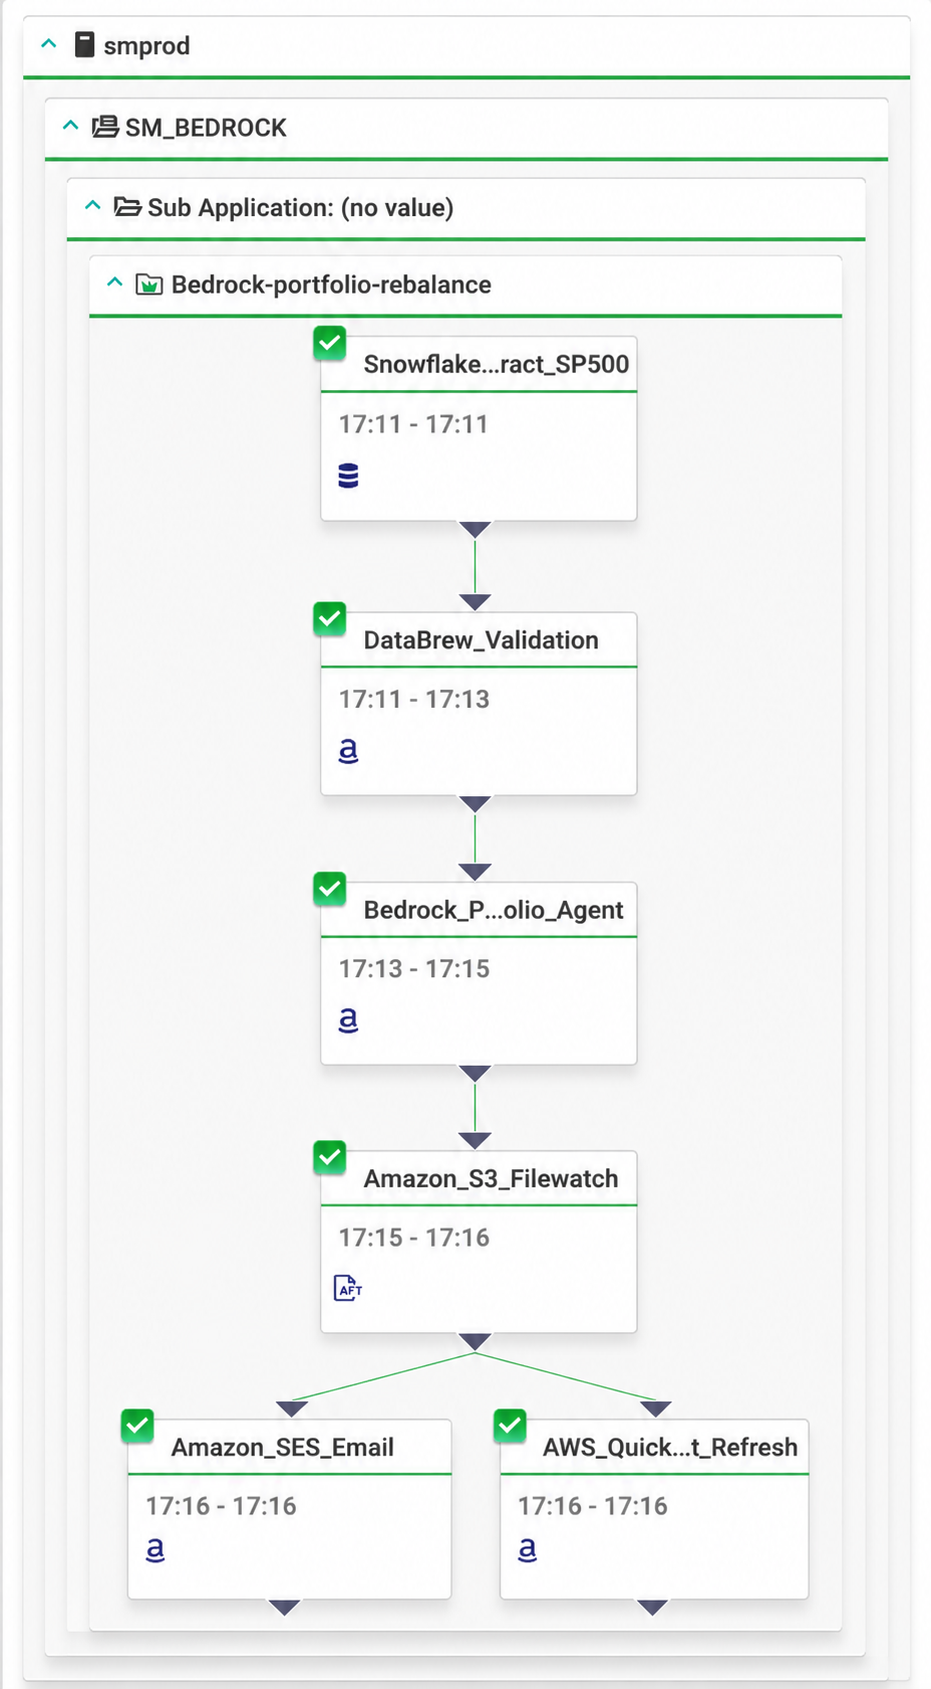
Die Phase-3-Pipeline baut auf der Snowflake- und S3-Datengrundlage auf, die in den früheren Phasen etabliert wurde. Control-M orchestriert den gesamten Workflow-Lebenszyklus über Snowflake, AWS DataBrew, Amazon Bedrock, AWS Lambda, Amazon SES, Amazon S3 und Amazon QuickSight.
Auf einer überlagerten Ebene folgt der Orchestrierungs-Workflow dieser Abhängigkeitskette:
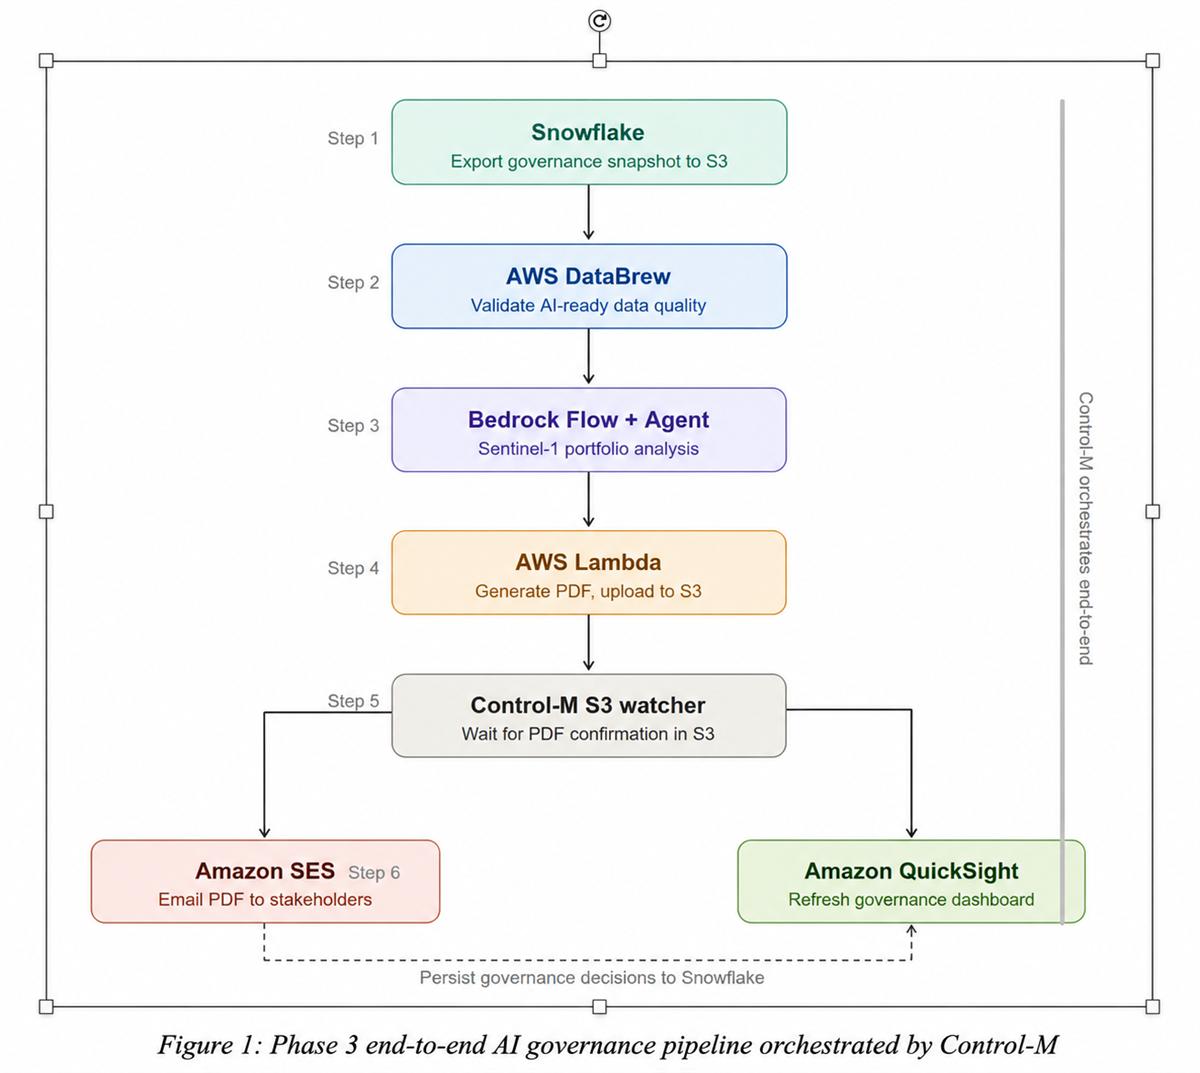
Jeder Job startet erst, nachdem seine Upstream-Abhängigkeit erfolgreich abgeschlossen ist. Wenn eine Phase fehlschlägt, stoppt Control-M den Workflow, bevor unvollständige oder unzuverlässige Governance-Ausgaben nachgelagerte Nutzer erreichen.
Zwei architektonische Entscheidungen wurden während der Umsetzung besonders wichtig.
Die erste war die Trennung von Bedrock-Argumentation und PDF-Generierung. Frühere Versionen versuchten, PDF-Inhalte direkt durch die Bedrock-Antwort zu leiten. Dies führte zu Korruptionsproblemen, da Binärdaten als Text behandelt wurden. Die endgültige Architektur hält den Bedrock Agent auf das Schließen und die strukturierte JSON-Generierung fokussiert, während Lambda die PDF-Generierung, das Diagrammrendering, die S3-Archivierung und die Snowflake-Persistenz übernimmt.
Die zweite war die Einführung eines S3-Watchers als Synchronisationsgate. Selbst nach Fertigstellung von Bedrock Flow konnte das generierte PDF weiterhin über den nachgelagerten Lambda-Prozess hochgeladen werden.
Der Control-M Managed File Transfer (MFT) Watcher löste das Problem, indem er wartete, bis der Bericht physisch in S3 existierte, bevor die E-Mail- und Dashboard-Aktualisierungsschritte freigegeben wurden.
Dadurch wurde der Workflow zu einer deterministischen Orchestrierungspipeline statt zu einer Sammlung locker verbundener Cloud-Dienste.
Bevor Sie diese Lösung einsetzen, stellen Sie sicher, dass Sie Folgendes festgelegt haben:
- Ein aktives AWS-Konto mit Administratorzugriff
- Zugriff auf Amazon Bedrock mit aktiviertem Anthropic Claude 3.5 Sonnet in Ihrer AWS-Region
- Ein Snowflake-Konto mit den von S&P 500 kuratierten Governance-Datensätzen aus den Phasen 1 und 2
- Control-M-Umgebung (v9.0.21+) mit installiertem Control-M for AWS-Integrations-Plug-in
- Ein Amazon S3-Bucket zum Staging von Governance-Snapshots und zur Archivierung von PDF-Berichten
- IAM-Rollen konfiguriert für Bedrock, Lambda, S3, SES und QuickSight-Zugriff (siehe Sicherheitsüberlegungen)
- Amazon SES konfiguriert mit verifizierten Absender- und Empfängeridentitäten für die E-Mail-Verteilung
- AWS Lambda-Funktionen wurden für PDF-Generierung, S3-Archivierung und Snowflake-Persistenz bereitgestellt (mit den erforderlichen Lambda-Schichten für ReportLab und Matplotlib)
- Ein Amazon QuickSight-Konto mit einer Snowflake-Verbindung konfiguriert für die Visualisierung des Governance-Dashboards
Schritt 1: Exportiere das Governance-Snapshot aus Snowflake
Die historischen und kuratierten Governance-Datensätze des S&P 500 befinden sich in Snowflake. Bevor der Bedrock Agent die Daten analysieren kann, exportiert der Workflow Governance-Indikatoren in einen strukturierten JSON-Snapshot, der in Amazon S3 gefasst wird.
Der Governance-Kontext stammt aus VW_MARKET_TREND_CONTEXT, einer kuratierten Snowflake-Sichtweise, die Marktbreiteindikatoren, Volatilitätskennzahlen, Bollinger-Band-Breite, Renditestreuung, Signale für gleitende Durchschnittsstärke und Governance-Risikowerte bereitstellt.
Der Workflow exportiert diese Daten in market_snapshot.json, das zum Governance-Kontext wird, der vom Bedrock Agent verbraucht wird.
Sicherheitsaspekte
    COPY INTO @SP500_CURATED.GOVERNANCE.SP500_S3_STAGE/market_snapshot.json
FROM (
SELECT ARRAY_AGG(
OBJECT_CONSTRUCT(
'date', DATE,
'risk_score', RISK_SCORE,
'vol_change', VOL_CHANGE,
'breadth_change', BREADTH_CHANGE,
'avg_volatility', AVG_VOLATILITY,
'pct_overbought', PCT_OVERBOUGHT,
'return_dispersion', RETURN_DISPERSION,
'dispersion_change', DISPERSION_CHANGE,
'pct_above_ma30', PCT_ABOVE_MA30,
'avg_bb_width', AVG_BB_WIDTH
)
) AS market_data
FROM SP500_CURATED.MARKET.VW_MARKET_TREND_CONTEXT
)
FILE_FORMAT = (TYPE = 'JSON' COMPRESSION = NONE)
OVERWRITE = TRUE
SINGLE = TRUE;
Das Exportieren von Governance-Snapshots in Amazon S3 vor dem Aufruf des Bedrock Agents erzeugt ein reproduzierbares KI-Eingabeartefakt. Jeder Workflow-Lauf wird auf den exakten Governance-Snapshot zurückverfolgbar, der beim Schließen verwendet wird. Außerdem entkoppelt er die Bedrock-Ausführung von direkten Datenbankabhängigkeiten, was die betriebliche Zuverlässigkeit und Auditierbarkeit verbessert.
Der Workflow schreibt später Governance-Ausgaben zurück in Snowflake-Tabellen, darunter:
- BF_REPORT_RUNS
- BF_REPORT_ALLOCATIONS
- BEDROCK_DECISION_RESULTS
- DECISION_LOG
Diese Tabellen liefern Governance-Historie, Workflow-Metadaten, Empfehlungsverfolgung und operative Auditibilität für nachgelagerte Berichterstattung und Dashboards.
Schritt 2: Validiere den Snapshot auf KI-Bereitschaft
Bevor der Bedrock Agent den Governance-Snapshot verarbeitet, validiert AWS DataBrew die exportierten Daten. Dies wird zum KI-tauglichen Datengatter innerhalb der Orchestrierungspipeline.
Die Validierungsschicht prüft auf Bedingungen, die dazu führen könnten, dass der Bedrock Agent irreführende Governance-Empfehlungen erstellt:
- Leere Governance-Snapshots
- Fehlende Governance-Indikatoren wie risk_score oder breadth_change
- Doppelte Datensätze
- Strukturell ungültige Zahlenwerte
- Schema-Inkonsistenzen
Dieser Schritt wird zu einer der wichtigsten operativen Sicherungen in der Architektur.
KI-Systeme, die über unvollständige Governance-Daten argumentieren, scheitern oft offensichtlich nicht. Stattdessen liefern sie selbstbewusst wirkende Empfehlungen, die auf unzuverlässigen Eingaben beruhen. Indem der Snapshot vor Beginn der Bedrock-Ausführung validiert wird, stellt Control-M sicher, dass nur vertrauenswürdige Governance-Daten die Argumentationsschicht erreichen.
Wenn die Validierung fehlschlägt, startet der Bedrock-Workflow nie.
Dies ist einer der deutlichsten Unterschiede zwischen einem Demo-KI-Workflow und einem Produktions-KI-Workflow.
Schritt 3: Aktivieren Sie den Baserock Portfolio Rebalancing Agent
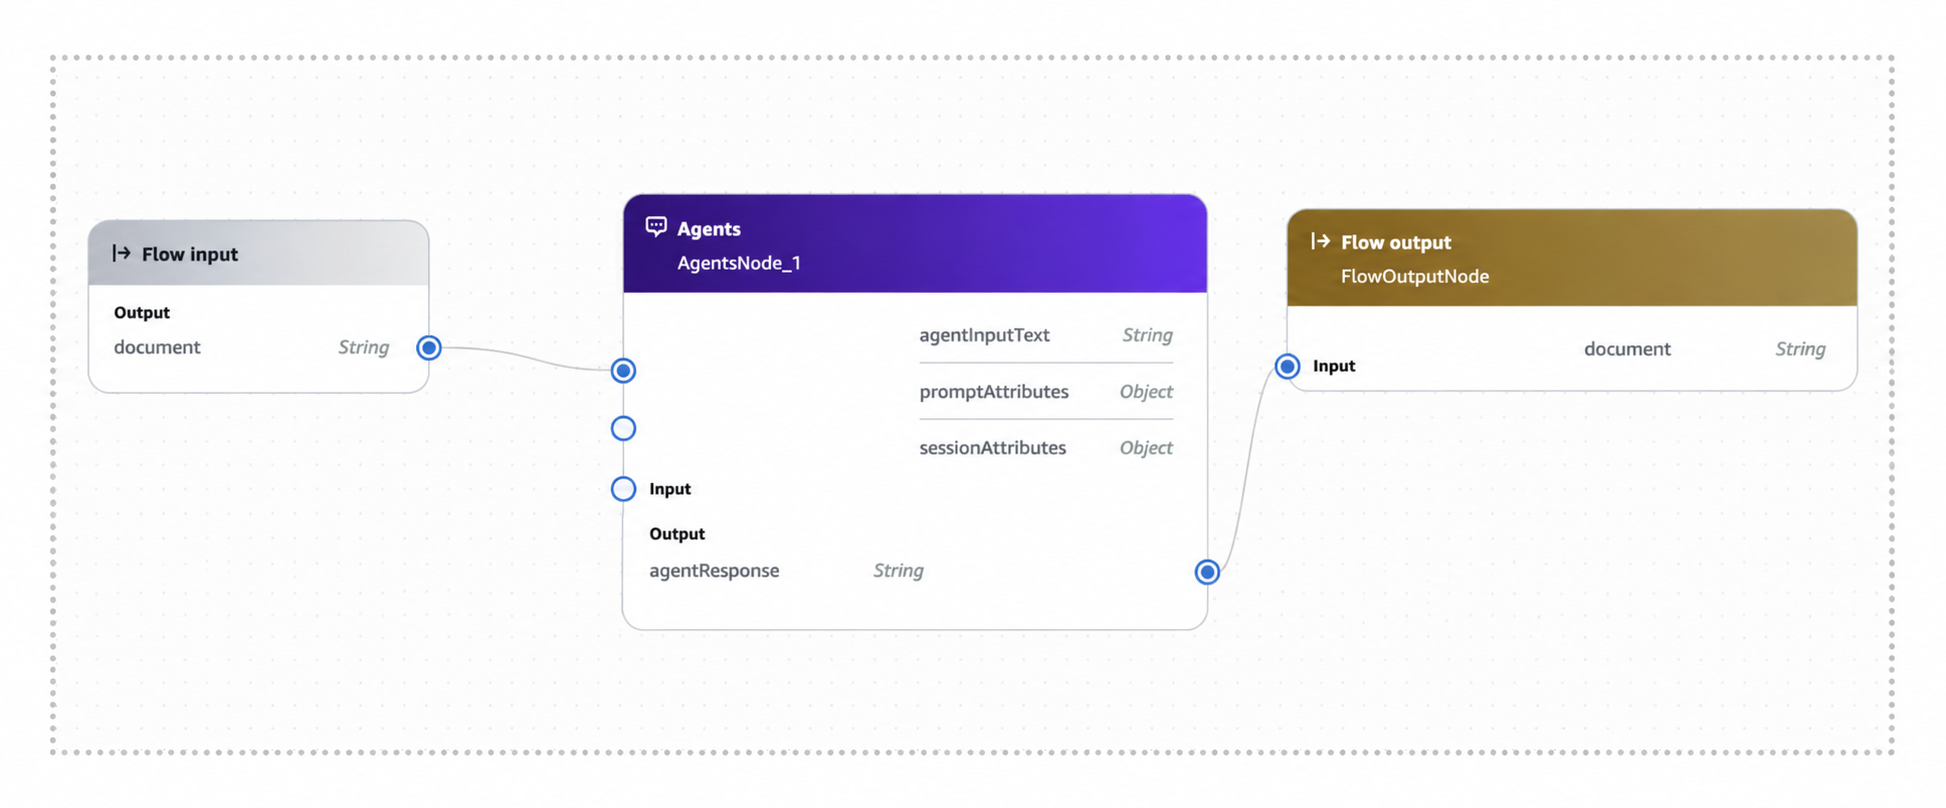
Mit validierten Governance-Daten, die in Amazon S3 gestuft werden, ruft Control-M den Bedrock-Workflow auf.
Der Workflow verwendet Amazon Bedrock Flow und den Sentinel-1 Portfolio Rebalancing Agent, der auf Anthropic Claude 3.5 Sonnet läuft. Der Agent vergleicht die aktuellen Marktbedingungen mit der Stressphase 2018 und bewertet, ob eine defensive Portfolio-Positionierung gerechtfertigt ist.
Der Agent verwendet das anthropische Claude 3.5 Sonett auf Amazon Bedrock. Dieses Modell wurde für seine:
- Starke Leistung bei Aufgaben des strukturierten Denkens und der Finanzanalyse
- 200K-Kontextfenster – ausreichend, um vollständige Governance-Snapshots ohne Verkürzung zu erfassen
- Konsistente strukturierte Ausgabegenerierung mit starker JSON-Schema-Konformität
- Kosteneffizientes Gleichgewicht zwischen Schlussfolgerungsqualität und Invocation-Latenz für vierteljährliche Governance-Workloads
Der Sentinel-1 Portfolio Rebalancing Agent ist konfiguriert wie folgt:
- Datenkontext: S3-Bucket mit Current_Portfolio.csv und dem historischen Stressperioden-Benchmark-Snapshot 2018 (market_snapshot.json)
- Action Group: Das ReportArchiver-Tool erhält die strukturierte JSON-Analyse, erstellt einen PDF-Governance-Bericht mit Zuweisungsdiagrammen, archiviert ihn in S3 und liefert einen sicheren, vorunterschriebenen Download-Link zurück
- Anweisungen: Bewertung von Volatilitätswachstum, Marktverschlechterung, Renditenstreuung und Sektorkonzentration im Vergleich zu historischen Stressperioden. Klassifiziere den Marktzustand, erstelle Rebalancing-Empfehlungen und aktiviere ReportArchiver mit der vollständigen strukturierten JSON-Analyse.
Der letzte Workflow-Prompt, der während der Implementierung verwendet wurde, war:
Die Q1-Daten 2026 werden in S3 (unter Verwendung der Datei Current_Portfolio.csv) bereitgestellt. Führen Sie einen Fragilitäts-Benchmark gegen die Stressperiode 2018 durch und erstellen Sie einen PDF-Vorschlag zur strategischen Neuausrichtung für Q2. Ich muss das Diagramm der empfohlenen Sektorverschiebungen sowohl hier als auch im PDF sehen; bitte stellen Sie alle Diagramme mit 100 DPI dar, um sicherzustellen, dass das PDF für die Archivierung optimiert ist. Archivieren Sie dieses PDF schließlich über das ReportArchiver-Tool in S3 und stellen Sie mir den genauen sicheren Download-Link bereit.
Der Bedrock Agent bewertet Volatilitätswachstum, Verschlechterung der Marktbreite, Renditestreuung, Governance-Risikowerte, Sektorkonzentrationsrisiken und Ähnlichkeiten zu historischen Stressbedingungen.
Die daraus resultierende Antwort enthält Governance-Klassifikationen, Vertrauenswerte, Empfehlungen zur Neuausrichtung und Zusammenfassungen der Executive Governance.
    {
"market_state": "HIGH_RISK",
"confidence": 0.91,
"recommended_action": "STRATEGIC_REBALANCE",
"rebalance_summary": "Trim Technology exposure by 4-5% and redistribute to Staples, Utilities, and Cash.",
"drivers": [
"Breadth deterioration",
"Elevated risk score",
"Volatility expansion",
"Technology overweight relative to defensive allocation"
],
"executive_summary": "Market fragility indicators suggest reducing concentration risk and increasing defensive allocation."
}
Dies wird zum Entscheidungspunkt für die Governance im Workflow. Der Bedrock Agent erzeugt nicht einfach einen Klassifikationsscore – er erstellt eine Empfehlung zur Portfolio-Governance, die auf einer Multifaktoren-Marktanalyse basiert.
Schritt 4: Bestätigen Sie, dass der Bericht in S3 angekommen ist
Nach Abschluss des Bedrock Flow kann der generierte PDF-Bericht noch über den nachgelagerten Lambda-Prozess hochgeladen werden.
Das schafft eine Synchronisationsherausforderung.
Wenn der SES-E-Mail-Job unmittelbar nach Abschluss der Bedrock-Ausführung startet, könnte er versuchen, einen Bericht abzurufen, der noch nicht vollständig in Amazon S3 angekommen ist.
Control-M löst dies mit einem MFT-Uhren-Job.
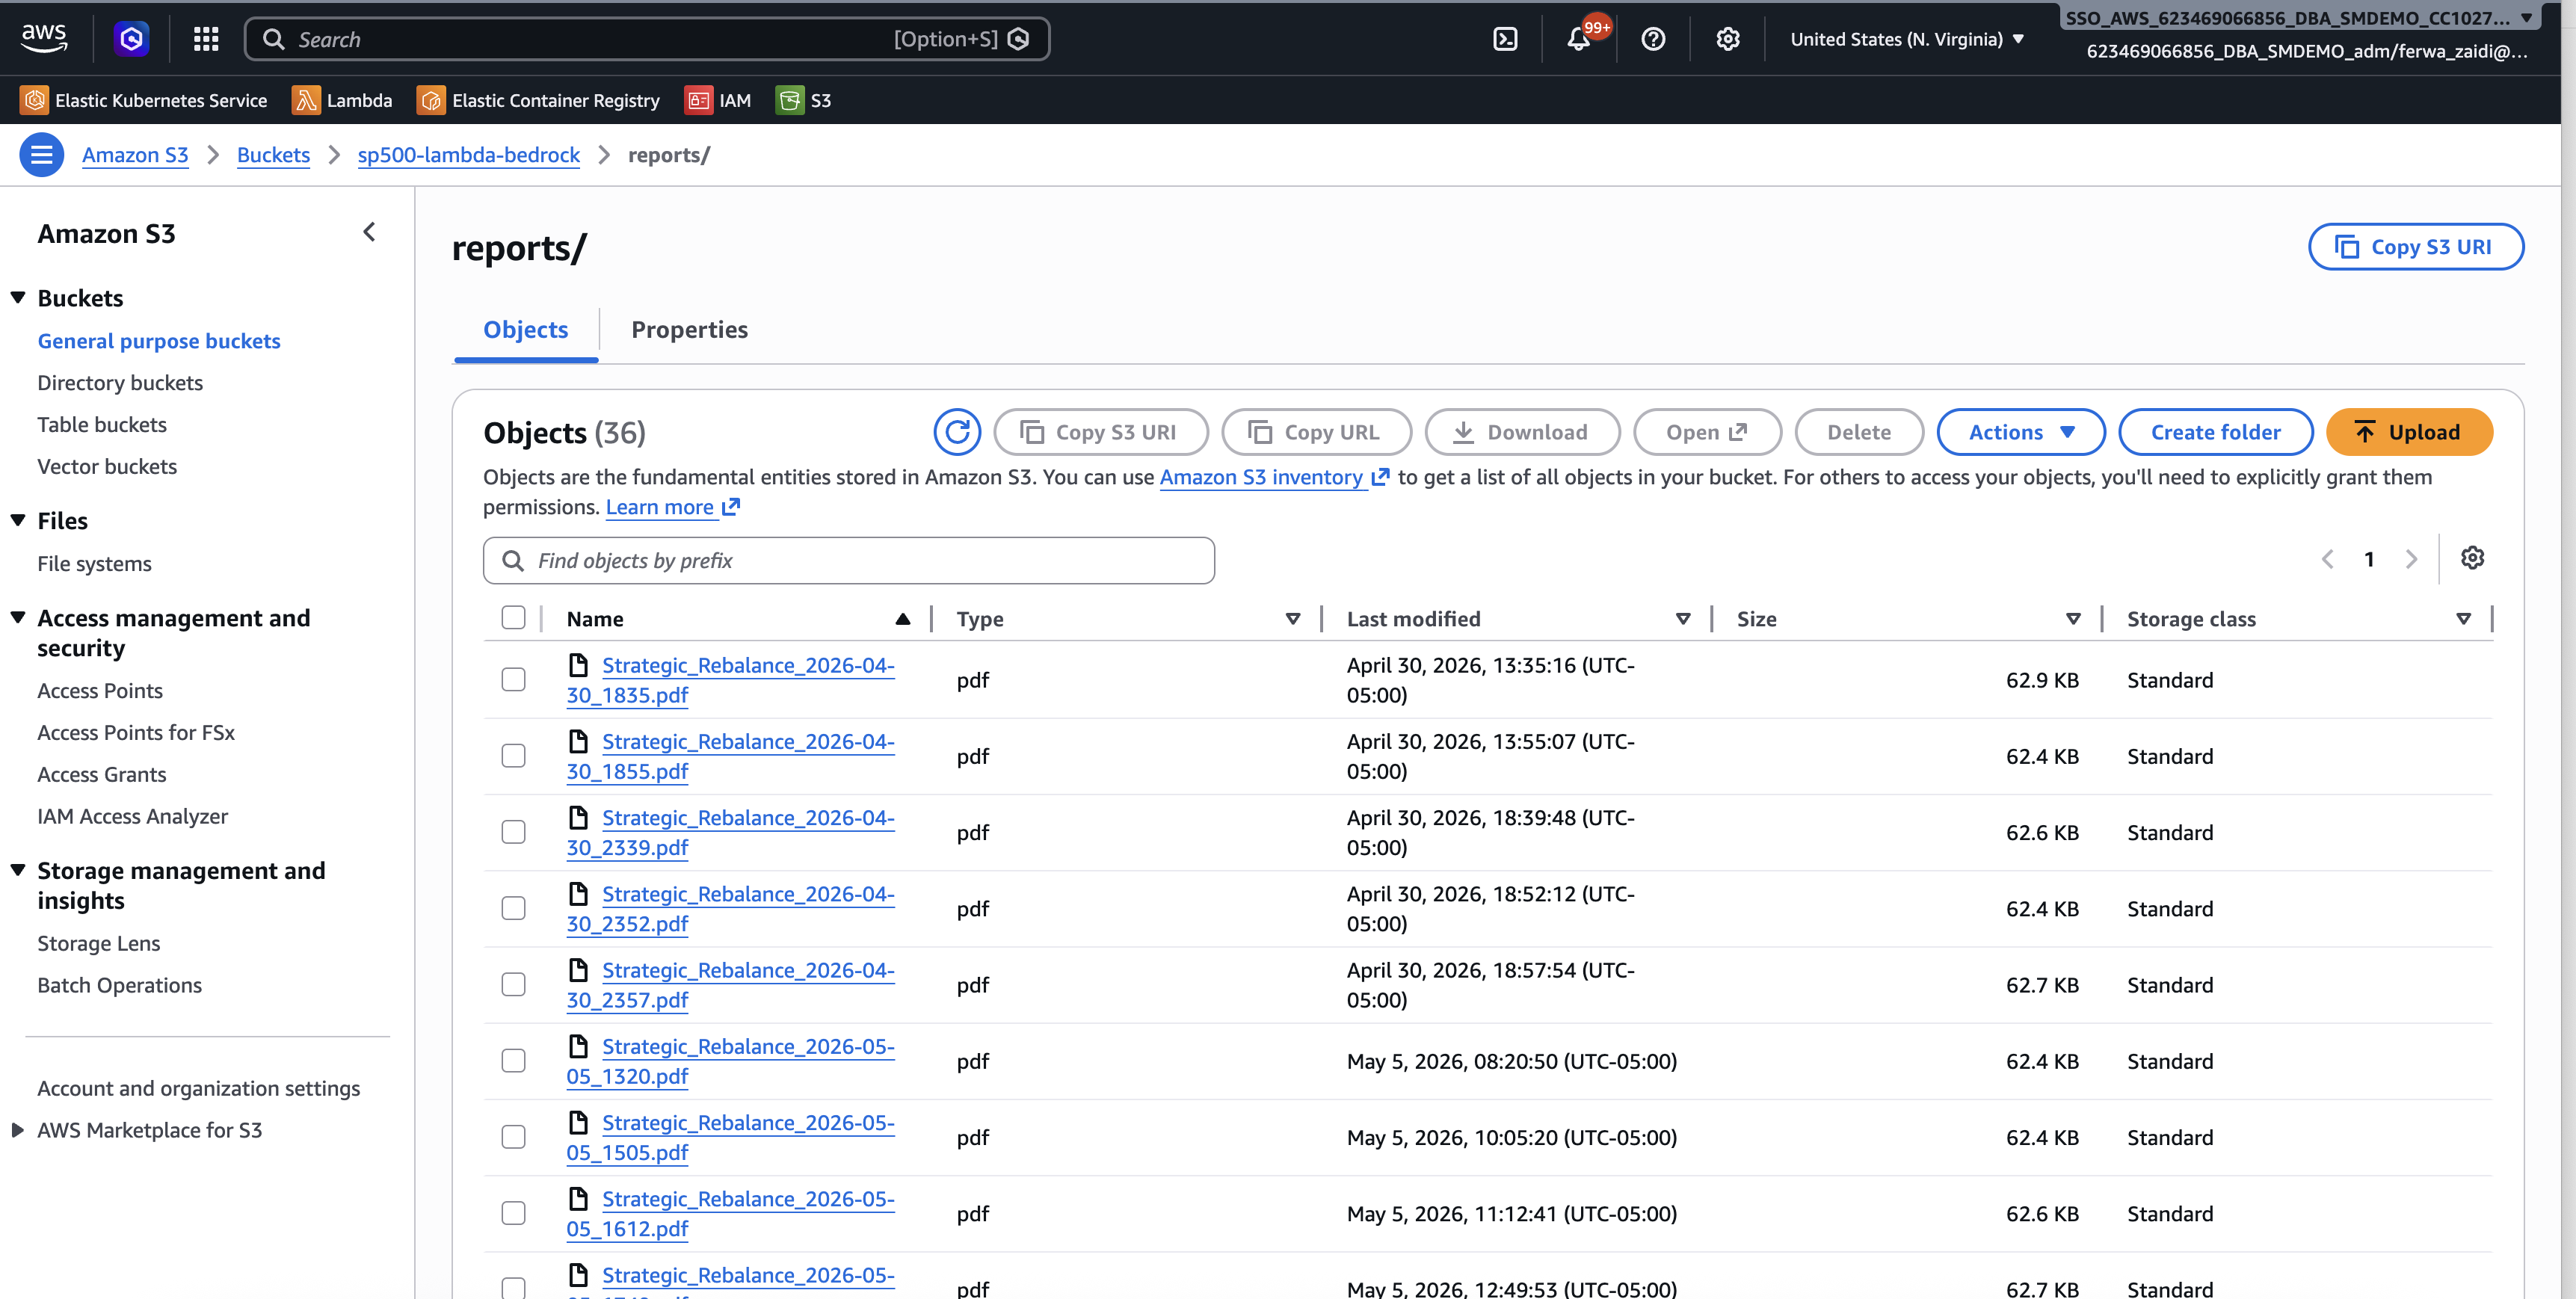
Der Beobachter überwacht:
s3://sp500-lambda-bedrock/reports/
Für übereinstimmende Berichte:
Strategic_Rebalance_*.pdf
Der Workflow wird erst fortgesetzt, wenn der Bericht physisch als bestätigtes, abgeschlossenes Governance-Artefakt in Amazon S3 existiert. Dadurch wird der S3-Watcher zu einem Synchronisationsgate statt zu einer einfachen Überwachungsaufgabe. Es stellt sicher, dass die Verteilung von E-Mails nachgelagert und Dashboard-Aktualisierungen stets funktionieren.
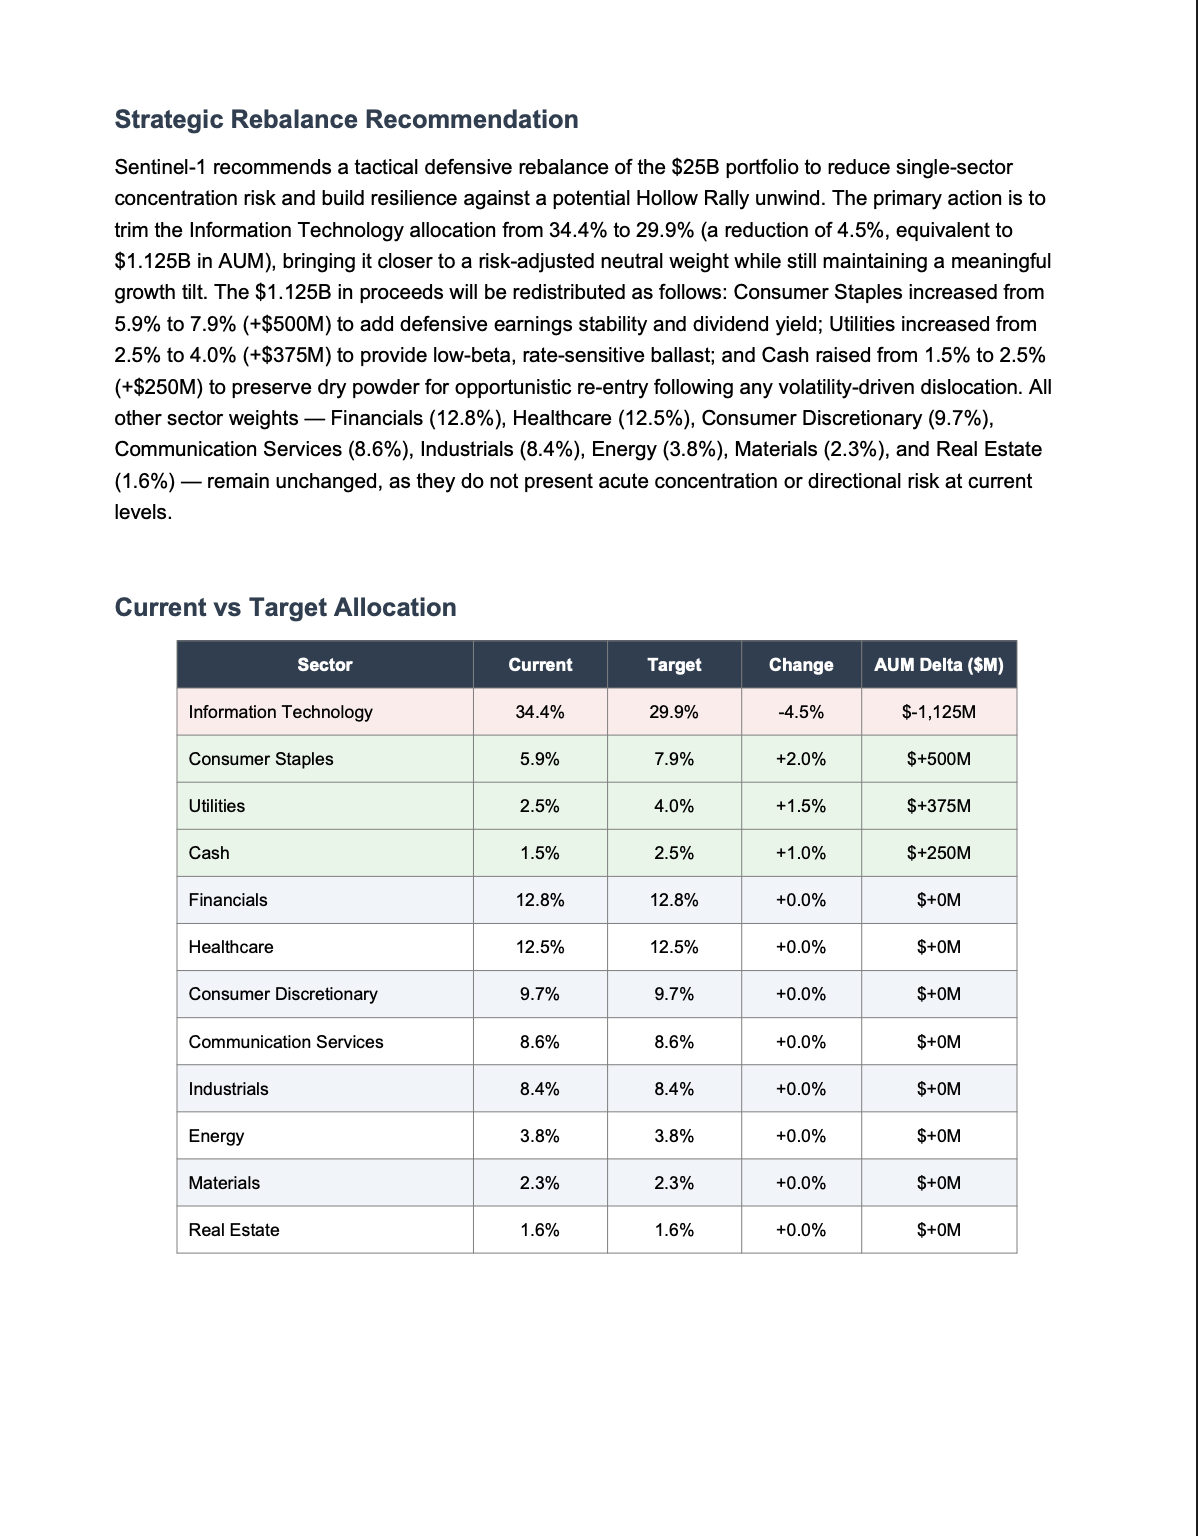
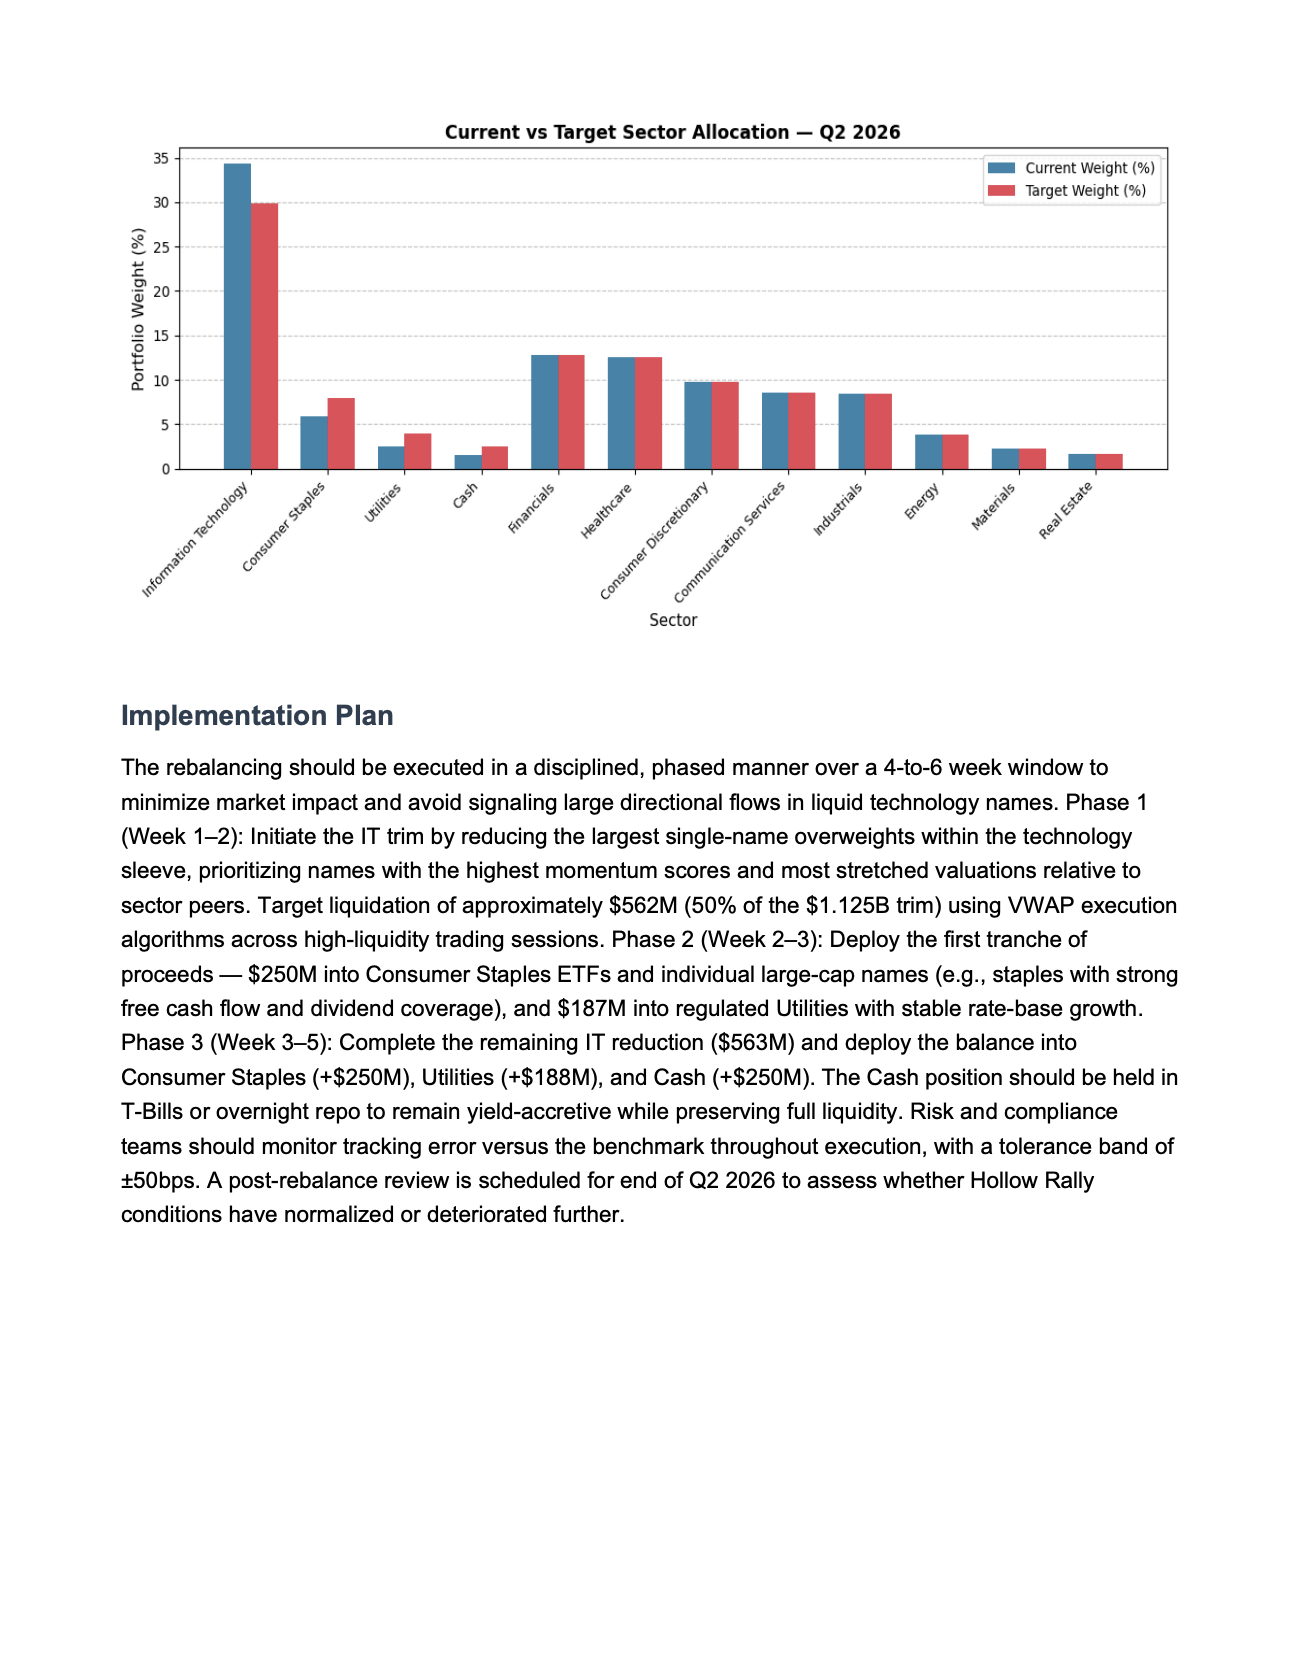
Schritt 5: Versenden Sie den Bericht über Amazon SES
Sobald der Bericht in Amazon S3 bestätigt ist, ruft Control-M den nachgelagerten E-Mail-Verteilungsworkflow auf.
Eine Lambda-Funktion ruft den neuesten Governance-PDF-Bericht von Amazon S3 ab und verteilt ihn über Amazon SES an die konfigurierten Empfänger.
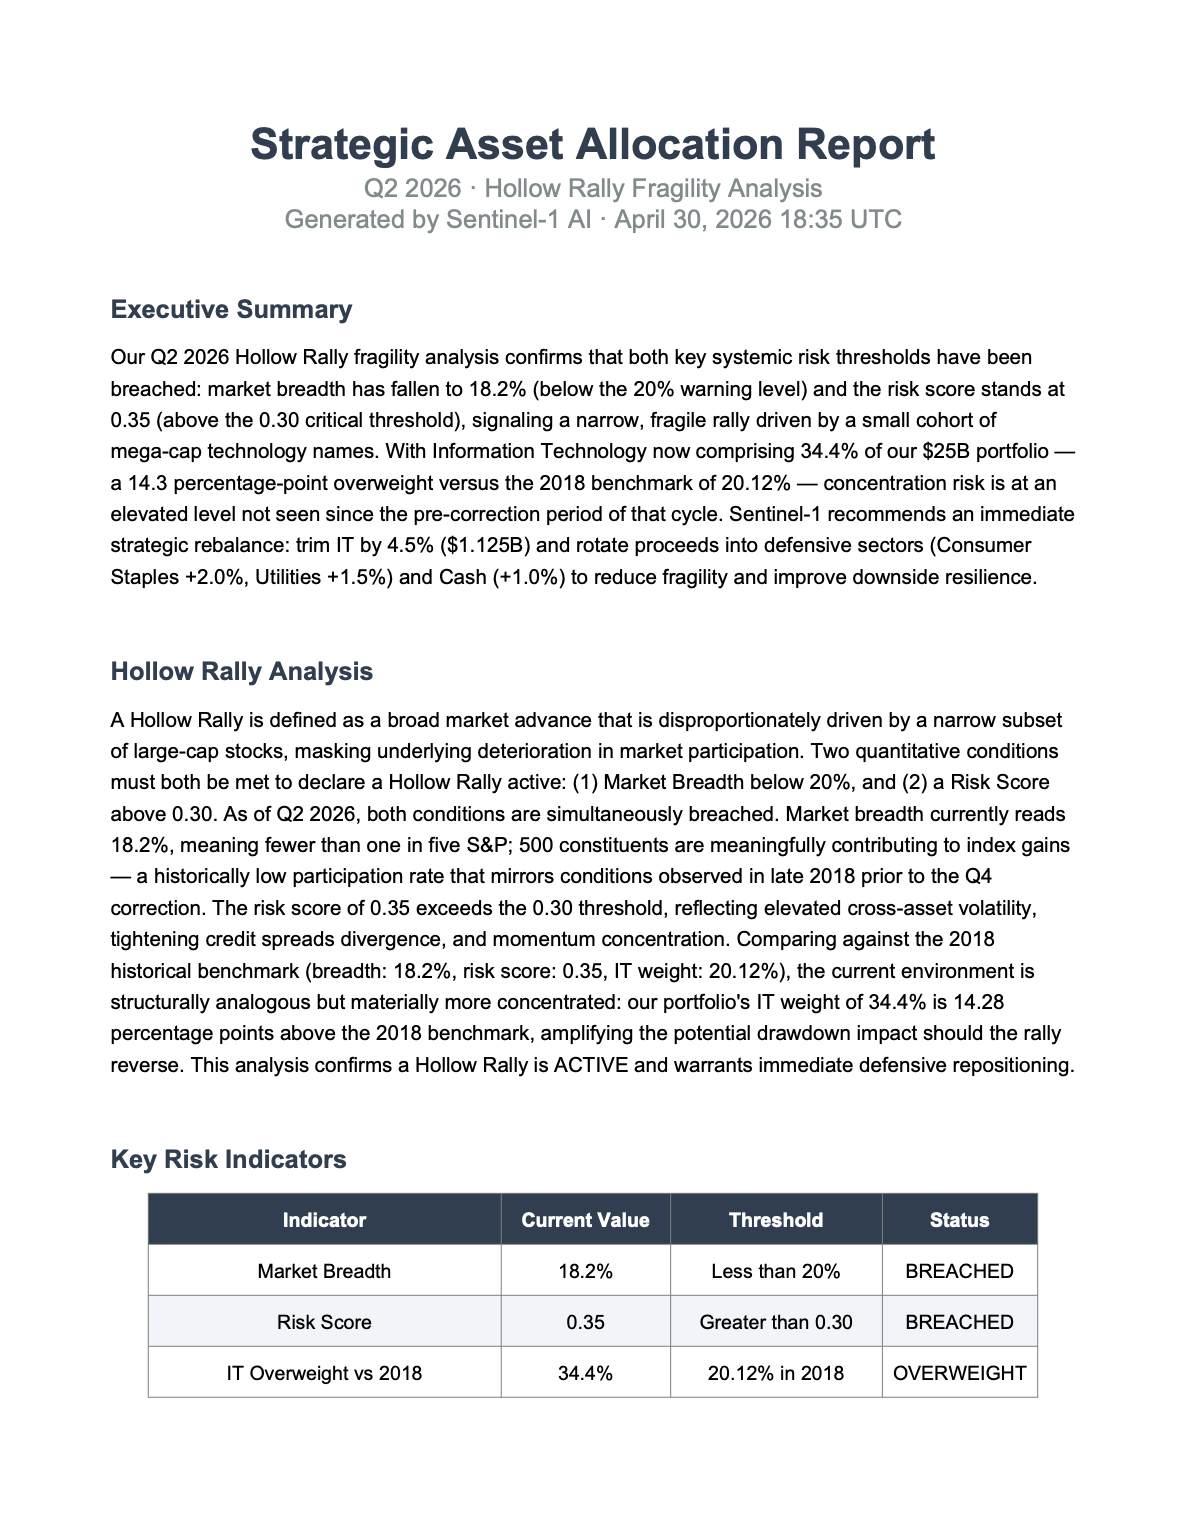
Der verteilte Bericht enthält:
- Governance-Risikoanalyse
- Historische Belastungsbenchmarking
- Aktuelle versus Zielallokationsdiagramme
- Empfehlungen zur strategischen Neuausrichtung
- Zusammenfassungen der Exekutivführung
- KI-generierte Portfolio-Begründung
Dadurch wird KI-Schlussfolgerung zu einer operativen Governance-Lieferleistung statt zu einem isolierten analytischen Ergebnis.
Der Investmentausschuss erhält unmittelbar nach Abschluss des Workflows einen von der Führungskraft fertigen Governance-Bericht, ohne dass manuelle Maßnahmen erforderlich sind.
Schritt 6: Aktualisieren Sie das QuickSight-Governance-Dashboard
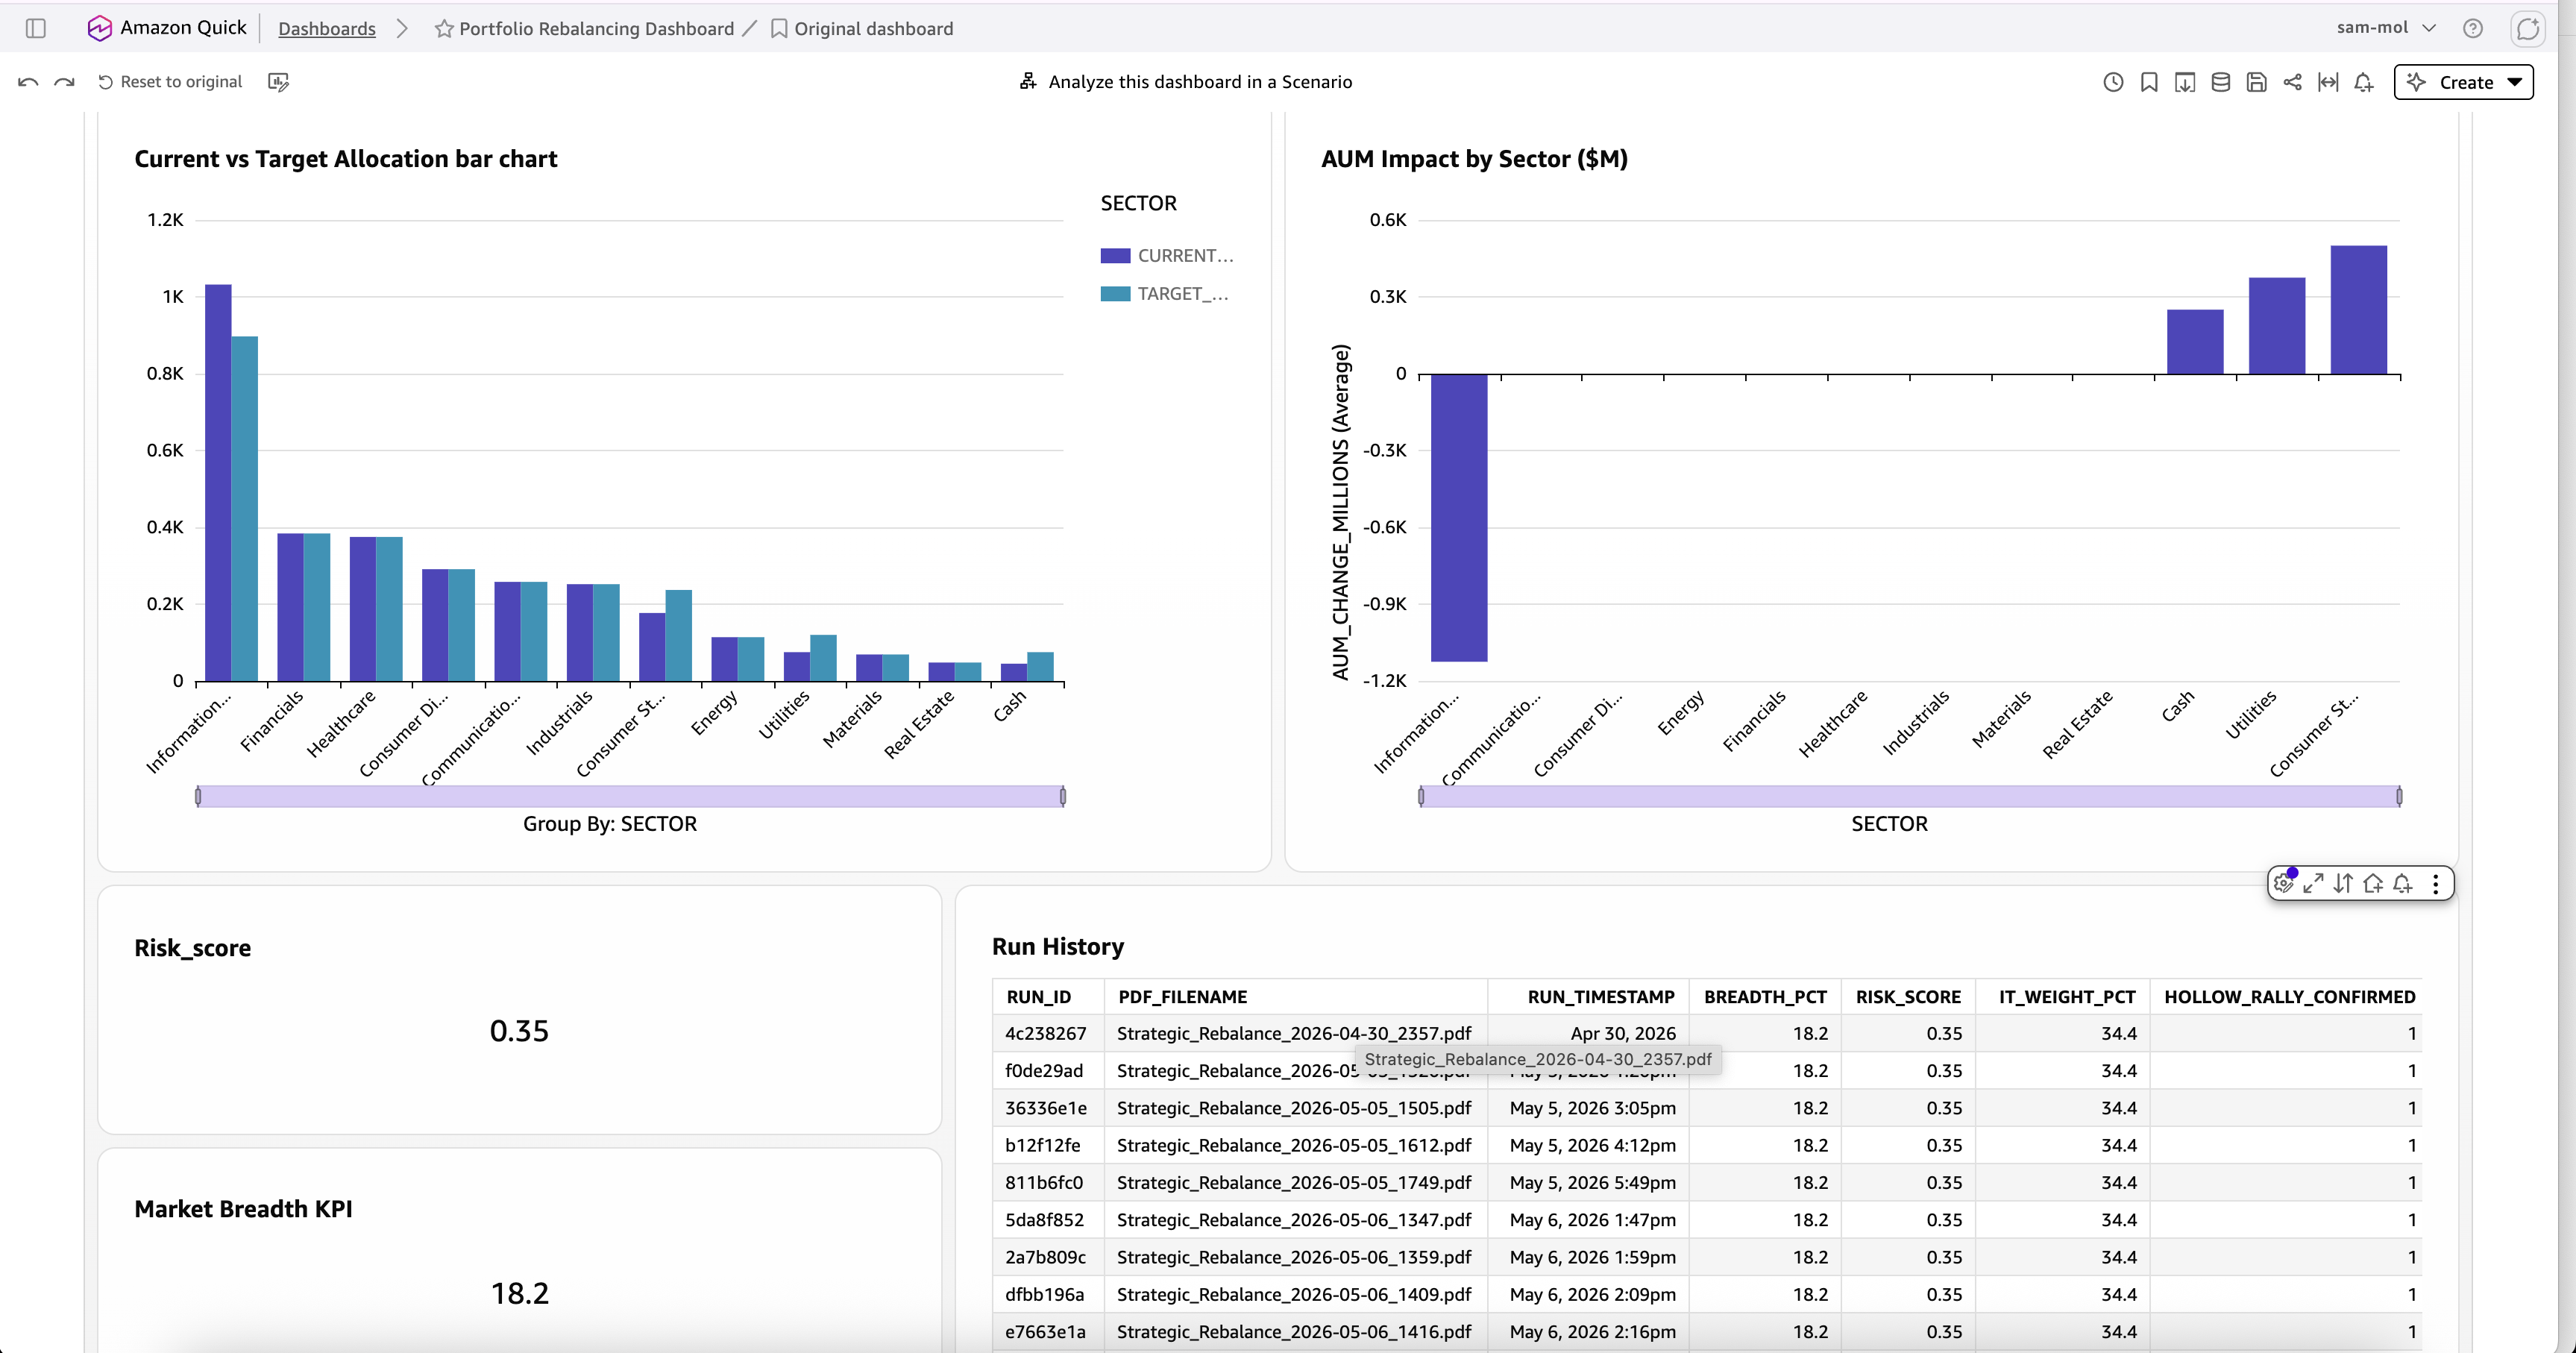
Gleichzeitig mit der Verteilung des Governance-Berichts aktualisiert Control-M das Amazon QuickSight-Dashboard, das mit den Snowflake-Governance-Tabellen verbunden ist. Das Dashboard wird nach jeder erfolgreichen Workflow-Ausführung automatisch aktualisiert und bietet den Betriebsteams die neuesten Portfolioanalysen und Governance-Kennzahlen.
Das Dashboard bietet eine operative Übersicht über das Portfolio, indem es Folgendes anzeigt:
- Aktuell vs. Zielallokation nach Sektor , was es den Nutzern ermöglicht, bestehende Portfoliogewichte mit der von der KI empfohlenen Allokation zu vergleichen.
- AUM-Auswirkung nach Sektor ($M) und hebt die prognostizierte Zunahme oder Verringerung der verwalteten Vermögenswerte für jeden Sektor basierend auf der empfohlenen Neuausrichtung hervor.
- Wichtige Portfolio-Risikoindikatoren, darunter Risk Score, Market Breadth KPI und IT-Weight Percentage, fassen die aktuellen Marktbedingungen zusammen, die während der Portfolioanalyse verwendet werden.
- Laufverlauf, der jede Workflow-Ausführung, den generierten Dateinamen, den Ausführungszeitstempel und wichtige Marktkennzahlen für historische Nachverfolgung und Prüfbarkeit zeigt.
Das Dashboard ergänzt den generierten PDF-Bericht, indem es eine interaktive operative Übersicht über Änderungen der Portfolio-Allokation, Marktindikatoren und die Workflow-Ausführungshistorie bietet.
Während das PDF als executive-ready Governance-Bericht für vierteljährliche Portfolio-Review-Meetings dient, ermöglicht das QuickSight-Dashboard den Operationsteams, Portfoliokennzahlen zu überwachen, Workflow-Ausführung zu validieren und historische Ergebnisse zu überprüfen.
Gemeinsam verwandeln sie KI-generierte Portfolio-Empfehlungen in umsetzbare operative Intelligenz.
Wichtige architektonische Entscheidungen
Entscheidung 1: Getrennte Bedrock-Argumentation von PDF-Generierung
Frühere Versionen des Workflows versuchten, PDF-Inhalte direkt durch die Bedrock Agent-Antwort zu leiten. Dies führte zu Binärdatenkorruption, wenn sie als Text behandelt wurden. Die endgültige Architektur konzentriert den Bedrock Agent ausschließlich auf das Schließen und die strukturierte JSON-Generierung, während eine dedizierte Lambda-Funktion die PDF-Generierung, das Diagrammrendering, die S3-Archivierung und die Snowflake-Persistenz übernimmt. Diese Trennung macht jede Komponente unabhängig testbar – ein entscheidender Vorteil bei der Iteration einer Produktions-Governance-Pipeline.
Entscheidung 2: S3-Beobachter als Synchronisationgatter
Selbst nachdem Bedrock Flow abgeschlossen ist, kann das generierte PDF noch über den nachgelagerten Lambda-Prozess hochgeladen werden. Das Auslösen der E-Mail-Verteilung sofort nach der Ausführung von Bedrock würde dazu führen, dass Lambda versucht, einen Bericht abzurufen, der noch nicht physisch in S3 gelandet ist. Der Control-M MFT Watch-only-Job löst dies, indem er den Pfad des S3-Berichts auf das passende PDF-Dateinamenmuster überwacht und erst nachgelagerte Jobs freigibt, sobald die Datei tatsächlich existiert. Dies verwandelt eine Rennbedingung in ein deterministisches Orchestrationsgatter.
Entscheidung 3: DataBrew als KI-taugliches Datengatter
KI-Agenten, die über unvollständige oder fehlgeleitete Governance-Daten argumentieren, scheitern natürlich nicht immer. Sie liefern selbstbewusst wirkende Empfehlungen, die auf unzuverlässigen Eingaben basieren. Die Platzierung von AWS DataBrew als explizite, KI-fähige Datenvalidierungsschicht vor der Ausführung von Bedrock stellt sicher, dass nur vollständige, strukturell gültige Governance-Snapshots die Argumentationsschicht erreichen. Wenn die Validierung fehlschlägt, stoppt der Workflow, bevor der Agent aufgerufen wird, wodurch verhindert wird, dass die Pipeline eine Governance-Empfehlung auf Basis fehlerhafter Daten erstellt und verteilt.
Sicherheitsaspekte
Diese Lösung implementiert Defense-in-Depth-Sicherheit in der gesamten Orchestrierungspipeline:
IAM-Least-Privileg-Zugang
- Bedrock Agent Rolle: Scoped to Bedrock:InvokeAgent und Bedrock:InvokeModel nur für Claude 3.5 Sonnet
- Lambda-Ausführungsrollen: Separate Rollen pro Funktion mit minimalem Zugriff auf S3, SES und Snowflake
- Control-M-Service-Rolle: IAM-Rolle mit sts:AssumeRole-Berechtigungen, auf spezifische Ressourcen-ARNs zugeschnitten
- Alle Daten in S3 werden im Ruhezustand mit von AWS KMS kundenverwalteten Schlüsseln verschlüsselt
- Daten im Transit, verschlüsselt über TLS 1.2+ zwischen allen Service-Endpunkten
- Die Snowflake-Verbindung verwendet eine verschlüsselte JDBC mit privater Verbindung, wo verfügbar,
- Vorsignierte S3-URLs für Berichtszugriff verfallen nach einer konfigurierbaren TTL (Standard: 72 Stunden)
Amazon Bedrock-Leitplanken
Für Produktionseinsätze empfehlen wir, Amazon Bedrock Guardrails so zu konfigurieren:
- Filterausgaben, die nicht dem erwarteten JSON-Schema entsprechen
- Blockantworten mit personenbezogenen Daten (PII)
- Verwenden Sie Inhaltsfilter, um Modellhalluzinationen über bestimmte Finanzinstrumente zu verhindern
- Protokollieren Sie alle Leitplankenmaßnahmen zu Prüfungszwecken
Überwachung und Beobachtbarkeit
Die Lösung bietet mehrschichtige Beobachtbarkeit:
Control-M-Überwachung
- Echtzeit-Sichtbarkeit der Workflow-Ausführung in der Control-M-Weboberfläche
- Abhängigkeitsbewusste Warnung: Wenn ein Upstream-Schritt fehlschlägt, werden Downstream-Schritte gehalten
- SLA-Management: Konfigurieren Sie zeitbasierte Alarme, wenn die gesamte Pipeline die erwartete Dauer überschreitet
- Historische Ausführungsberichte für Trendanalysen
Integration von AWS CloudWatch
- Lambda-Funktionsprotokolle und Metriken (Dauer, Fehler, Throttles) über Amazon CloudWatch
- Bedrock-Invocation-Metriken (Latenz, Tokennutzung, Throttling)
- S3-Ereignisbenachrichtigungen zur Objekterstellungsverfolgung
- Individuelle CloudWatch-Alarme für anomale Bedrock-Reaktionszeiten
Governance-Prüfungsspur
Jede Governance-Entscheidung wird in der Snowflake-DECISION_LOG-Tabelle mit Zeitstempeln, Konfidenzwerten, Modellversion und dem Input-Snapshot-Hash gespeichert. Dies bietet eine nachverfolgbare Audit-Spur für regulatorische Compliance und Modellleistungsverfolgung.
Was der komplette Workflow liefert
Wenn der Workflow am Ende eines Quartals ausgeführt wird, erhält der Investmentausschuss einen Governance-Bericht mit Analyse der Marktfragilität, historischen Stressbenchmarking, aktuellen versus Zielallokationsempfehlungen und KI-generierten Governance-Zusammenfassungen.
Gleichzeitig aktualisieren sich QuickSight-Dashboards automatisch, die Governance-Historie wird in Snowflake gespeichert und Control-M erfasst den Workflow-Lebenszyklus von Ende zu Ende.
Manuelles Eingreifen ist nicht erforderlich.
Und wenn etwas fehlschlägt – veraltete Governance-Daten, Validierungsprobleme, Probleme mit Bedrock-Quoten, Synchronisationsfehler oder nachgelagerte Lieferprobleme – stoppt der Workflow, bevor unzuverlässige Ergebnisse die Stakeholder erreichen.
So sieht die KI-Orchestrierung auf Produktionsniveau aus.
In Phase 3 haben wir eine automatisierte KI-Governance-Pipeline aufgebaut, die die Erstellung von Governance-Daten, KI-fähige Validierung, Bedrock-Argumentation, PDF-Berichtsgenerierung, operative Benachrichtigungen, Dashboard-Visualisierung und Snowflake-Persistenz umfasst – alles zuverlässig über Control-M orchestriert.
Durch die Integration von Amazon Bedrock Agents, Bedrock Flow, AWS DataBrew, Lambda, Amazon SES, Snowflake, Amazon QuickSight und Control-M wird KI-Governance zu einer verlässlichen operativen Fähigkeit und nicht zu einer experimentellen KI-Übung.
Das Ergebnis ist ein skalierbares Orchestrierungsmuster für Enterprise-KI-Governance-Workflows: Agenten begründen, Cloud-Services werden ausgeführt, und Control-M stellt sicher, dass der gesamte Prozess in der richtigen Reihenfolge mit Zuverlässigkeit, Sichtbarkeit, Prüfbarkeit und operativer Kontrolle läuft.
Um Ihnen den Einstieg zu erleichtern, haben wir den in dieser Lösung verwendeten Control-M-Workflow in einem öffentlichen GitHub-Repository veröffentlicht:
https://github.com/mol-bmc/bedrock-portfolio-rebalance
Das Repository umfasst derzeit:
- Der exportierte Control-M Job-Definitionen (jobs.json) für den End-to-End-Orchestrierungs-Workflow.
- Ein README mit grundlegenden Informationen zum Projekt.
Diese Assets bieten einen Ausgangspunkt, um zu verstehen, wie der Workflow mit Control-M orchestriert wird. Sie können die Workflow-Definitionen importieren und überprüfen und sie dann an Ihre eigene AWS-, Snowflake- und Amazon Bedrock-Umgebung anpassen, indem Sie Ihre eigenen Verbindungsprofile, IAM-Rollen, Cloud-Ressourcen und Datensätze konfigurieren.
Im Verlauf des Projekts können zusätzliche Implementierungs-Assets und unterstützende Beispiele dem Repository hinzugefügt werden.
Obwohl diese Implementierung einen KI-gesteuerten Anwendungsfall zur Portfolio-Neuausgleichung zeigt, kann das Orchestrierungsmuster auf viele Enterprise-KI-Workflows angewendet werden, die vertrauenswürdige Datenbereitung, Agentenlogik, Downstream-Automatisierung, Überwachung und Auditabilität erfordern.
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.