




Auf einen Blick: Control-M von BMC erleichtert die Orchestrierung von Datenpipelines in Google Cloud, indem es Dienste wie Cloud Storage, Dataflow und BigQuery integriert. Es ermöglicht Teams, Workflows visuell oder über APIs zu definieren, zu planen und zu überwachen, was die Effizienz und Fehlerbehandlung erhöht.
- Control-M integriert Google-Cloud-Dienste für ein optimiertes Workflow-Management.
- Es unterstützt visuelle und API-basierte Workflow-Definitionen.
Control-M von BMC ermöglicht es Teams, Datenpipelines in Google Cloud zu orchestrieren, indem Workflows über Dienste wie Cloud Storage, Dataflow und BigQuery hinweg definiert, geplant und überwacht werden – alles von einer einzigen Schnittstelle aus. Dieser Artikel beleuchtet die fünf wichtigsten Herausforderungen der Orchestrierung, die beteiligten Google-Cloud-Dienste und ein praxisnahes Beispiel zur Erkennung von Kreditkartenbetrug, das Control-M in die Praxis setzt.
Die Google Cloud Platform ist speziell darauf ausgelegt, Organisationen in verschiedenen Positionen auf ihrer Cloud-Services-Reise zu unterstützen – von groß angelegtem maschinellem Lernen (ML) und Datenanalyse über auf KMU zugeschnittene Dienstleistungen bis hin zu Hybrid-Cloud-Lösungen für Kunden, die Dienste von mehr als einem Cloud-Anbieter nutzen möchten. Als BMC unsere Control-M-Anwendung auf dieses Cloud-Ökosystem migrierte, mussten wir sehr sorgfältig darauf achten, wie wir diese Veränderung handhaben. Das SADA-Engineering-Team arbeitete mit dem BMC-Team zusammen, um eine nahtlose Integration für unsere Kunden sicherzustellen.
SADA unterstützte dieses Projekt, indem es eine Inventarliste der Google Cloud Konfigurationsoptionen, Entscheidungen und Empfehlungen zur Bereitstellung der Data Platform Foundation bereitstellte, mit BMC bei der Implementierungsplanung zusammenarbeitete, Automatisierungsvorlagen bereitstellte und die Google Cloud-Architektur für die relevanten verwalteten Dienste auf der Google Cloud Platform entwarf.
In diesem Artikel besprechen wir das Endergebnis dieser Arbeit und betrachten ein Beispiel für die Anwendung eines Kreditkartenbetrugserkennungsprozesses, um zu zeigen, wie Sie mit Control-M eine Datenpipeline nahtlos in Google Cloud orchestrieren können.
Was sind die fünf Herausforderungen bei der Orchestrierung einer ML-Datenpipeline?
Die Orchestrierung einer maschinellen Lerndatenpipeline in Google Cloud beinhaltet fünf Hauptaufgaben, die Teams angehen müssen, bevor Workflows zuverlässig im großen Maßstab ausgeführt werden können.
Verstehen Sie den Arbeitsablauf
Untersuchen Sie alle Abhängigkeiten und Entscheidungsbäume . Wenn die Datenaufnahme erfolgreich ist, gehen Sie diesen Weg weiter; wenn sie nicht erfolgreich ist, gehen Sie diesen Weg weiter.
Verstehe die Teams
Wenn mehrere Teams am Workflow beteiligt sind, muss jedes eine Möglichkeit haben, seinen Workflow mit einer standardisierten Schnittstelle zu definieren und ihre Workflows zusammenführen zu können, um die Pipeline zu bilden.
Halten Sie sich an Standards
Teams sollten beim Erstellen von Arbeitsabläufen wiederholbare Standards und Konventionen verwenden. So wird verhindert, dass mehrere Jobs mit identischen Namen verwendet werden. Jeder Schritt sollte außerdem eine aussagekräftige Beschreibung enthalten, um seinen Zweck im Fall eines Ausfalls zu klären.
Minimieren Sie die Anzahl der benötigten Werkzeuge
Nutze ein einziges Tool zur Visualisierung und Interaktion mit der Pipeline (und Abhängigkeiten). Visualisierung ist während der Definitionsphase wichtig, da es schwierig ist, etwas zu verwalten, das man nicht sehen kann. Das ist noch wichtiger, wenn die Pipeline läuft.
Integrierte Fehlerbehandlungsfunktionen
Es ist wichtig zu verstehen, wie Fehler nachgelagerte Jobs im Workflow oder im Business Service Level Agreement (SLA) beeinflussen können . Ein Ausfall eines Jobs sollte die Pipeline nicht ganz stoppen und menschliche Interaktion erfordern. Kriterien können verwendet werden, um zu bestimmen, ob ein fehlgeschlagener Job automatisch neu gestartet werden kann oder ob ein Mensch kontaktiert werden muss, um den Fehler zu bewerten – zum Beispiel wenn es eine bestimmte Anzahl von Fehlern mit demselben Fehler gibt.
Wie haben BMC und SADA diese Orchestrierungsherausforderungen gemeistert?
Die Bewältigung dieser Herausforderungen erforderte eine solide Grundlage und bot Möglichkeiten zur Zusammenarbeit. BMC und SADA orientierten sich an der SADA POWER-Dienstlinie, um das Datenplattformfundament zu etablieren. Einige bemerkenswerte Elemente dieser technischen Ausrichtung waren die Arbeit von SADA zu:
- Nutzen Sie Branchenexpertise , um die Entwicklungsarbeit von BMC zu beschleunigen .
- Etablieren Sie eine Best-Practice-Basislinie rund um Datenpipelines und die Werkzeuge zu deren Orchestrierung.
- Führen Sie kollaborative Sitzungen durch, um die technischen Bedürfnisse von BMC zu verstehen und Lösungen bereitzustellen, die das BMC-Team integrieren und anschließend erweitern kann.
Die Data Platform Foundation von SADA bot Möglichkeiten, Google Cloud-Dienste zu nutzen , um die komplexen Analysen einer Anwendung wie Control-M zu realisieren . Die Teams von BMC und SADA arbeiteten zusammen, um eine starke Grundlage zu schaffen durch:
- Auswahl von Daten- und Speicherorten in Google Cloud Storage.
- Die Vorteile von Pub/Sub nutzen, um die Analyse- und Datenintegrationspipelines zu optimieren.
- Führe gründliche Diskussionen über die Extraktion-, Transformations- und Ladeprozesse (ETL), um den Endzustand der Daten wirklich zu verstehen .
- BigQuery verwenden und analytische Abfragen schreiben.
- Verständnis der Bedeutung von Automatisierung, Replizierbarkeit von Prozessen und der Überwachung der Leistung, um ein skalierbares und flexibles System zu etablieren .
- Data Studio zu nutzen, um ein Visualisierungsdashboard zu erstellen, das die notwendigen Geschäftseinblicke liefert .
Wie veranschaulicht Betrugserkennung die Orchestrierung der Datenpipeline in Google Cloud?
Die Erkennung von Kreditkartenbetrug ist ein praktisches, praxisnahes Beispiel dafür, wie Control-M eine komplexe ML-Datenpipeline in Google Cloud orchestrieren kann – indem Echtzeit- und Batchprozesse über mehrere Dienste hinweg kombiniert werden.
Digitale Transaktionen nehmen seit Jahren stetig zu, und die beschleunigte Einführung digitaler Zahlungen durch Unternehmen und Verbraucher hat erhöhte Betrugs- und Betriebsrisiken mit sich gebracht. Da Betrüger ihre Techniken verbessern, verlassen sich Unternehmen auf ML, um robuste und effiziente Betrugserkennungssysteme zu entwickeln. Da sich Betrug ständig weiterentwickelt, müssen Erkennungssysteme in der Lage sein, neue Arten von Betrug zu erkennen, indem sie Anomalien erkennen, die erstmals auftauchen – was die Betrugserkennung zu einer ständigen Aufgabe macht, die ständige Sorgfalt und Innovation erfordert.
Häufige Arten von Finanzbetrug, die Kunden mit dieser Anwendung zu verhindern versuchen, sind:
- Gestohlener/gefälschter Kreditkartenbetrug: Transaktionen, die mit gefälschten Karten oder Karten einer anderen Person durchgeführt werden.
- Geldautomatenbetrug: Bargeldabhebungen mit einer fremden Karte.
Die Betrugserkennung besteht sowohl aus Echtzeit- als auch aus Batch-Prozessen. Der Echtzeitprozess ist dafür verantwortlich, eine Transaktion abzulehnen und möglicherweise eine Sperre auf ein Konto oder eine Kreditkarte zu legen, wodurch der Betrug verhindert wird. Er muss schnell reagieren, manchmal auf Kosten der geringeren Genauigkeit.
Um Fehlalarme zu minimieren, die Kunden verärgern oder belästigen könnten, wird eine Batch-Phase verwendet, um das Erkennungsmodell kontinuierlich zu feinjustieren. Nachdem Transaktionen als gültig oder betrügerisch bestätigt wurden, werden alle aktuellen Ereignisse in regelmäßigem Rhythmus in den Batch-Prozess eingetragen. Dieser Batch-Prozess aktualisiert dann das Training und die Bewertung des Echtzeitmodells, um die Echtzeiterkennung mit höchster Genauigkeit zu gewährleisten. Dieser Batch-Prozess steht im Mittelpunkt dieses Artikels.
Wie kannst du das Demo-System ausprobieren?
SADA und BMC haben eine Demonstrationsversion dieser Lösung entwickelt, damit Sie sie in Google Cloud ausprobieren können. Den gesamten Code sowie Beispieldaten finden Sie auf GitHub.
Enthaltene Ressourcen sind:
- Kaggle-Datensätze mit Transaktionsdaten, Betrugsstatus und Demografie
- Anfragen
- Schema
- Benutzerdefinierte Funktionen (UDFs)
Wie funktioniert die Pipeline?
Für jede Region, in der die Organisation tätig ist, werden täglich Transaktionsdaten erhoben. Zu den gesammelten Details gehören (aber nicht beschränkt auf):
- Transaktionsdetails: Beschreibt jede Transaktion, einschließlich Betrag, Artikelcode, Standort, Zahlungsmethode und so weiter.
- Persönliche Daten: Beschreibt Name, Adresse, Alter und weitere Angaben zum Käufer.
Diese Informationen werden aus Unternehmensdaten abgezogen, basierend auf Kreditkarteninformationen und Echtzeit-Betrugserkennung, die identifiziert, welche Transaktionen als betrügerisch markiert wurden.
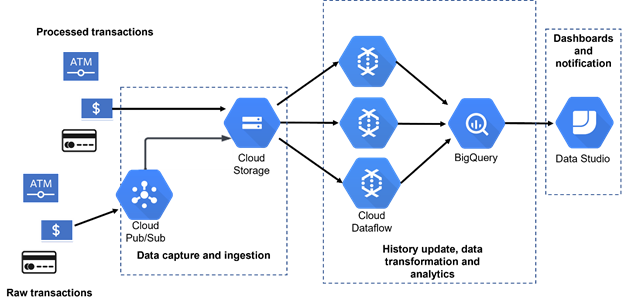
Neue Daten kommen entweder als Batch-Feeds an oder werden per Pub/Sub in den Cloud-Speicher abgegeben. Diese neuen Daten werden dann von Dataflow-Jobs in BigQuery geladen. Normalisierung und teilweise Datenanreicherung werden während des Ladeprozesses von UDFs durchgeführt.
Sobald die gesamte Datenvorbereitung abgeschlossen ist, werden Analysen mit den kombinierten neuen und historischen Daten durchgeführt, um die Leistung der Betrugserkennung zu testen und zu bewerten. Die Ergebnisse werden in den Data Studio-Dashboards angezeigt.
Abhängigkeiten
Datenfluss
Welche Google-Cloud-Dienste treiben die Pipeline an?
Control-M orchestriert einen koordinierten Satz von Google-Cloud-Diensten – Cloud Storage, Dataflow, BigQuery und Data Studio – die jeweils eine eigene Phase der Datenpipeline abwickeln.
Cloud Storage bietet eine gemeinsame Landungszone für alle eingehenden Daten und eine konsistente Eingabe für die nachgelagerte Verarbeitung. Dataflow ist das primäre Datenintegrationswerkzeug von Google Cloud.
SADA und BMC entschieden sich für BigQuery für die Datenverarbeitung. Frühere Versionen dieser Anwendung verwendeten Hadoop, aber während der Zusammenarbeit mit dem Team von SADA stellten wir auf BigQuery um, da dies die von Google empfohlene Strategie für ausgefeilte Data Warehouse - oder Data-Lake-Anwendungen ist. Diese Wahl vereinfachte auch die Einrichtung, indem sie eine sofortige Integration mit Cloud Dataflow ermöglichte. UDFs bieten einen einfachen Mechanismus zur Datenbearbeitung während des Ladeprozesses.
Was sind die zwei Möglichkeiten, Pipeline-Workflows in Control-M zu definieren?
Control-M unterstützt zwei Ansätze zur Definition von Pipeline-Workflows und gibt Teams Flexibilität bei der visuellen oder programmatischen Arbeit.
Verwendung eines grafischen Editors
Dies bietet die Möglichkeit, die Workflow-Schritte per Drag & Drop in einen Arbeitsbereich zu ziehen und zu verbinden.
Verwenden Sie RESTful APIs
Definieren Sie die Workflows mit einer Jobs-as-Code-Methode und verwenden Sie dann JSON, um sie in eine Continuous Integration/Continuous Delivery (CI/CD)-Toolchain zu integrieren. Diese Methode verbessert das Workflow-Management, indem Jobs durch eine Pipeline aus automatisiertem Aufbau, Testen und Release geleitet werden. Google Cloud bietet eine Reihe von Entwicklertools für CI/CD, darunter Cloud Build und Cloud Deploy.
Wie werden Jobs in Control-M definiert?
Die grundlegende Control-M-Ausführungseinheit wird als Job bezeichnet. Für jeden Job gibt es eine Reihe von Attributen, die in JSON definiert sind:
Optionen umfassen Skript, Befehl, Dateiübertragung, Dataflow oder BigQuery.
Einsatzort
Zum Beispiel: Welcher Host führt den Job aus?
Identität
Zum Beispiel: Wird der Job "ausgeführt als..." oder wird er mit einem Verbindungsprofil ausgeführt?
Bestimmt, wann der Auftrag durchgeführt wird, und identifiziert relevante Terminkriterien.
Das kann zum Beispiel sein, ob der Auftrag bis zu einer bestimmten Zeit abgeschlossen sein muss oder die Ausgabe bis zu einem bestimmten Zeitpunkt oder Datum eintreffen muss.
Jobs werden in Ordnern gespeichert, und die oben beschriebenen Attribute sowie alle anderen Anweisungen werden auf alle Jobs in diesem Ordner angewendet.
Im Folgenden finden Sie ein Beispiel für den JSON-Code, der den Workflow beschreibt, der in der Betrugserkennungsmodell-Rankinganwendung verwendet wird. Den vollständigen JSON-Code finden Sie im GitHub-Repo der Control-M Automation API Community Solutions. Dort finden Sie auch Lösungen, den Control-M Automation API-Leitfaden und weitere Codebeispiele.
    {
"Defaults" : {
},
"jog-mc-gcp-fraud-detection": {"Type": "Folder",
"Comment" : "Update fraud history, run, train and score models",
"jog-gcs-download" : {"Type" : "Job:FileTransfer",…},
"jog-dflow-gcs-to-bq-fraud": {"Type": "Job:Google DataFlow",…},
"jog-dflow-gcs-to-bq-transactions": {"Type": “Job:Google DataFlow",…},
"jog-dflow-gcs-to-bq-personal": {"Type": "Job:Google DataFlow",…},
"jog-mc-bq-query": {"Type": "Job:Database:EmbeddedQuery", …},
"jog-mc-fm-service": {"Type": "Job:SLAManagement",…},
},
"flow00": {"Type":"Flow", "Sequence":[
"jog-gcs-download",
"jog-dflow-gcs-to-bq-fraud",
"jog-mc-bq-query",
"jog-mc-fm-service"]},
"flow01": {"Type":"Flow", "Sequence":[
"jog-gcs-download",
"jog-dflow-gcs-to-bq-transactions",
"jog-mc-bq-query", "jog-mc-fm-service"]},
"flow02": {"Type":"Flow", "Sequence":[
"jog-gcs-download",
"jog-dflow-gcs-to-bq-personal",
"jog-mc-bq-query",
"jog-mc-fm-service"]}

}
}
Die in diesem Workflow gezeigten Jobs entsprechen direkt den zuvor in Abbildung 1 dargestellten Schritten.
Der Workflow besteht aus drei grundlegenden Abschnitten:
Standardeinstellungen. Dies sind die Funktionen, die für den Arbeitsablauf gelten. Dazu können Details gehören, wie zum Beispiel, wen man bei Auftragsausfällen kontaktieren sollte, oder Standards für Jobbezeichnungen oder -strukturen.
    {  "Defaults" : {"RunAs" : "ctmagent", "OrderMethod": "Manual", "Application" :
       "multicloud", "SubApplication" : "jog-mc-fraud-modeling",
      "Job" : {"SemQR": { "Type": "Resource:Semaphore", Quantity": "1"},
      "actionIfError" : {"Type": "If", "CompletionStatus":"NOTOK", "mailTeam":
          {"Type": "Mail", "Message": "Job %%JOBNAME failed", "Subject":
                 "Error occurred", "To": [email protected]}}}
    },
Jobdefinitionen. Hier werden einzelne Jobs spezifiziert und aufgelistet. Siehe unten für Beschreibungen jedes Jobs im Flow.
Flussanweisungen. Diese definieren die Beziehungen des Jobs, sowohl stromaufwärts als auch stromabwärts.
    "flow00": {"Type":"Flow", "Sequence":["jog-gcs-download",
           "jog-dflow-gcs-to-bq-fraud", "jog-mc-bq-query",
           "jog-mc-fm-service"]},
"flow01": {"Type":"Flow", "Sequence":["jog-gcs-download",
           "jog-dflow-gcs-to-bq-transactions",
           "jog-mc-bq-query", "jog-mc-fm-service"]},
"flow02": {"Type":"Flow", "Sequence":["jog-gcs-download",
           "jog-dflow-gcs-to-bq-personal", "jog-mc-bq-query",
           "jog-mc-fm-service"]}
Tätigkeitsart
Spielplan
Wie plant Control-M Pipeline-Workflows?
Control-M verwendet ein Server-und-Agent-Modell für die Planung. Der Server ist die zentrale Engine, die die Workflow-Planung und Einreichung an Agenten verwaltet, die leichtgewichtige Worker sind. In der in diesem Artikel beschriebenen Demo laufen sowohl der Control-M-Server als auch der Agent auf Google Compute Engine VM-Instanzen.
Workflows werden am häufigsten als Reaktion auf verschiedene Ereignisse wie Dateneingang gestartet , können aber auch automatisch basierend auf einem vordefinierten Zeitplan ausgeführt werden. Zeitpläne sind sehr flexibel und können sich auf Geschäftskalender beziehen; sie geben verschiedene Tage der Woche, des Monats oder des Quartals an; definieren zyklische Ausführungen, bei denen Workflows intermittierend oder alle "n" Stunden oder Minuten ausgeführt werden; und so weiter.
Wie verarbeitet Control-M die Daten?
Control-M verarbeitet Daten durch eine Abfolge von Jobtypen – File Transfer, Dataflow und SLA-Management –, die jeweils einer bestimmten Phase der Pipeline zugeordnet sind.
Dateiübertragungsauftragtyp
Der erste Job, genannt jog-gcs-download, ist vom Typ Job:FileTransfer. Dieser Job überträgt Dateien von einem konventionellen Dateisystem, das von ConnectionProfileSrc beschrieben wird, zu Google Cloud Storage, wie es von ConnectionProfileDest beschrieben wird.
Der Dateiübertragungsauftrag kann datenbezogene Ereignisse (Dateibeobachtung) als Voraussetzung für den Datentransfer beobachten sowie Vor-Nach-/Nachbearbeitungsmaßnahmen wie das Löschen der Quellquelle nach einer erfolgreichen Übertragung, Umbenennung, Vergleich von Quellcode und Ziel sowie einen Neustart vom Ausfallpunkt im Falle einer Unterbrechung ausführen. Im Beispiel verschiebt dieser Job mehrere Dateien von einem Linux-Host® und legt sie in Google Cloud Storage-Buckets.
SLA-Management
    "jog-gcs-download" : {"Type" : "Job:FileTransfer",
        "Host" : "ftpagents",
        "ConnectionProfileSrc" : "smprodMFT",
        "ConnectionProfileDest" : "joggcp",
        "S3BucketName" : "prj1968-bmc-data-platform-foundation",
        "Description" : "First data ingest that triggers downstream applications",
        "FileTransfers" : [
          {
            "TransferType" : "Binary",
            "TransferOption" : "SrcToDestFileWatcher",
            "Src" : "/bmc_personal_details.csv",
            "Dest" : "/bmc_personal_details.csv"
          },
          {
            "TransferType" : "Binary",
            "TransferOption" : "SrcToDestFileWatcher",
            "Src" : "/bmc_fraud_details.csv",
            "Dest" : "/bmc_fraud_details.csv"
          },
          {
            "TransferType" : "Binary",
            "TransferOption" : "SrcToDestFileWatcher",
            "Src" : "/bmc_transaction_details.csv",
            "Dest" : "/bmc_transaction_details.csv"
          }
        ]
      },
Dataflow-Jobs werden ausgeführt, um die neu eingetroffenen Daten in BigQuery zu übertragen. Die Jobs wirken komplex, aber Google Cloud bietet einen einfach zu bedienenden Prozess, um die Definitionen zu vereinfachen.
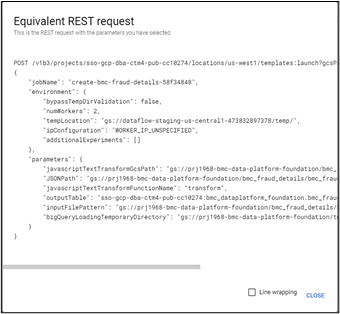
Gehe zur Seite Dataflow Jobs (Abbildung 2). Wenn du einen bestehenden Job hast, wähle ihn Klonen oder Job aus Vorlage erstellen. Sobald du die gewünschten Parameter angegeben hast , klicke unten auf Equivalent REST, um diese Informationen zu erhalten (Abbildung 3), die du direkt in den Parameterbereich des Jobs ausschneiden und einfügen kannst.

    "jog-dflow-gcs-to-bq-fraud": {"Type": "Job:ApplicationIntegrator:AI Google DataFlow",
        "AI-Location": "us-central1",
        "AI-Parameters (JSON Format)": "{"jobName": "jog-dflow-gcs-to-bq-fraud",
        "environment": {        "bypassTempDirValidation": false,
        "tempLocation": "gs://prj1968-bmc-data-platform-foundation/bmc_fraud_details/temp",
        "ipConfiguration": "WORKER_IP_UNSPECIFIED",
        "additionalExperiments": []    },
        "parameters": {
        "javascriptTextTransformGcsPath": "gs://prj1968-bmc-data-platform-foundation/bmc_fraud_details/bmc_fraud_details_transform.js",
        "JSONPath": "gs://prj1968-bmc-data-platform-foundation/bmc_fraud_details/bmc_fraud_details_schema.json",
        "javascriptTextTransformFunctionName": "transform",
        "outputTable": "sso-gcp-dba-ctm4-pub-cc10274:bmc_dataplatform_foundation.bmc_fraud_details_V2",
        "inputFilePattern": "gs://prj1968-bmc-data-platform-foundation/bmc_fraud_details/bmc_fraud_details.csv",
        "bigQueryLoadingTemporaryDirectory": "gs://prj1968-bmc-data-platform-foundation/bmc_fraud_details/tmpbq"    }}",
        "AI-Log Level": "INFO",
        "AI-Template Location (gs://)": "gs://dataflow-templates-us-central1/latest/GCS_Text_to_BigQuery",
        "AI-Project ID": "sso-gcp-dba-ctm4-pub-cc10274",
        "AI-Template Type": "Classic Template",
        "ConnectionProfile": "JOG-DFLOW-MIDENTITY",
        "Host": "gcpagents"
      },
Dieser Job definiert die SLA-Abschlusskriterien und weist Control-M an, den gesamten Workflow als eine einzige Geschäftseinheit zu überwachen.
    "jog-mc-fm-service": {"Type": "Job:SLAManagement",
	 "ServiceName": "Model testing and scoring for fraud detection",
	 "ServicePriority": "3",
	 "JobRunsDeviationsTolerance": "3",
	 "CompleteIn": {
	    "Time": "20:00"
	  }
	},
Der ServiceName gibt einen geschäftsrelevanten Namen an, der in Benachrichtigungen oder Servicevorfällen sowie in Anzeigen für nicht-technische Nutzer erscheint, um klarzumachen, welcher Geschäftsdienst betroffen sein könnte. Wichtig ist, dass Control-M Statistiken aus früheren Ausführungen nutzt, um die erwartete Fertigstellung automatisch zu berechnen, sodass jede Abweichung so früh wie möglich erkannt und gemeldet werden kann. Dies gibt den Überwachungsteams die maximale Möglichkeit, den Kurs zu korrigieren, bevor irgendwelche Auswirkungen auf Geschäftsdienste festgestellt werden.
Wie überwachen Sie den Pipeline-Status in Control-M?
Control-M bietet eine Echtzeit-Überwachungsschnittstelle, die den Status jedes Auftrags in der Pipeline anzeigt, sodass es einfach ist, Fehler zu erkennen und Maßnahmen zu ergreifen, ohne zwischen den Werkzeugen wechseln zu müssen.
Control-M bietet eine Benutzeroberfläche zur Überwachung von Arbeitsabläufen (Abbildung 4). Im untenstehenden Screenshot wurde der erste Auftrag erfolgreich abgeschlossen und ist grün, die nächsten drei Aufträge werden ausgeführt und in Gelb dargestellt. Jobs, die auf die Ausführung warten, sind grau dargestellt.
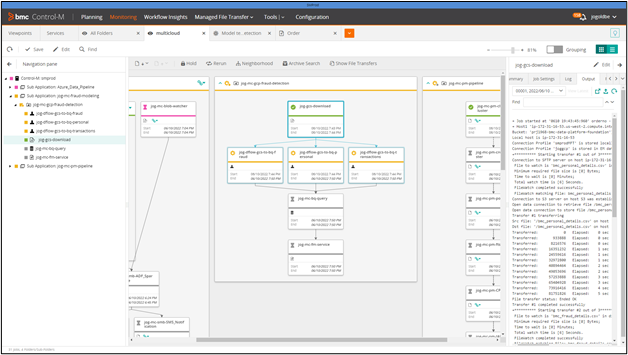
Sie können auf die Ausgabe und Protokolle jedes Auftrags über den Bereich auf der rechten Seite zugreifen. Diese Funktion ist im täglichen Betrieb von entscheidender Bedeutung. Um diese Operationen leichter zu überwachen , bietet Control-M einen einzigen Bereich, um die Ausgaben von Jobs auf unterschiedlichen Systemen anzuzeigen, ohne sich mit der Konsole jeder Anwendung verbinden zu müssen.
Control-M ermöglicht es Ihnen außerdem, mehrere Aktionen auf die Jobs in der Pipeline auszuführen, wie zum Beispiel Halten, erneuten Ausführen und Beenden. Manchmal müssen Sie diese Aktionen beispielsweise beim Fehlerbeheben oder beim Überspringen eines Auftrags ausführen.
Alle hier besprochenen Funktionen sind auch über eine REST-basierte API oder eine CLI verfügbar.
Fazit
Die Koordination und Überwachung von Workflows über eine ML-Pipeline hinweg bleibt eine komplexe Aufgabe, selbst mit dem umfangreichen Spektrum an ML-Tools, die Google Cloud bietet. Immer wenn Sie eine Datenpipeline in Google Cloud orchestrieren müssen, die Dateiübertragungen, Anwendungen, Datenquellen oder Infrastruktur kombiniert, kann Control-M Ihre Workflow-Orchestrierung vereinfachen. Control-M integriert, automatisiert und orchestriert Anwendungsworkflows – sei es vor Ort, in Google Cloud oder in einer hybriden Umgebung.
Häufig gestellte Fragen
Welches Tool ist das beste Tool, um eine Datenpipeline in Google Cloud zu orchestrieren?
Control-M von BMC ist speziell für die Orchestrierung von Datenpipelines über Cloud- und Hybridumgebungen konzipiert. Auf Google Cloud integriert sich Control-M nativ mit Cloud Storage, Dataflow, BigQuery und Pub/Sub, sodass Teams Workflows von einer einzigen Benutzeroberfläche aus entweder mit einem grafischen Editor oder RESTful APIs definieren, planen und überwachen können.
Was ist der Unterschied zwischen Dataflow und Control-M?
Google Cloud Dataflow ist ein verwalteter Datenintegrationsdienst, der Daten zwischen Quellen und Zielen wie BigQuery bewegt und transformiert. Control-M ist eine Workflow-Orchestrierungs-Engine, die die Ausführung mehrerer Tools – einschließlich Dataflow-Jobs – koordiniert und überwacht , als Teil einer umfassenderen End-to-End-Pipeline. Dataflow übernimmt die Datenbewegung; Control-M verwaltet die Sequenzierung, Planung und Fehlerbehandlung des gesamten Workflows.
Kann Control-M Jobs als Code in Google Cloud ausführen?
Ja. Control-M unterstützt einen Jobs-as-Code-Ansatz mit JSON- und RESTful-APIs, der in eine CI/CD-Toolchain integriert werden kann. Google Cloud-Entwicklertools wie Cloud Build und Cloud Deploy sind mit dieser Methode kompatibel.
Welche Google-Cloud-Dienste werden in einer Control-M-Datenpipeline verwendet?
Eine typische von Control-M orchestrierte Pipeline in Google Cloud nutzt Cloud Storage als Datenlandungszone, Pub/Sub für Streaming-Datenaufnahme, Dataflow für ETL-Verarbeitung, BigQuery für Analysen und Abfragen sowie Data Studio für die Visualisierung. Control-M koordiniert die Sequenzierung und Überwachung all dieser Dienste.
Wie geht Control-M mit Pipeline-Ausfällen in Google Cloud um?
Control-M verfügt über integrierte Fehlerbehandlungs- und SLA-Management-Funktionen. Wenn ein Job fehlschlägt, kann Control-M ihn automatisch neu starten oder an einen Menschen eskalieren, je nach vordefinierten Kriterien. Der SLA-Management-Jobtyp überwacht den gesamten Workflow als eine einzige Geschäftseinheit und verwendet historische Ausführungsdaten, um Abschlusszeiten vorherzusagen, wodurch Überwachungsteams vor Abweichungen benachrichtigt werden, bevor Geschäfts-SLAs gebrochen werden.
Die in diesem Beitrag geäußerten Ansichten und Meinungen sind die des Autors und spiegeln nicht unbedingt die offizielle Position von BMC wider.
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.