




Auf einen Blick: Einzelhändler können maschinelle Lern-Workflows für Verkaufsprognosen und Bestandsmanagement mit Azure Databricks und Control-M für die Orchestrierung implementieren. Der Leitfaden beschreibt die Integration von ML-Modellen, Datenerfassung und effizientes Workflow-Management.
- ML-Techniken wie Random Forest und lineare Regression werden für Vorhersagen angewandt.
- Control-M koordiniert die Datenverarbeitung und -planung für ein effektives Workflow-Management.
Die Vorhersage von Point-of-Sale-(POS)-Verkäufen in Geschäften, koordiniert mit Lagerbestands- und Lieferkettendaten, ist für Einzelhändler ein Tabelleneinsatz. Dieser Blog erklärt diesen Anwendungsfall unter Nutzung von PySpark für Daten- und Machine Learning-(ML)-Pipelines auf Databricks, orchestriert mit Control-M, um POS vorherzusagen und Bestandsartikel vorherzusagen. Dieser Blog besteht aus zwei Hauptteilen. Im ersten Abschnitt behandeln wir die Details eines Einzelhandelsprognose-Anwendungsfalls und der ML-Pipeline, die in Azure Databricks definiert ist. Der zweite Abschnitt behandelt die Integration zwischen Control-M und Databricks.
Entwicklung des Anwendungsfalls in Azure Databricks
Hinweis: Der gesamte in diesem Blog verwendete Code ist in diesem GitHub-Repository verfügbar.
In der Realität würden Daten von Sensoren und mobilen Geräten aufgenommen, mit nahezu Echtzeit-Bestandsmessungen und POS-Daten über Filialen hinweg. Die Daten- und ML-Pipeline wird mit Control-M koordiniert, um die verschiedenen Komponenten zu integrieren und die Ergebnisse in einem stets aktualisierten Dashboard zu visualisieren.
Die Daten landen in der Databricks Intelligent Data Platform und werden kombiniert, angereichert und mit PySpark-Jobs aggregiert. Die resultierenden Daten werden verschiedenen prädiktiven Algorithmen zur Schulung und Prognose von Umsatz und Nachfrage zugeführt, wobei die Ergebnisse visualisiert sind in:
- Grafische Dashboards
- Geschrieben als Delta-Dateien in ein Datenrepository für den Offline-Konsum
In diesem Beitrag werden wir auch die Architektur und die Komponenten dieses prädiktiven Systems durchgehen.
Datensatz und Schema
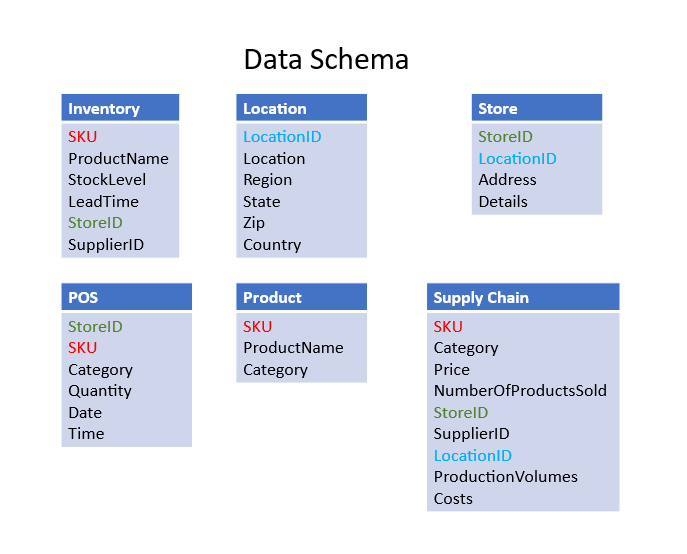
Das Projekt verwendet reale Daten, die in Größe und Breite gekürzt sind, um die Dinge einfach zu halten. Eine vereinfachte und gekürzte Version des Schemas ist in Abbildung 1 dargestellt. Die Standorttabelle ist eine Referenztabelle, die aus öffentlichen Datensätzen gewonnen wird. Die Farbcodierung der Felder zeigt die Abhängigkeiten zwischen den Tabellen. Die Daten wurden teilweise aus Kaggle und anderen öffentlichen Quellen bezogen.
Plattform und Komponenten
Für die Implementierung des Anwendungsfalls werden folgende Komponenten verwendet:
- Databricks Intelligent Data Platform on Azure
- PySpark
- Python Pandas-Bibliothek
- Python Seaborn-Bibliothek für Datenvisualisierung
- Jupyter-Notizbücher auf Databricks
- Parquet- und Delta-Dateiformat
Projektartefakte
- Arbeitsumgebung auf Azure
- Code für Datenerfassung, -verarbeitung, ML-Training sowie das Bereitstellen und Speichern der prognostizierten Ergebnisse in Databricks Lakehouse im Delta-Format
- Code für Workflow und Orchestrierung mit Control-M, um alle Aktivitäten und Aufgaben zu koordinieren und Ausfallszenarien zu bewältigen
Architektur auf hoher Ebene und Datenfluss
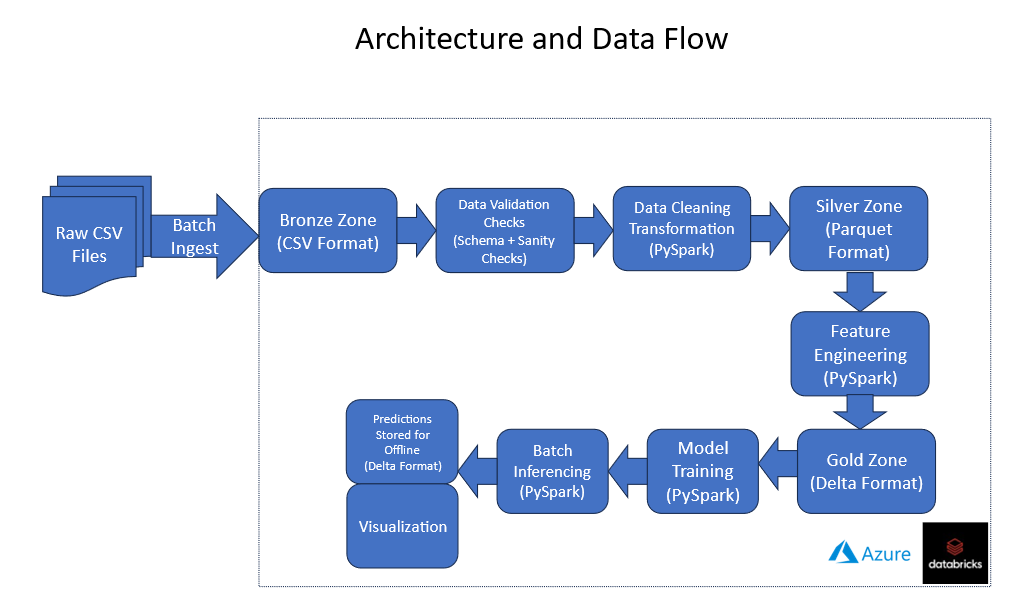
Die aktuelle Architektur geht davon aus, dass die Daten als CSV-Datei mit einem vordefinierten Schema als Batch in die Rohzone des Data Lakehouse landen. Der übergeordnete Überblick über den Datenfluss und die zugehörigen Prozesse ist in Abbildung 2 dargestellt.
Daten- und Feature-Engineering
Derzeit werden die Daten- und ML-Pipelines als Batch-Prozess modelliert. Eine anfängliche explorative Datenanalyse (EDA) wurde durchgeführt, um die Datensätze und relevanten Attribute zu verstehen, die zur Vorhersage der Lagerbestände und POS-Verkäufe beitragen. Die erste EDA zeigte an, dass es nützlich ist, die Daten in "Wochentag"- und "Tageszeit"-Kategorien umzuwandeln, um die besten prädiktiven Ergebnisse zu erzielen. Die Datenpipelines enthielten Feature-Engineering-Funktionen für Datensätze, die Zeit als Teil des größeren Datensatzes hatten.
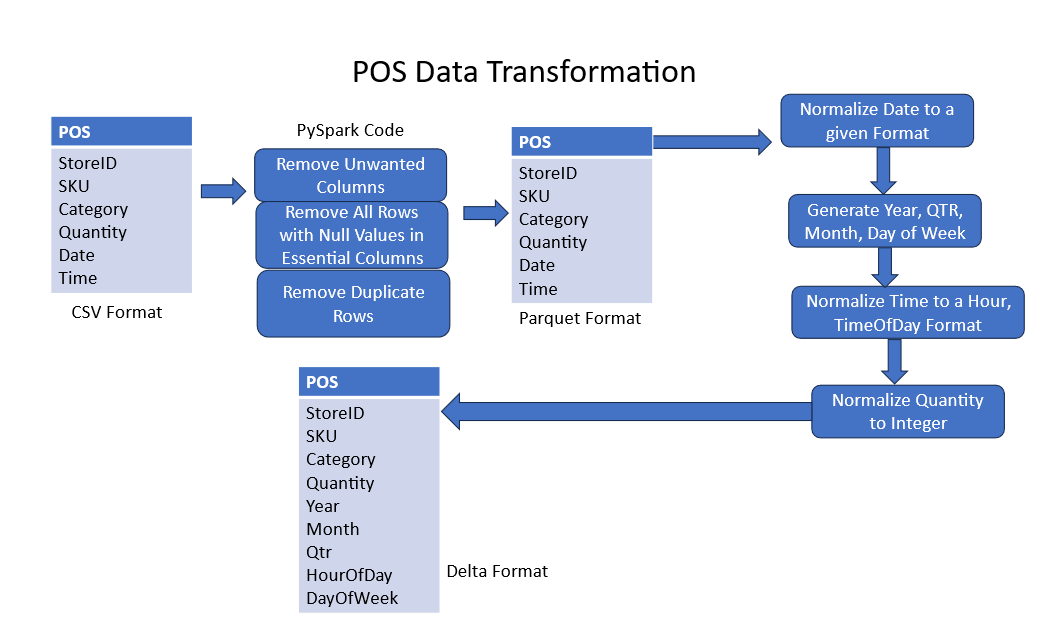
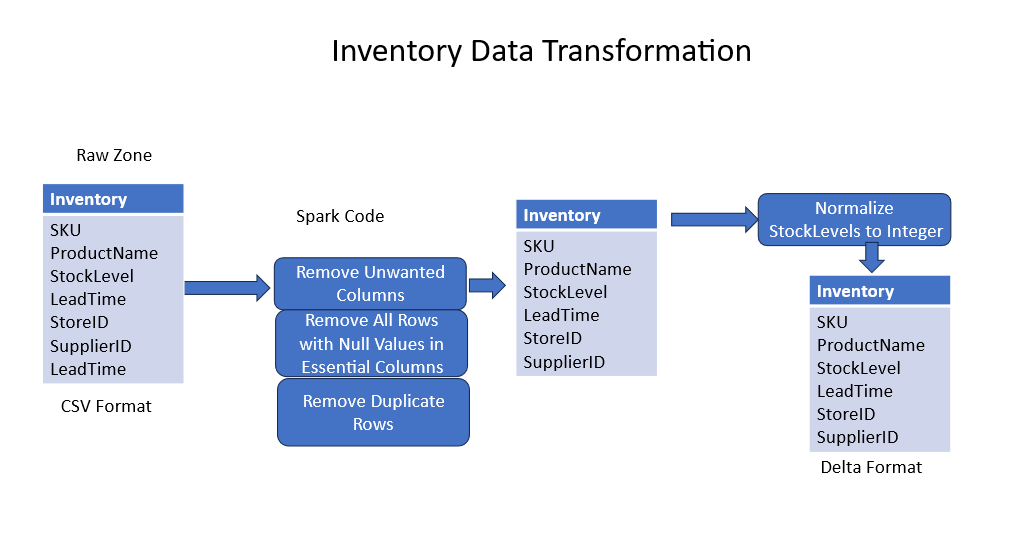
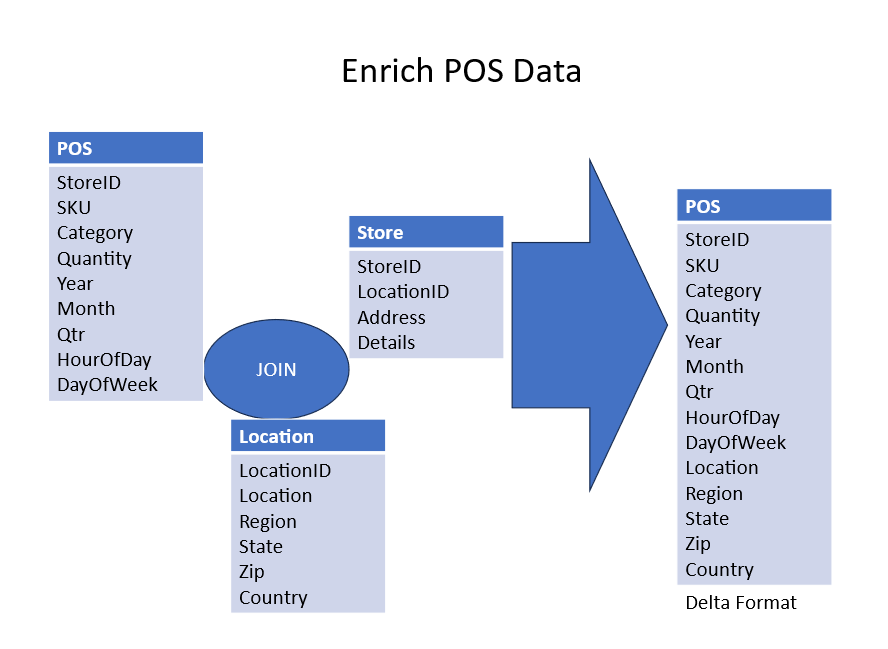
Abbildung 3 zeigt eine Beispieldatenpipeline für den POS-Datensatz. Abbildung 4 zeigt eine weitere ähnliche Datenpipeline für einen Bestandsdatensatz. Nach der Datentransformation wurden die transformierten Tabellen zu einer denormalisierten Tabelle für das Modelltraining zusammengeführt. Dies ist in Abbildung 5 zur Anreicherung des POS- und Bestandsdatensatzes dargestellt.
Modelltraining
Die ML-Trainingspipeline verwendete Random Forest und lineare Regression, um die Verkaufs- und Lagerbestandsniveaus vorherzusagen. Die folgenden Module von PySpark wurden verwendet, um die ML-Pipeline zu erstellen und One-Hot-Codierung der kategorialen Variablen durchzuführen.
- pyspark.ml.Pipeline
- pyspark.ml.feature.StringIndexer, OneHotEncoder
- pyspark.ml.feature.VectorAssembler
- pyspark.ml.feature.StandardScaler
- pyspark.ml.regression.RandomForestRegressor
- pyspark.ml.evaluation.RegressionEvaluator
- pyspark.ml.regression.LinearRegression
Die angereicherten Daten wurden an die Pipelines weitergegeben und die verschiedenen Regressormodelle wurden auf die Daten angewendet, um die Vorhersagen zu generieren.
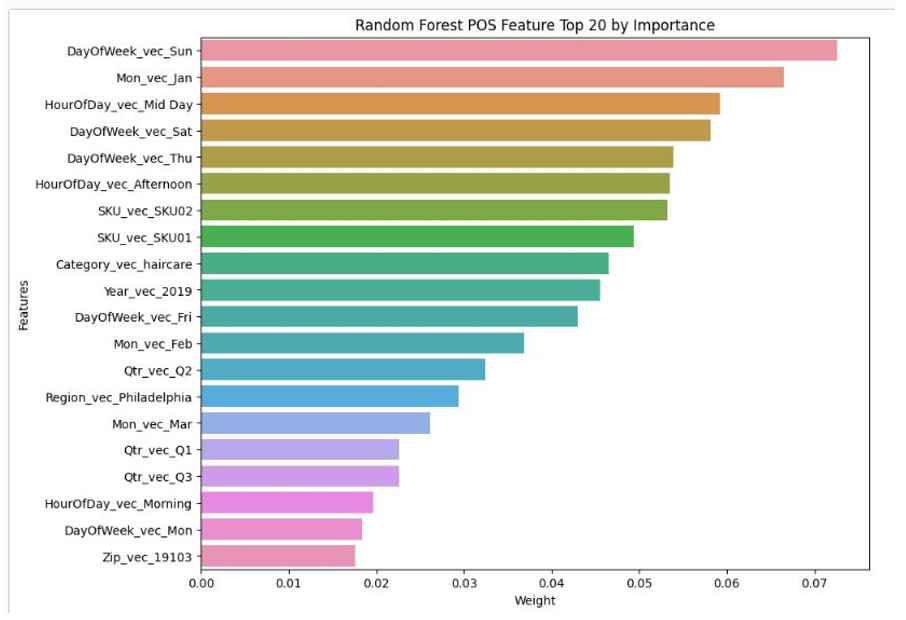
Das RegressionEvaluator-Modul wurde verwendet, um die Ergebnisse auszuwerten, und der mittlere absolute Fehler (MAE), der Wurzelmittelwert (RMSE) und die R-Quadrat-Metriken wurden erzeugt, um die vorhergesagten Ergebnisse zu bewerten. Merkmalsgewichte wurden verwendet, um die Beitragsgewichte jedes Merkmals zu den Vorhersagen zu verstehen.
Orchestrierung der End-to-End-Vorhersagen
Die Datenorchestrierung der PySpark-Notebooks nutzt Databricks Workflows für die Entwicklung, während die Produktions-Retail-Workflow-Orchestrierung von Control-M über dessen Databricks-Plug-in übernommen wird – was Enterprise-Scheduling, Abhängigkeitsmanagement und SLA-Transparenz bietet. Dieser Ansatz ermöglicht es, unseren Databricks-Workflow in die größeren Lieferketten- und Lagerbetriebsworkflows einzubetten, die bereits von Control-M verwaltet werden, um eine vollständig automatisierte, End-to-End-Orchestrierung aller zugehörigen Verarbeitungen zu gewährleisten. Darüber hinaus erhalten wir Zugang zu fortschrittlichen Planungsfunktionen wie der Möglichkeit, die gleichzeitige Ausführung mehrerer Databricks-Workflows zu verwalten, die möglicherweise Zugriff auf eingeschränkte gemeinsame Ressourcen wie öffentliche IP-Adressen in unserem Azure-Abonnement erfordern.
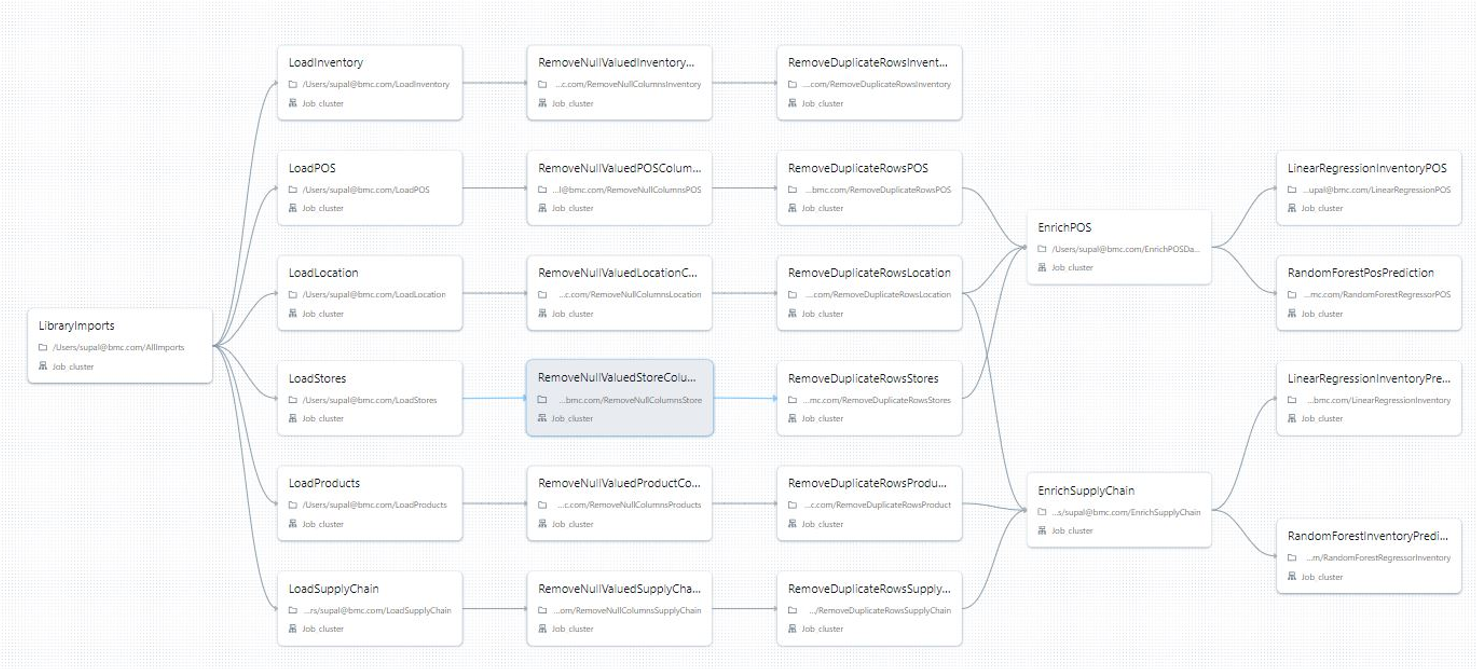
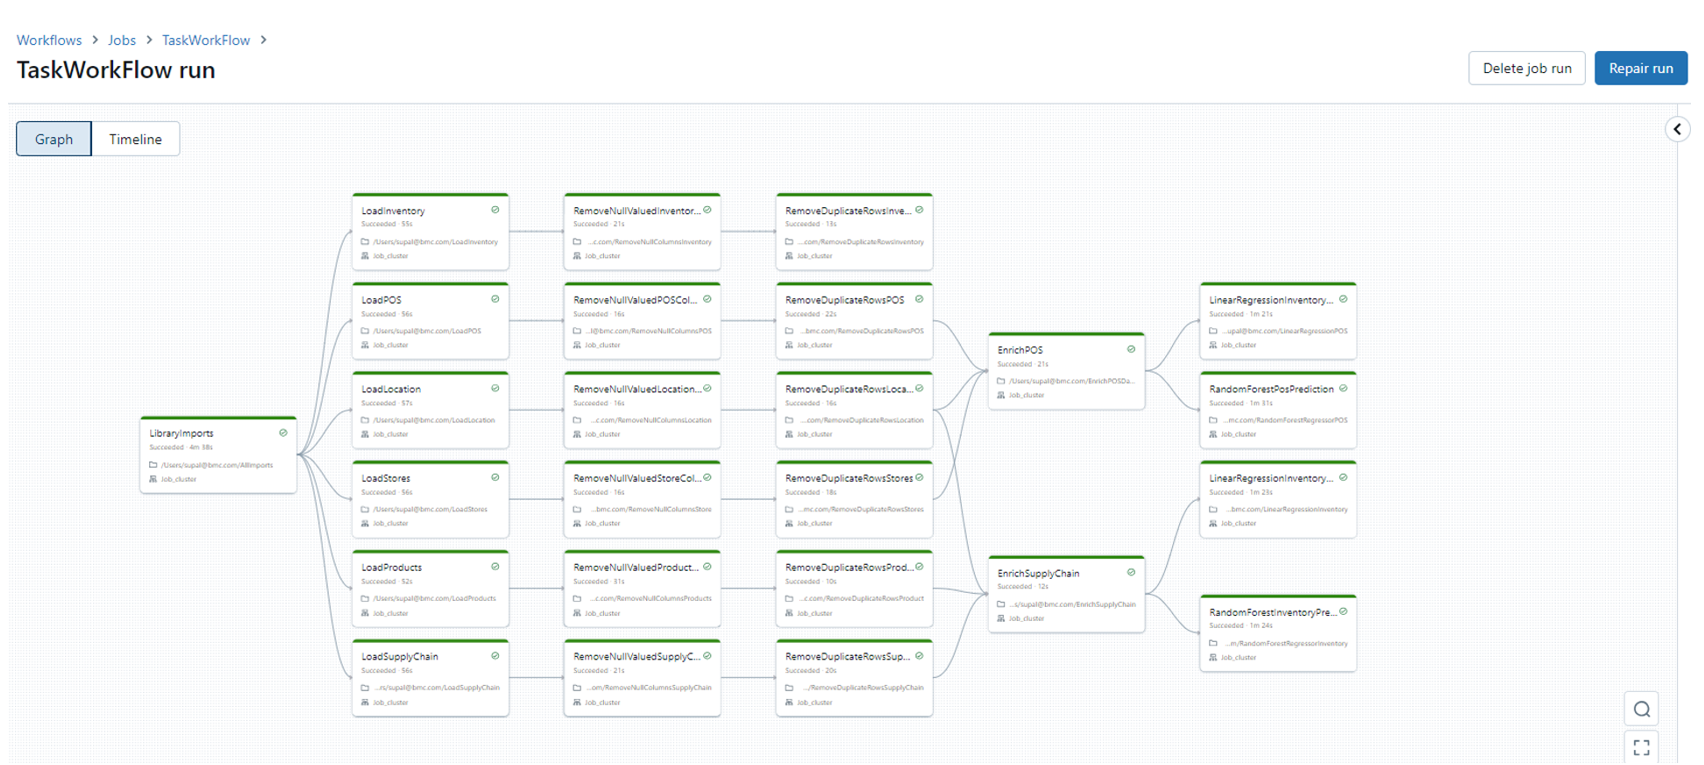
Abbildung 6 zeigt die verschiedenen orchestrierten Aufgaben zur Erstellung der Offline-Vorhersagen und des Dashboards. Die Orchestrierung wurde einfach gehalten und zeigt nicht alle Fehlerpfade und Fehlerbehandlungspfade.
Control-M-Integration mit Databricks
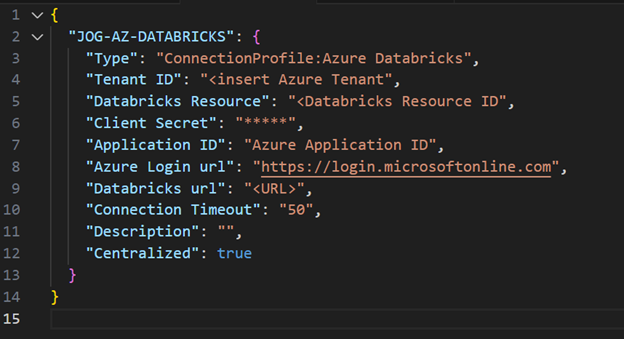
Bevor wir einen Job in Control-M erstellen, der den Databricks-Workflow ausführen kann, müssen wir ein Verbindungsprofil erstellen. Ein Verbindungsprofil enthält Autorisierungsdaten – wie Benutzername, Passwort und andere plug-in-spezifische Parameter – und ermöglicht es Ihnen, sich ausschließlich mit dem Namen des Verbindungsprofils mit dem Anwendungsserver zu verbinden. Verbindungsprofile können über die Weboberfläche erstellt und dann im JSON-Format mit Control-M's Automation API abgerufen werden. Nachfolgend ist ein Beispiel für das Verbindungsprofil für Azure Databricks im JSON-Format enthalten. Wenn Sie das Verbindungsprofil direkt in Json erstellen, bevor Sie den Job ausführen, sollte es über die Control-M Automation API CLI bereitgestellt werden.
Erstellung eines Databricks-Auftrags
Der Job in Control-M, der den Databricks-Workflow ausführt, ist im JSON-Format wie folgt definiert:
    {
"jog-databricks" : {
"Type" : "Folder",
"ControlmServer" : "smprod",
"OrderMethod" : "Manual",
"SiteStandard" : "jog",
"SubApplication" : "Databricks",
"CreatedBy" : "[email protected]",
"Application" : "jog",
"DaysKeepActiveIfNotOk" : "1",
"When" : {
"RuleBasedCalendars" : {
"Included" : [ "EVERYDAY" ],
"EVERYDAY" : {
"Type" : "Calendar:RuleBased",
"When" : {
"DaysRelation" : "OR",
"WeekDays" : [ "NONE" ],
"MonthDays" : [ "ALL" ]
}
}
}
},
"jog-azure-databricks-workflow" : {
"Type" : "Job:Azure Databricks",
"ConnectionProfile" : "JOG-AZ-DATABRICKS",
"Databricks Job ID" : "674653552173981",
"Parameters" : "\"params\" : {}",
"SubApplication" : "Databricks",
"Host" : "azureagents",
"CreatedBy" : "[email protected]",
"RunAs" : "JOG-AZ-DATABRICKS",
"Application" : "jog",
"When" : {
"WeekDays" : [ "NONE" ],
"MonthDays" : [ "ALL" ],
"DaysRelation" : "OR"
},
"AzEastPublicIPs" : {
"Type" : "Resource:Pool",
"Quantity" : "8"
}
}
}
}
Ausführung des Databricks-Workflows
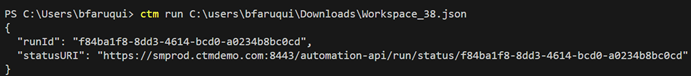
Um den Job auszuführen, verwenden wir den Run-Service innerhalb der Automatisierungs-API.
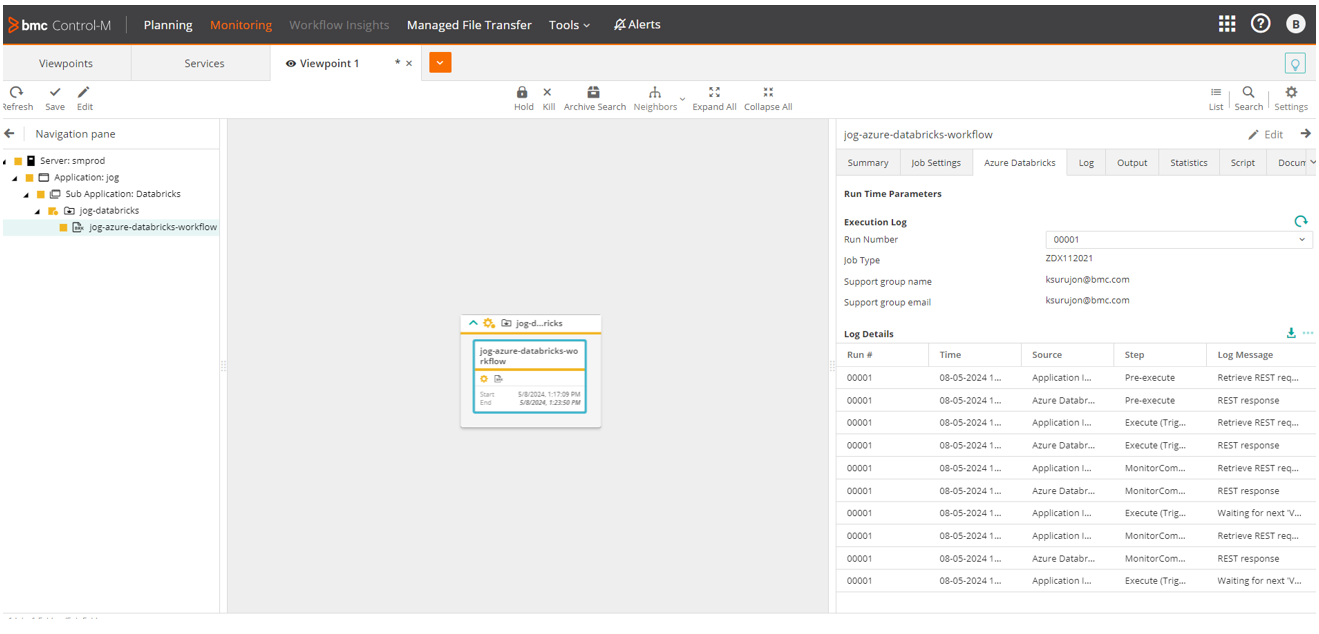
Visualisierung des Arbeitsablaufs
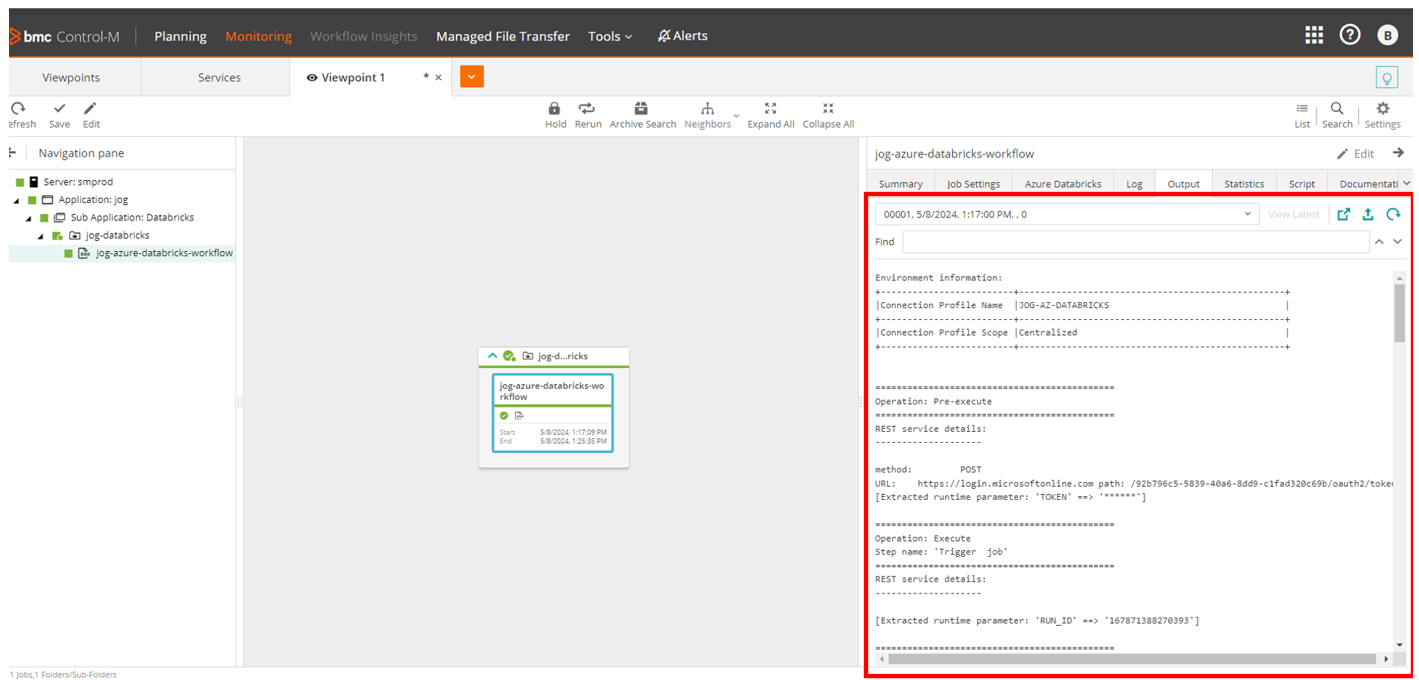
Ausgabe des abgeschlossenen Databricks-Auftrags in Control-M
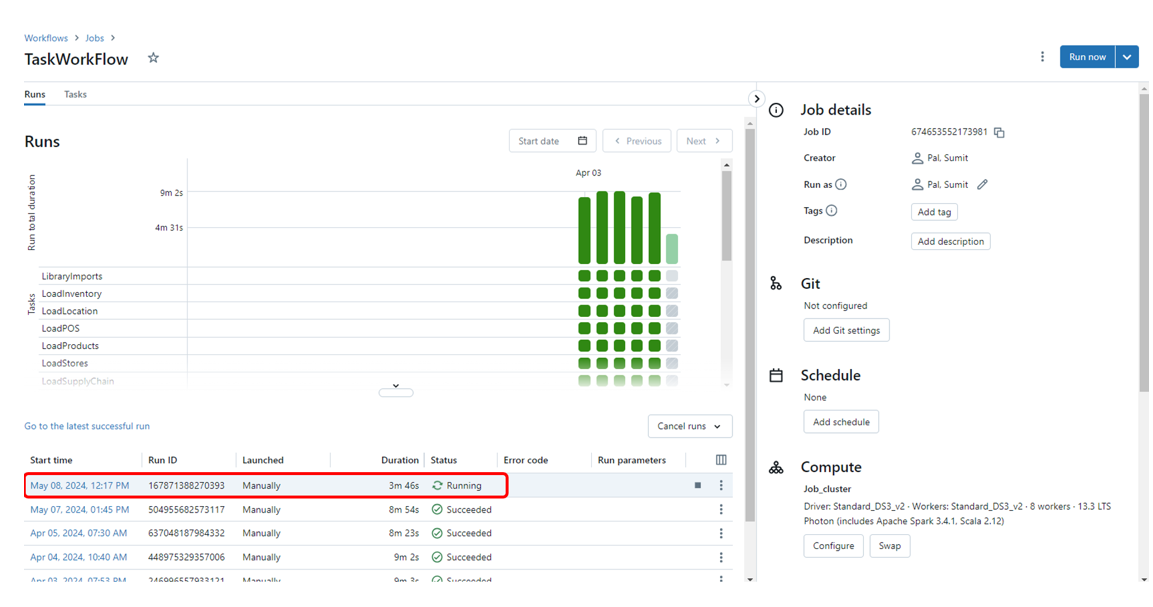
Aufgaben-Workflow in Azure Databricks
Graphenansicht des Aufgaben-Workflows in Azure Databricks
Ausgaben und Visualisierung
Während des Projekts wurden zwei Arten von Ausgaben generiert.
- Vorhergesagte Ergebnisse des Modells für POS-Verkäufe und Lagervorhersagen auf Basis der Nachfrage – diese wurden als Delta-Format-Dateien im Seehaus für die Offline-Anzeige und Analyse gespeichert.
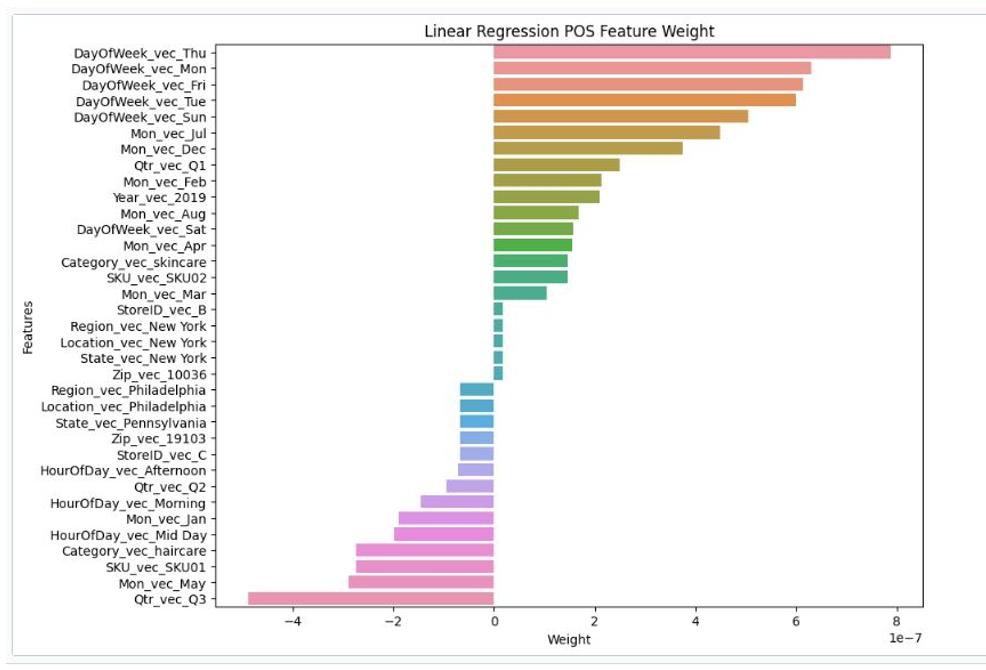
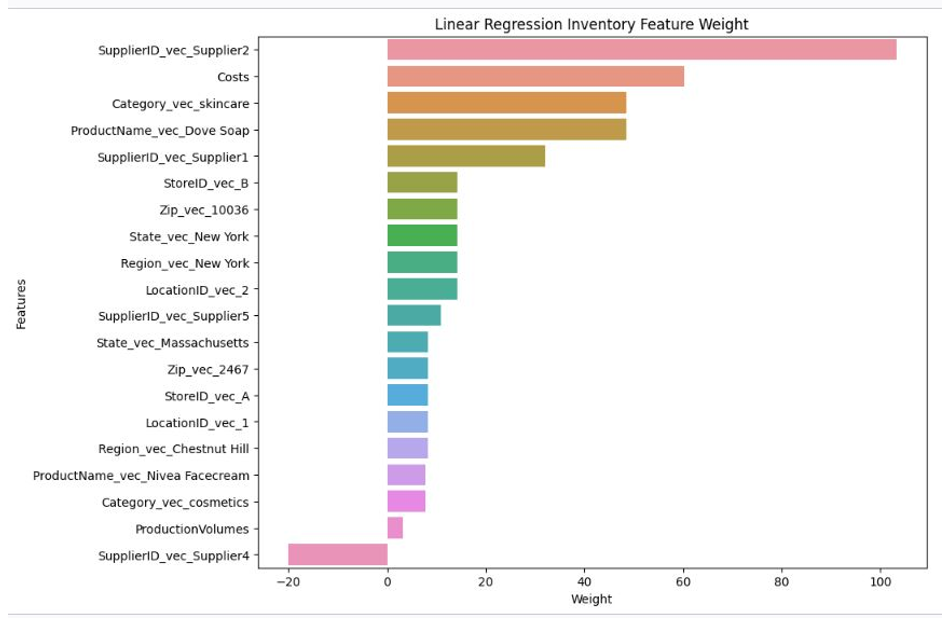
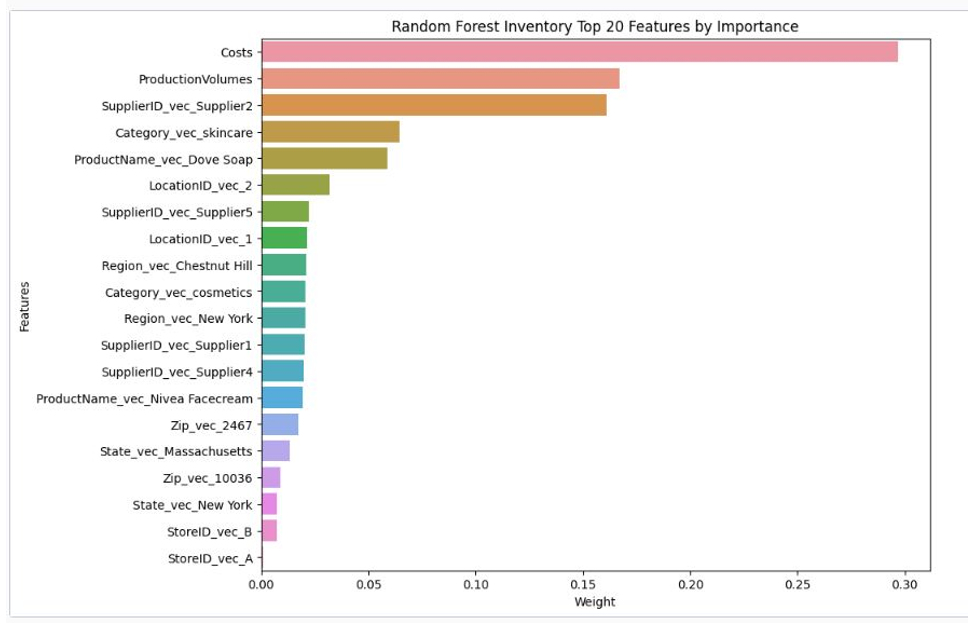
- Visualisierungen der Merkmalgewichte, die zu den Vorhersagen für POS- und Inventardaten sowohl für Random Forest- als auch für lineare Regressionsalgorithmen beitrugen.
Die vier untenstehenden Abbildungen zeigen die Feature-Gewichte für jeden der oben genannten Algorithmen über die verschiedenen Features für POS- und Lagerbestandsvorhersagen aus den feature engineered attributen.
Fazit
Dieser Blog zeigt einen ML-Anwendungsfall für die Prognose von Umsatz und Lagerbeständen. Der ML-Workflow wird wahrscheinlich Teil eines größeren Control-M-Orchestrierungs-Workflows sein – einem, der die Art von Supply-Chain-Orchestrierung für Hersteller widerspiegelt, die POS, Bestandsmanagement und Analytics zu einer einzigen verwalteten Pipeline verbindet. In diesem Blog haben wir jedoch den Fokus auf den ML-Workflow in Databricks sowie dessen Integration und Ausführung durch Control-M beibehalten.
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.