




Auf einen Blick: Site Reliability Engineering (SRE) integriert Softwareentwicklung mit IT-Operationen, um skalierbare und zuverlässige Systeme sicherzustellen, wobei Automatisierung für Effizienz in den Mittelpunkt gelegt wird. SRE stammt von Google und zielt auf hohe Serviceverfügbarkeit ab und nutzt Metriken wie Service Level Objectives (SLOs), um die Leistung zu bewerten.
- SRE strebt eine Verfügbarkeit von 99,99 % an und balanciert Innovation und Risiko aus.
- Zu den Kernprinzipien gehören die Reduzierung von Belastung, effektive Überwachung und Automatisierung.
Die Cloud wird im digitalen Zeitalter zum Standardmodus für Softwarebetrieb. Und wenn es darum geht, Anwendungsleistung und -stabilität bei der Reaktion auf Veränderungen im Geschäftsbedarf zu managen, setzen moderne Ansätze wie SRE schnell Fuß. Eingeführt von Google, hat SRE weltweit rasch Interesse geweckt, da DevOps-Praktiken und Automatisierung zu wesentlichen Funktionen für ein effektives Management von Anwendungen in hybriden Cloud-Umgebungen werden. Tatsächlich belegte LinkedIns Emerging Jobs-Bericht 2020 SRE auf Platz 5, während der Upskilling Enterprise DevOps Skills Report des DevOps Institute 2021 einen Anstieg von 15 % auf 21 % bei der Einführung von SRE als Betriebsmodell zeigte.
Schauen wir uns in diesem Artikel an, worum es bei SRE geht.
Was ist Site Reliability Engineering?
SRE, kurz für Site Reliability Engineering, ist eine Disziplin, die Aspekte der Softwareentwicklung auf IT-Betrieb anwendet, mit dem Ziel, ultraskalierbare und hochzuverlässige Softwaresysteme zu schaffen. SRE stammt von Google als Ansatz für Servicemanagement. Ben Treynor, der leitende Vizepräsident für technische Abläufe bei Google, war der Initiator des Begriffs Site Reliability Engineering und des berühmten Zitats:
"SRE ist das, was passiert, wenn man einen Softwareingenieur bittet, ein Betriebsteam zu entwerfen."
Im Jahr 2003 gründete Treynor mit einem Hintergrund in der Softwareentwicklung ein "Produktionsteam", das zum Bauplan für SRE geworden ist, basierend auf zwei Hauptmerkmalen:
- Ingenieure mit Softwareentwicklungs-Hintergrund einzusetzen, die von einem Betriebsteam durchgeführt werden.
- Wir setzen darauf, dass diese Ingenieure Arbeiten automatisieren, die zuvor manuell erledigt wurden.
Während weiterhin einige manuelle operative Aufgaben wie Ticketbearbeitung und Eskalationen durchgeführt werden, wird erwartet, dass das SRE-Team sich hauptsächlich auf die Entwicklung neuer Produkte und Dienstleistungen konzentriert, indem es Anwendungen und Produktionsumgebungssysteme automatisiert und skaliert. Dies liegt daran, dass mit zunehmender Servicenutzung der Aufwand zur Verwaltung der operativen Last zunimmt. Automatisierung reduziert den operativen Overhead, was zu zusätzlicher Bandbreite führt, die zur Unterstützung neuer Funktionen und Verbesserungen bestehender Anwendungen eingesetzt werden kann. Ein weiterer Vorteil von Softwareingenieuren als SREs ist die Verringerung der Reibung durch Übergaben mit den Produktentwicklungsteams, da sie deren Perspektive verstehen, obwohl der Fokus der SRE auf der operativen Stabilität liegt. (Vergleichen Sie SRE und ITOps genauer.)
Wie funktioniert SRE?
Der Begriff Zuverlässigkeit steht im Zentrum von SRE. Die ITIL® 4 Foundation Publication definiert Zuverlässigkeit als:
"Die Fähigkeit eines Produkts, einer Dienstleistung oder eines anderen Konfigurationselements, seine vorgesehene Funktion für einen bestimmten Zeitraum oder eine bestimmte Anzahl von Zyklen auszuführen."
Damit dies erreicht werden kann, muss ein SRE-Team für diese Komponenten jeder seiner Dienstleistungen verantwortlich sein:
- Verfügbarkeit
- Latenz
- Leistung
- Effizienz
- Change Management
- Überwachung
- Notfalleinsatz
- Kapazitätsplanung
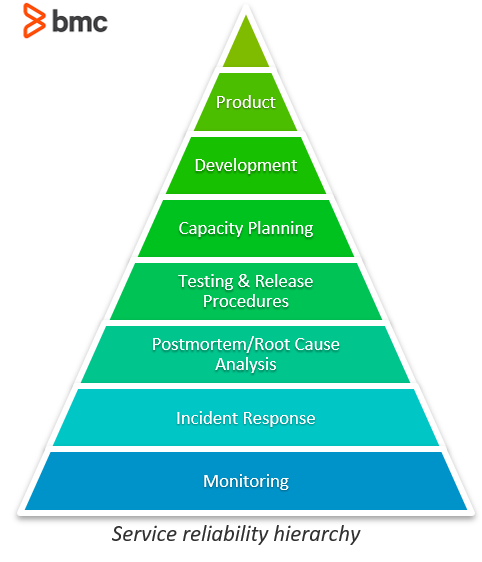
Obwohl sie einen starken Fokus auf die Unterstützung der Produktentwicklung legen, liegt die Priorität der SRE darin, sicherzustellen, dass bestehende Services wie vorgesehen funktionieren. Einfach ausgedrückt: SREs betreiben Services und sind letztlich für die Gesundheit dieser Services verantwortlich. Die tägliche Arbeit der SRE besteht darin, große verteilte Computersysteme zu bauen und zu betreiben. Wie die untenstehende Hierarchie zeigt, sind die grundlegenden Praktiken zur Zuverlässigkeit eines Services:
- Unterstützung bestehender Dienste durch Überwachung und Behebung auftretender Probleme.
- Dann baut man sich bis zur Skalierung auf.
- Schließlich die Unterstützung der Entwicklung neuer Produktfunktionen.
Bei Google gibt es eine Obergrenze von 50 % für SRE-Aktivitäten, die den Service stabil und betriebsfähig machen. Dies steht im Gegensatz zu anderen Service-Management-Ansätzen, die einen solchen Fokus auf fast 80–90 % der Zeit eines Systemadministrators legen würden. Von der SRE wird erwartet, dass sie die restlichen 50 % der Zeit mit Programmierung verbringen, um Automatisierungstools zu entwerfen und einzusetzen, sowie andere Maßnahmen zur Reduktion der Arbeitsbelastung und zur Steigerung von Effizienz und Effektivität in den Abläufen. Durch die Zusammenarbeit mit Nutzern und Produktteams kann der SRE automatisierte Werkzeuge innovativ entwickeln, die zu besseren Produktionsumgebungen führen, die sich durch folgende Werte auszeichnen:
- Skalierbarkeit
- Anmutige Abwertung während des Scheiterns
- Integration mit anderen Diensten und Systemen
- Zusätzliche Vorteile
SRE-Prinzipien
Um SRE in Ihrer Organisation zu übernehmen, sind dies Prinzipien, nach denen Sie streben sollten:
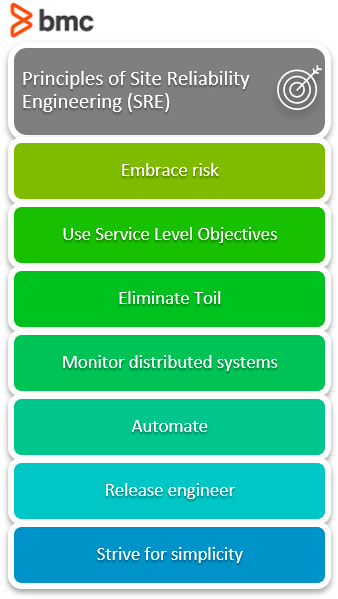
Risiken annehmen
SREs glauben nicht an 100 % zuverlässige Dienstleistungen. Stattdessen zielen sie darauf ab, dass Dienstleistungen zuverlässig genug sind, basierend auf dem Risiko, das das Unternehmen bereit ist zu tragen, basierend auf einer Kosten-Nutzen-Analyse. Ein Ziel von 99,99 % Verfügbarkeit wird gesetzt, wobei SRE versucht, das Risiko der Nichtverfügbarkeit mit den Zielen schneller Innovation und effizienter Serviceabläufe auszubalancieren, damit die Gesamtzufriedenheit der Nutzer optimiert wird.
Nutzung von Service Level Objectives
Um Dienstleistungen zu verstehen und damit bereitzustellen, die den Bedürfnissen der Nutzer entsprechen, werden Service Level Objectives (SLOs) verwendet. SLOs sind ein Zielwert oder ein Wertbereich für ein Servicelevel, das durch einen Service Level Indicator (SLI) gemessen wird, wie zum Beispiel:
- Verfügbarkeit
- Fehlerquote
- Anforderungslatenz
- Durchsatz
- Weitere Indikatoren
Die Struktur für SLOs ist entweder:
- SLI ≤ Ziel
- Untere Schranke ≤ SLI ≤ obere Schranke
Die Auswahl und Veröffentlichung von SLOs an Nutzer setzt Erwartungen an die Leistung eines Dienstes, was dazu beiträgt, unbegründete Beschwerden gegenüber Dienstbetreibern über die Dienstleistung (z. B. Langsamkeit) zu reduzieren. (Erkunden Sie Fehlerbudgets, ein Tool, das in SRE- und Nicht-SRE-Umgebungen funktioniert.)
Beseitigung von Aufwand
Toil ist eine operative Tätigkeit, die mit dem Betrieb eines Produktionsdienstes verbunden ist, der in der Regel manuell, repetitiv, automatisierbar, taktisch, ohne dauerhaften Wert ist und linear skaliert, je weiter ein Dienstleistung wächst. Quellen für Arbeit umfassen:
- Interrupts (nicht dringende, dienstbezogene Nachrichten und E-Mails)
- Bereitschafts- (dringende) Antwort
- Veröffentlichungen
- Pushes
Die Arbeit, den Aufwand zu reduzieren und Dienstleistungen zu skalieren, ist der "Engineering"-Teil von SRE. Auch wenn nicht alle Arbeiten schlecht sind, ist zu viel davon gefährlich, weshalb automatisierte Lösungen durch Software- und Systemtechnik entwickelt werden müssen, um sie zu eliminieren.
Überwachung verteilter Systeme
Überwachung ist ein zentrales Merkmal von SRE, mit dem Ziel, herauszufinden, was kaputt ist (oder kurz davor ist, kaputt zu gehen) und warum. Wenn ein System sich nicht selbst heilen kann, sollte ein SRE die Warnung untersuchen, die Probleme identifizieren und abmildern sowie die Ursache ermitteln. Die Prioritätskennzahlen, die SRE-Überwachung abdeckt, sind:
- Latenz
- Verkehr
- Fehler
- Sättigung
Automatisieren
Automatisierung ist der Daseinszweck bei SRE, insbesondere wenn manuelle Tätigkeiten durch automatisierte ersetzt werden können oder die Notwendigkeit einer Automatisierung durch autonome Systeme eliminiert wird. Die Vorteile der Automatisierung umfassen:
- Konsistenz
- Zeitersparnis
- Schnellere Reparaturen und Aktionen
- Bereitstellung einer Plattform, die auf andere Dienste ausgeweitet werden kann
Der SRE schreibt Code, um das Management des Lebenszyklus der Systeminfrastruktur zu automatisieren, nicht deren Daten.
Release-Engineering
Das SRE unterstützt Entwickler und Release-Ingenieure , um sicherzustellen, dass neue Dienste und Funktionen gut funktionieren und in Zukunft unterstützt werden können. Das SRE wird von Release-Ingenieuren entwickelte Werkzeuge nutzen, um sicherzustellen, dass Projekte mit konsistenten und wiederholbaren Methoden veröffentlicht werden. Sie werden gemeinsam Strategien entwickeln für:
- Kanarienvogel-Veränderungen
- Neuerscheinungen veröffentlichen, ohne die Dienste zu unterbrechen
- Zurückrollende Funktionen, die Probleme aufzeigen
Einfachheit
Der SRE-Ansatz zur Systemverwaltung besteht darin, Agilität und Stabilität im System im Gleichgewicht zu halten. SREs arbeiten daran, Verfahren, Praktiken und Werkzeuge zu schaffen, die Software zuverlässiger machen, ohne geringe Auswirkungen auf die Entwickleragilität. SRE-Teams wehren sich, wenn zufällige Komplexität in die Systeme eingeführt wird, für die sie verantwortlich sind, und bemühen sich ständig, Komplexität in den von ihnen integrierten und operativen Verantwortlichkeiten zu eliminieren.
SRE unterstützt agile Abläufe und Entwicklung
Da die Systeme immer komplexer werden, ist irgendeine Art von Ausfall unvermeidlich. Da SRE keine Perfektion verlangt, kann es stattdessen untersuchen, wie man die Zuverlässigkeit des Service unterstützt – und dabei vorbereitet ist, wenn ein Ausfall eintritt. "Gewinnen Sie Einblicke in die Fähigkeiten, die notwendig sind, um Top-SRE-Talente anzuziehen, und machen Sie sie in Ihrer Organisation erfolgreich mit künstlicher Intelligenz für Betrieb (AIOps) und künstlicher Intelligenz für Service Management (AISM)-Fähigkeiten."

Verwandte Literatur
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.