




Auf einen Blick: DataOps verbessert das Datenmanagement für KI, indem es agile Praktiken integriert, die zuverlässige Daten für den operativen Erfolg gewährleisten. Control-M erleichtert Orchestrierung, ermöglicht ereignisgesteuerte Arbeitsabläufe und kontinuierliche Datenvalidierung, was für effektive KI-Systeme unerlässlich ist.
- Control-M automatisiert die Fehlererkennung und bietet durchgehende Sicht.
- DataOps konzentriert sich darauf, vertrauenswürdige Daten bereitzustellen, die Zusammenarbeit zu verbessern und die Einhaltung der Vorschriften sicherzustellen.
Was KI von DataOps verlangt – und wie Orchestrierung es liefert
DataOps ist die Anwendung agiler und DevOps-Prinzipien auf das Management von Datenpipelines – Automatisierung, Skalierung und Operationalisierung von Datenabläufen im gesamten Unternehmen. Für Organisationen, die in KI investieren, ist DataOps grundlegend geworden: KI-Systeme benötigen Daten, die vertrauenswürdig, validiert und verbrauchsbereit sind, nicht nur Daten, die sich schnell bewegen. Die Lücke zwischen Pipeline-Ausführung und vertrauenswürdigen Ergebnissen zu schließen, ist heute die entscheidende Herausforderung modernen DataOps.
Warum stocken so viele Daten- und KI-Initiativen vor der Produktion ins Stocken?
Die meisten Organisationen können einen vielversprechenden Proof of Concept aufbauen. Das schwierigere Problem besteht darin, ihn in Produktion zu bringen. Laut Forbes schaffen es die überwiegende Mehrheit der generativen KI-Piloten nie in die Produktion – nicht, weil die Ideen nicht solide sind, sondern weil die Skalierung dieser Initiativen Zuverlässigkeit, Integration und Datenqualität erfordert, die Pilotumgebungen nicht verlangen.
Dies spiegelt eine größere Herausforderung wider, die über KI hinausgeht. Trotz anhaltender Investitionen in Datenplattformen und Cloud-Technologien haben Organisationen weiterhin Schwierigkeiten, Daten- und KI-Initiativen im großen Maßstab zu operationalisieren. Die Bemühungen konzentrieren sich weiterhin auf den Aufbau von Pipelines und Trainingsmodellen. Das schwierigere Problem – sicherzustellen, dass diese Systeme in der Produktion konsistent laufen und die Koordination und Datenqualität erforderlich sind, um geschäftskritische Entscheidungen zu unterstützen – liegt darin, wo der Fortschritt ins Stocken gerät.
Wie DataOps die Art und Weise veränderte, wie Organisationen Datenpipelines verwalten
DataOps entstand als Rahmenwerk, um eine grundlegende Herausforderung anzugehen: wie man Dateninitiativen im großen Maßstab operationalisiert. Mit dem Wachstum der Datenmengen und der komplexeren Pipelines hatten traditionelle Ansätze Schwierigkeiten, Schritt zu halten. DataOps wandte agile Engineering- und DevOps-Best Practices im Datenmanagement an, mit einem klaren Ziel: neue Erkenntnisse in produktionsreife Datenpipelines umzuwandeln, die geschäftlichen Mehrwert bieten.
Die Einführung beschleunigte sich rasch, und DataOps entwickelte sich zu einer anerkannten Marktkategorie. Gartner® definiert DataOps als die kollaborative Datenmanagementpraxis, die sich auf die Verbesserung der Kommunikation, kontinuierlicher Integration, Automatisierung, Beobachtbarkeit und Abläufe von Datenströmen zwischen Datenmanagern, Datenkonsumenten und ihren Teams in der gesamten Organisation konzentriert. Im Zentrum dieser Definition steht Orchestrierung: die Koordination, Automatisierung und Kontrolle, die komplexe Datenabläufe handhabbar macht.
Was KI-fähige Daten tatsächlich benötigen
DataOps hat Organisationen geholfen, Datenpipelines zu automatisieren und zu skalieren – aber KI-Systeme haben die Messlatte höher gelegt. Geschwindigkeit allein reicht nicht mehr aus.
KI-fähige Daten, wie wir sie im Gartner-Bericht sehen, erfordern drei Dinge:
- Ausrichtung – Relevanz für den spezifischen Anwendungsfall
- Qualifikation – kontinuierliche Validierung für Produktionsumgebungen
- Governance – Politik, Compliance und Rückverfolgbarkeit
Dies stellt einen grundlegenden Wandel in dem, was DataOps liefern muss. Bei DataOps geht es nicht mehr nur darum, Daten effizient zu bewegen – es geht darum, sicherzustellen, dass Daten für intelligente Systeme bereit sind.
Warum Datenqualität jetzt ein Orchestrierungsproblem ist
Viele Organisationen haben automatisierte Orchestrierung. Viel weniger haben Datenbereitschafts- und Zertifizierungspraktiken eingeführt. Diese Lücke ist der Punkt, an dem KI-Initiativen scheitern.
Wenn Pipelines Geschwindigkeit über Bereitschaft stellen, gelangen nicht validierte Daten zu KI-Systemen und treiben Geschäftsentscheidungen voran. Das Ergebnis ist nicht nur ein Pipeline-Ausfall – es sind fehlerhafte Ergebnisse im großen Maßstab. Datenqualität kann nicht als separate, nachgelagerte Überprüfung behandelt werden. Sie muss in den Workflow selbst eingebettet werden – Daten im Kontext validieren, die Ausführung auf Basis der Bereitschaft steuern, nachgelagerte Auswirkungen verhindern und die Sanierung automatisch auslösen. Ohne dieses Maß an Koordination können Pipelines laufen, aber ihren Ausgaben kann man nicht vertrauen.
Wie die moderne Komplexität von Datenpipelines aussieht
Moderne Datenpipelines umfassen mehrere Anwendungen, Datenquellen und Infrastrukturtechnologien, die nahtlos zusammenarbeiten müssen. Organisationen betreiben heute eine Mischung aus Analysepipelines, maschinellen Lernpipelines, RAG-Pipelines und Echtzeit-Inferenzpipelines. Obwohl jede einen anderen Zweck erfüllt, basieren sie alle auf derselben Grundlage: Aufnahme, Speicherung, Verarbeitung und Auslieferung.
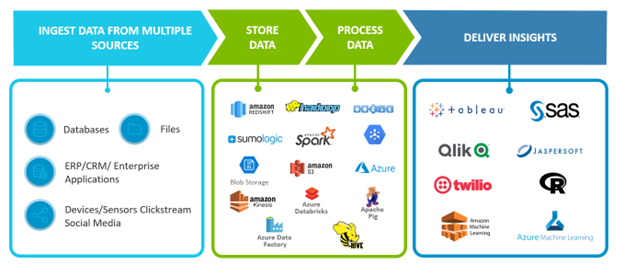
Ingestion zieht Daten aus Unternehmenssystemen, Geräten und digitalen Kanälen. Speicher umfasst vielfältige Plattformen, die auf Kosten, Skalierbarkeit und Zugriff optimiert sind. Die Verarbeitung umfasst Batch-, Echtzeit- und ereignisgesteuerte Workloads – nun erweitert auf Feature Engineering, Modelltraining und Inferenz. Delivery feeds nicht nur Dashboards, sondern auch Anwendungen, APIs sowie KI-Modelle und Agenten, die automatisierte Entscheidungen steuern.
Da Pipelines miteinander verbunden werden, ist die Datenqualität nicht mehr auf eine einzige Stufe beschränkt. Upstream-eingeführte Probleme können sich lautlos weiterentwickeln – was Analysen, Modellleistung und Geschäftsentscheidungen beeinträchtigt. Pipelines können laufen und SLAs erfüllt werden, dennoch können die Ergebnisse falsch sein. In KI-gesteuerten Systemen führt dies zu fehlerhaften automatisierten Entscheidungen im großen Maßstab.
Deshalb muss sich Orchestrierung von einer Planungsschicht zu einer Kontrollschicht entwickeln – eine, die nicht nur bestimmt, wann Workflows ausgeführt werden, sondern ob sie überhaupt ausgeführt werden sollten, basierend auf Datenbereitschaft und -qualität.
Operationalisierung von DataOps für das KI-Zeitalter mit Control-M
DataOps bildet die Grundlage für die Verwaltung von Datenpipelines. Der Erfolg in KI-gesteuerten Umgebungen hängt jedoch davon ab, Daten, KI und Anwendungs-Workflows zuverlässig und in großem Maßstab als einheitliches System zu operationalisieren. Die oben genannten Lücken – Datenbereitschaft, Ausführungsgating, ereignisgesteuerte Koordination und plattformübergreifende Sichtbarkeit – erfordern eine Kontrollschicht, die über einzelnen Pipelines operiert. Control-M und Control-M SaaS stellen diese Schicht bereit.
Indem Control-M die Komplexität moderner Umgebungen abstrahiert, orchestriert es Arbeitsabläufe über Datenplattformen, KI-Systeme und Geschäftsanwendungen hinweg – bietet Ende-zu-Ende-Sichtbarkeit, prädiktive SLAs und koordinierte Ausführung in hybriden und Multi-Cloud-Umgebungen.
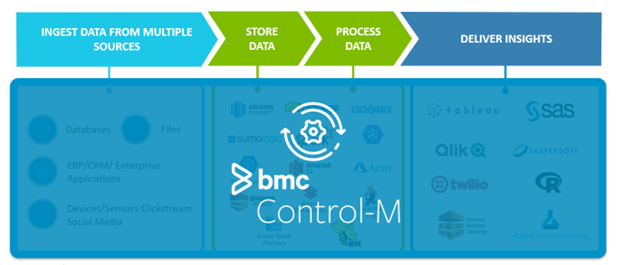
Orchestrierung im modernen Daten- und KI-Ökosystem
Moderne Arbeitsabläufe umfassen ein schnell wachsendes Ökosystem von Technologien. Control-M bietet tiefgehende, standardmäßige Integrationen über Datenplattformen wie Snowflake, Databricks und BigQuery; KI-Plattformen wie SageMaker, Bedrock und Vertex AI; Streaming-Systeme wie Kafka, SQS und RabbitMQ; sowie Unternehmensanwendungen über ERP-, CRM- und moderne SaaS-Plattformen hinweg. Diese Breite ermöglicht es Organisationen, End-to-End-Workflows über den gesamten Daten- und KI-Stack hinweg zu orchestrieren – ohne auf benutzerdefinierte Skripte oder fragmentierte Tools angewiesen zu sein.
Ermöglichung ereignisgesteuerter und Echtzeit-Workflows
KI-gesteuerte Systeme arbeiten zunehmend in Echtzeit – ausgelöst durch Ereignisse, nicht durch Zeitpläne. Control-M unterstützt ereignisgesteuerte Orchestrierung, wodurch Workflows auf Basis von Datenänderungen, Anwendungsereignissen und Geschäftsauslösern initiiert werden können. Dies ermöglicht eine reaktionsschnellere Ausführung von Inferenzpipelines, agentengesteuerten Entscheidungen und zeitkritischen Prozessen.
Einbettung der Datenbereitschaft mit Control-M Data Assurance
In KI-gesteuerten Umgebungen birgt die Ausführung ohne Validierung Risiken. Control-M Data Assurance integriert kontinuierliche Datenvalidierung direkt in Workflows und stellt sicher, dass Daten vor, während und nach der Ausführung validiert werden. Workflows können basierend auf der Datenbereitschaft gegat werden, wodurch verhindert wird, dass fehlerhafte Daten nachgelagerte Prozesse auslösen, und sicherzustellen, dass KI-Modelle und Agenten nur mit vertrauenswürdigen Eingaben arbeiten. Dadurch verlagert sich DataOps von der Pipeline-Ausführung auf die vertrauenswürdige Ausführung.
SLA-gesteuerte, ergebnisbewusste Orchestrierung
Control-M verbindet die Workflow-Ausführung mit Geschäftsergebnissen – das Verfolgen von SLAs, die Vorhersage von Verzögerungen und die Sichtbarmachung von Auswirkungen – sodass Workflows an geschäftskritische Zeitpläne abgestimmt sind.
Automatisierung, Sanierung und Sichtbarkeit in großem Maßstab
Control-M automatisiert Fehlererkennung, Benachrichtigungen, Behebung und plattformübergreifende Koordination und bietet gleichzeitig End-to-End-Transparenz über Workflows hinweg für Betriebsteams, Entwickler und Geschäftsanwender.
Der Datenbedarf wächst weiter – aber der Wert wird erst realisiert, wenn diese Daten effektiv operationalisiert werden. Durch die Kombination von DataOps-Praktiken mit einer Kontrollschicht wie Control-M können Organisationen Daten, KI und Anwendungsworkflows von Anfang zu Ende orchestrieren, sich über sich entwickelnde Ökosysteme integrieren, in Echtzeit auf Ereignisse reagieren, die Datenbereitschaft vor der Ausführung sicherstellen und zuverlässige, SLA-gesteuerte Ergebnisse in großem Umfang liefern.
Erfolg im KI-Zeitalter wird nicht dadurch definiert, wie schnell Pipelines laufen – sondern dadurch, wie zuverlässig sie vertrauenswürdige, umsetzbare Ergebnisse liefern.
Häufig gestellte Fragen zu DataOps und KI-Orchestrierung
Was ist der Unterschied zwischen DataOps und traditionellem Datenmanagement?
Das traditionelle Datenmanagement konzentriert sich auf die Speicherung und den Zugriff auf Daten. DataOps wendet agile Engineering- und DevOps-Prinzipien auf den gesamten Lebenszyklus von Datenpipelines an – automatisiert die Bereitstellung, verbessert die Zusammenarbeit zwischen Teams und ermöglicht eine schnellere, zuverlässigere Implementierung von Daten-Workflows.
Warum schaffen es generative KI-Piloten oft nicht, in die Produktion zu gelangen?
Die meisten generativen KI-Piloten schaffen es nicht, die Produktion zu erreichen, nicht weil die zugrundeliegende Technologie fehlerhaft ist, sondern weil die Skalierung von KI Daten erfordert, die kontinuierlich validiert, zuverlässig geliefert und zur Einhaltung der Vorschriften geregelt werden – Bedingungen, für die Pilotumgebungen selten getestet werden. Ohne Produktions-DataOps-Praktiken stoßen KI-Systeme auf Qualitätsprobleme, die zu Ausfällen oder falschen Ergebnissen im großen Maßstab führen.
Was sind KI-fähige Daten?
KI-fähige Daten erfüllen drei Kriterien, die wir im Gartner-Bericht sehen: Ausrichtung (Relevanz für den spezifischen Anwendungsfall), Qualifikation (kontinuierliche Validierung für Produktionsumgebungen) und Governance (Richtlinien, Compliance und Rückverfolgbarkeit). Daten, die sich schnell bewegen, diese Kriterien nicht erfüllen, können bei der Nutzung durch KI-Systeme zu falschen Ergebnissen führen.
Welche Rolle spielt die Orchestrierung in DataOps?
Orchestrierung ist die Koordinationsschicht, die steuert, wann, wie und ob Daten-Workflows ausgeführt werden. In modernen DataOps hat sich die Orchestrierung über die Planung hinaus ausgeweitet und umfasst Daten-Readiness Gating, ereignisgesteuertes Triggern, SLA-Tracking und automatisierte Behebung – so wird sichergestellt, dass Pipelines nicht nur laufen, sondern auch vertrauenswürdige Ergebnisse liefern.
Wie unterstützt Control-M DataOps für KI?
Control-M fungiert als Kontrollschicht für Daten-, KI- und Anwendungsworkflows – es orchestriert die Ausführung über Plattformen wie Snowflake, Databricks, SageMaker und Kafka. Control-M Data Assurance integriert die Datenvalidierung direkt in Workflows und steuert die Ausführung auf Basis der Bereitschaft, sodass KI-Modelle und Agenten nur mit vertrauenswürdigen Eingaben arbeiten.
Was ist der Unterschied zwischen Pipeline-Orchestrierung und einer Kontrollschicht?
Pipeline-Orchestrierung koordiniert die Aufgabenausführung innerhalb eines Workflows. Eine Kontrollschicht arbeitet auf einer höheren Ebene – sie bestimmt, ob Workflows basierend auf Datenqualität und -bereitschaft ausgeführt werden sollen, koordiniert über mehrere Systeme und Pipeline-Typen hinweg und verknüpft die Ausführung mit Geschäftsergebnissen durch SLA-Tracking und prädiktive Überwachung.
Bitte fügen Sie die erforderlichen Quellenangaben und Haftungsausschlüsse hinzu –
Gartner, Marktführer für DataOps-Tools, von Michael Simone, Sharat Menon, Robert Thanaraj, 24. Oktober 2025.
GARTNER ist eine Marke von Gartner, Inc. und/oder dessen Tochtergesellschaften.
Gartner unterstützt keinen Anbieter, kein Produkt oder eine Dienstleistung, die in seinen Forschungspublikationen dargestellt wird, und rät Technologienutzern nicht, nur diejenigen Anbieter mit den höchsten Bewertungen oder anderen Bezeichnungen auszuwählen. Gartner-Forschungspublikationen bestehen aus den Meinungen der Forschungsorganisation von Gartner und sollten nicht als Tatsachenaussagen ausgelegt werden. Gartner lehnt alle Garantien, ausdrücklich oder stillschweigend, in Bezug auf diese Forschung ab, einschließlich jeglicher Garantien auf Verkaufbarkeit oder Eignung für einen bestimmten Zweck.
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.