




Auf einen Blick: Die Erstellung einer maschinellen Lernpipeline umfasst Schritte zur Vorbereitung von Daten für die Modellierung mit Frameworks wie scikit-learn, einschließlich Datenextraktion, Transformation und Normalisierung zur optimalen Leistung.
- Maschinelle Lernpipelines vereinfachen den Prozess der Vorbereitung und Modellierung von Daten.
- Das mit TripAdvisor-Daten bereitgestellte Beispiel illustriert Datenkonvertierungs- und Normalisierungstechniken.
In diesem Artikel zeige ich Ihnen, wie man eine maschinelle Lernpipeline erstellt. In diesem Beispiel verwenden wir das scikit-learn maschinelles Lernen-Framework (siehe unseren scikit-learn-Leitfaden oder durchstöbern die Themen im rechten Menü). Das Konzept einer Pipeline existiert jedoch für die meisten Machine-Learning-Frameworks. Um weiter zu folgen, sind die Daten hier verfügbar und der Code hier.
Was ist eine maschinelle Lernpipeline?
Im Allgemeinen beschreibt oder modelliert eine maschinelle Lernpipeline Ihren ML-Prozess: Code schreiben, ihn in die Produktion freigeben, Datenextraktionen durchführen, Trainingsmodelle erstellen und den Algorithmus optimieren. Eine ML-Pipeline sollte ein kontinuierlicher Prozess sein, während ein Team an ihrer ML-Plattform arbeitet. Maschinelle Lernprogramme umfassen eine Reihe von Schritten, um die Daten bereit zu machen, bevor sie in das ML-Modell eingespeist werden. Diese Schritte können Folgendes umfassen:
- Das Lesen der Daten und die Umwandlung in einen Pandas-Dataframe
- Einige Spalten entfernen oder hinzufügen
- Ich führe einige Berechnungen über die Spalten durch
- Normalisierung der Daten
Du kannst das Pipeline-Objekt Schritt für Schritt verwenden. Schauen wir uns ein Beispiel an.
Beispiel für ML-Pipeline unter Verwendung von Beispieldaten
Wir haben uns diese Daten bereits aus Trip Advisor angesehen . Wie Sie sehen, sind die Daten eine Kombination aus Text und Zahlen. In einem Machine-Learning-Modell müssen alle Eingaben Zahlen sein (mit einigen Ausnahmen). Deshalb verwenden wir eine Pipeline als Schritt 1: Daten in Zahlen umwandeln. Wir verwenden die Pipeline auch für Schritt 2: Normalisierung der Daten. Das bedeutet, für jeden Datenpunkt x berechnen wir den neuen Wert z = x - (Durchschnitt) / (Standardabweichung). Dadurch sind alle großen Zahlen klein, was nützlich ist, weil ML-Modelle am besten funktionieren, wenn die Eingaben normalisiert sind.
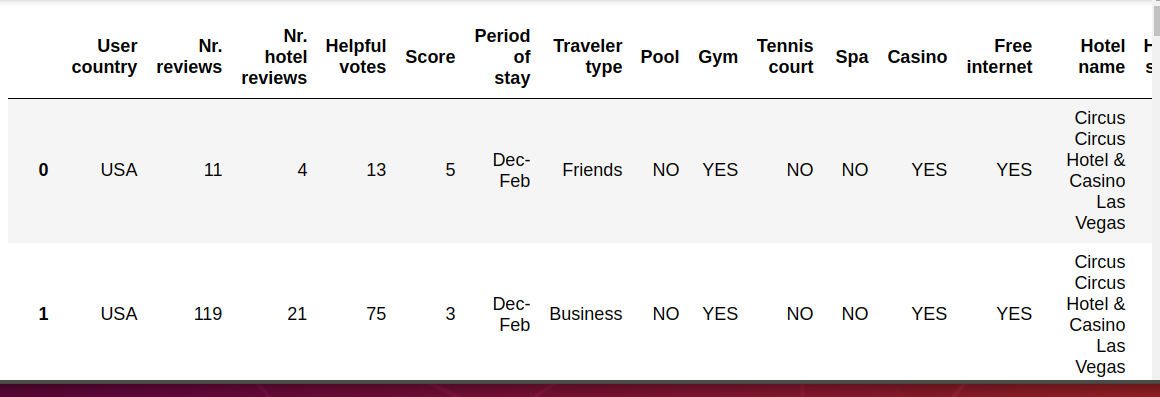
Wir beginnen damit, die Daten mit Pandas zu importieren. Dann erstellen wir ein Array der nicht-numerischen Spalten, die wir in Zahlen umwandeln.
    import pandas as pd
import numpy as np
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler

df = pd.read_csv('/home/ubuntu/Documents/TripAdvisor.csv',sep=',',header=0)

cols = ['User country',  'Period of stay', 'Traveler type', 'Pool', 'Gym',
       'Tennis court', 'Spa', 'Casino', 'Free internet', 'Hotel name',
       'User continent',
       'Review month', 'Review weekday','Hotel stars']
Das tun wir, indem wir die Pandas factorize()-Funktion verwenden. Diese nimmt Text und wandelt diesen in kategoriale Werte um, das heißt, sie werden einfach in eindeutige Zahlen umgewandelt. Die Pipeline-Methode funktioniert so: Man stapelt Funktionen in der Reihenfolge, in der man sie ausführen möchte. Diese werden Transformer genannt. Unten erstellen wir einen eigenen Transformer und verwenden dann einen, der in scikit-learn eingebaut ist. Das Format lautet: Pipeline-Konstruktor mit Tupeln von ('ein beschreibender Name', eine Funktion). Man kann Argumente an die init()-Methode der ersten Funktion übergeben, wo einige Args angezeigt werden. Jede Methode muss die fit()- und transform()-Funktionen implementieren. Nur implementiert die letzte Funktion nur fit().
    pipeline = Pipeline([
    ('someName', someFunction(some args)),
    ('next Name', nextFuntion())
])

data = pipeline.fit_transform(dataframe)
Hier ist die erste Funktion, die wir aufrufen. Sie verwendet die Objekte BaseEstimator und TransforMixin , was uns das Schreiben von Code erspart. Zum Beispiel erstellt sie eine fit_transform()- Methode für uns und erstellt Getters und Setzer, die wir verwenden können, um andere Parameter zu übergeben. Wir geben die Spalten, die wir in Zahlen umwandeln wollen, im init() -Konstruktor ein. Das für uns erstellte X-Objekt enthält Datensatz, den wir an den Transformator weitergeben: pipeline.fit_transform(Dataframe). Dann schleifen wir jede Spalte im Cols-Array in Schleifen und ändern diese mit Factorize(). Schließlich geben wir das Pandas-Dataframe als NumPy-Array unter Verwendung von X.values zurück, da Machine-Learning-Modelle mit NumPy-Arrays arbeiten, nicht mit Dataframes (in den meisten Fällen)
    from sklearn.base import BaseEstimator, TransformerMixin

class ToNumbers(BaseEstimator, TransformerMixin):
    def __init__(self, cols):
        self.cols = cols
    def fit(self, X, y=None):
        return self
    def transform(self, X):
        for c in cols:
            encoded, categories = X[c].factorize()
            X[c] = encoded
        return X.values
Der zweite Schritt ruft den StandardScaler() auf, um die Werte im Array zu normalisieren. Wir müssen ihm keine Argumente übergeben, da er weiß, dass er die Daten des vorherigen Schritts verwenden soll.
    pipeline = Pipeline([
    ('toNumbers', ToNumbers(cols)),
    ('scaler', StandardScaler())
])

data = pipeline.fit_transform(df)
Hier sind die konvertierten Daten als NumPy-Array.
    data

array([[-0.51293975, -0.49559486, -0.50236994, ...,  0.10211954,
        -1.59325501, -1.62074647],
       [-0.51293975,  0.94590453,  0.20791152, ...,  0.02768968,
        -1.59325501, -1.1089318 ],
       [-0.51293975, -0.16191445, -0.29346363, ...,  0.0152847 ,
        -1.30357228, -0.59711712],
       ...,
       [-0.51293975,  1.41305711,  0.29147405, ...,  0.04009466,
         1.30357228, -1.62074647],
       [-0.51293975, -0.5222893 , -0.41880742, ...,  0.10211954,
         1.59325501,  0.42651223],
       [-0.51293975, -0.37546991,  0.124349  , ...,  0.05249964,
         1.59325501, -0.08530245]])
scikit Lernleitfaden
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.