




Auf einen Blick: Data Lakes, Data Warehouses und Datenbanken erfüllen unterschiedliche Zwecke in der Datenspeicherung. Data Lakes integrieren unstrukturierte Daten für fortgeschrittene Analysen, während Data Warehouses strukturierte Daten für Business Intelligence benötigen. Jeder hat einzigartige Stärken, Kosten und Nutzerbasen, die die Datenstrategien und Entscheidungsfindung der Organisation beeinflussen.
- Data Lakes bieten Agilität und kosteneffiziente Speicherung für verschiedene Datentypen.
- Data Warehouses bieten strukturierte Umgebungen für effiziente Datenanalyse und Entscheidungsfindung.
Datenspeicherung ist eine große Sache. Datenunternehmen sind in letzter Zeit oft in den Nachrichten, besonders da Unternehmen versuchen, den Mehrwert aus dem Potenzial von Big Data zu maximieren. Für Laien wird die Datenspeicherung meist in einer traditionellen Datenbank gehandhabt. Für Big Data verwenden Unternehmen jedoch Data Warehouses und Data Lakes. Data Lakes werden oft mit Data Warehouses verglichen – aber das sollten sie nicht. Data Lakes und Data Warehouses unterscheiden sich stark – von der Struktur und Verarbeitung bis hin zu den Nutzern und Warum. In diesem Artikel werden wir:
- Definiere Datenbanken, Data Warehouses und Data Lakes
- Tauchen Sie ein in Data Lake vs. Data Warehouse
- Fassen Sie die großen Unterschiede zusammen
- Vorsicht bei der Verwendung von Datenseen
- Entdecken Sie die Zukunft der Datenspeicherung
- Zeigen Sie, wie Sie die richtige Datenspeicherlösung auswählen
- Und mehr
Definition von Datenbank, Data Warehouse und Data Lake
Beginnen wir mit den Konzepten und verwenden eine Expertenanalogie, um die Unterschiede herauszuarbeiten.
Was ist eine Datenbank?
Eine Datenbank ist ein Speicherort, der strukturierte Daten beherbergt. Wir denken meist an eine Datenbank auf einem Computer – mit Daten, die auf verschiedene Arten leicht zugänglich sind. Man könnte argumentieren, dass Ihr Smartphone dank all der gespeicherten Daten über Sie eine eigene Datenbank ist. Für alle Organisationen umfassen die Anwendungsfälle für Datenbanken:
- Erstellung von Berichten für Finanz- und andere Daten
- Analyse relativ kleiner Datensätze
- Automatisierung von Geschäftsprozessen
- Dateneingabeprüfung
Datenbankbeispiele
Wenn es um kommerzielle Datenbanksysteme geht, haben Sie eine Vielzahl von Möglichkeiten. Jedes der untenstehenden Beispiele bietet unterschiedliche Funktionen und Funktionen, die Sie bei der Auswahl der am besten passenden für Ihre Anwendung berücksichtigen sollten. Beliebte Datenbanken sind:
(Erfahren Sie mehr über den wichtigsten Unterschied zwischen Datenbanken: SQL vs. NoSQL.)
Was ist ein Data Warehouse?
Der nächste Schritt nach einer Datenbank ist ein Data Warehouse. Data Warehouses sind große Speicherorte für Daten, die Sie aus einer Vielzahl von Quellen sammeln. Jahrzehntelang lag die Grundlage für Business Intelligence und Datenentdeckung/-speicherung auf Data Warehouses. Ihre spezifischen, statischen Strukturen bestimmen, welche Datenanalysen Sie durchführen können. Data Warehouses sind bei mittelgroßen und großen Unternehmen beliebt, da sie Daten und Inhalte zwischen team- oder abteilungsgetrennten Datenbanken teilen. Data Warehouses helfen Organisationen, effizienter zu werden. Organisationen, die Data Warehouses nutzen, tun dies oft, um Managemententscheidungen zu treffen – all jene "datengetriebenen" Entscheidungen, von denen man immer hört.
Data-Warehouse-Beispiele
Diese groß angelegten Datenspeicherlösungen ermöglichen es, Daten aus mehreren Quellen in einem einzigen Repository zu sammeln, das Business Analytics und Entscheidungsfindung unterstützt. Beliebte Unternehmen, die Data Warehouses anbieten, sind:
- Schneeflocke
- Yellowbrick
- Teradata
Was ist ein Data Lake?
Ein Data Lake ist ein großes Speicher-Repository, das eine riesige Menge an Rohdaten im ursprünglichen Format speichert, bis man sie benötigt. Data Lake nutzen die größte Einschränkung von Data Warehouses aus: ihre Fähigkeit, flexibler zu sein. Wie wir unten sehen werden, sind die Anwendungsfälle für Data Lake im Allgemeinen auf Data-Science-Forschung und -Tests beschränkt – daher sind die Hauptnutzer Data Lakes Data Scientists und Ingenieure. Für ein Unternehmen, das Data Warehouses tatsächlich aufbaut, ist der Data Lake beispielsweise ein Ort, an dem alle Daten entladen und vorübergehend gespeichert werden, bis das Data Warehouse einsatzbereit ist. Kleine und mittelgroße Organisationen haben wahrscheinlich kaum einen Grund, einen Data Lake zu nutzen.
Datenlake-Beispiele
Diese riesigen Reservoirs sind flexibel genug, um Rohdaten zu enthalten, die strukturiert, teilweise oder vollständig unstrukturiert sein können. Da KI, maschinelles Lernen und neue Arten von Datenanalysen zunehmend verschiedene Datentypen und Strukturen bewältigen, haben sich Data Lakes als skalierbare und flexible Lösung etabliert. Beliebte Data Lake-Unternehmen sind:
- Hadoop
- Azure
- Amazon S3
Data Lake vs. Data Warehouse
Das Verständnis der Unterschiede in den Speicheroptionen hilft Ihnen, die richtige Wahl für Ihre Anwendungen zu treffen. Hier ist eine kurze Zusammenfassung dessen, was jede Option bietet: Datenbanken:
- Sie sind am besten für die Echtzeitabwicklung von Transaktionen.
- Die Daten sind hochgradig strukturiert und in Zeilen und Spalten mit Werten und Attributen normalisiert.
- Schemata sind starr und legen Wert auf Konsistenz.
- Die Skalierbarkeit ist begrenzt.
Datenwarehouses:
- Sie sind am besten geeignet, um Business Intelligence zu speichern und historische Daten für operative Entscheidungen zu analysieren.
- Die Daten stammen aus mehreren Quellen und sind entweder strukturiert oder halbstrukturiert.
- Schemata sind vordefiniert, können aber bis zu einem gewissen Grad angepasst werden, um die Analyse zu unterstützen.
- Die Skalierbarkeit ist hoch, um große Datenmengen effizient und wirtschaftlich zu verarbeiten.
Datenseen:
- Sie sind am besten geeignet, um riesige Datenmengen für vielfältige und noch nicht definierte Anwendungen zu speichern, einschließlich maschinellem Lernen und anderen fortgeschrittenen Anwendungen.
- Daten können strukturiert, unstrukturiert und in verschiedenen Formaten von Tabellen über Logs bis hin zu Bildern und Dokumenten sein.
- Schemata werden angewendet, wenn Daten gelesen und in Anwendungen verwendet werden, andernfalls haben Daten im Speicher im See kein Schema.
- Skalierbarkeit und Flexibilität sind äußerst kosteneffizient und sind die zentralen Werte von Data Lakes.
Data Lake vs Data Warehouse vs Datenbank: Veranschaulichung der Unterschiede
Lee Easton, Präsident des Data-as-a-Service-Anbieters AeroVision.io, empfiehlt eine Werkzeuganalogie, um die Unterschiede zu verstehen. Dabei sind Ihre Daten die Werkzeuge, die Sie nutzen können. Stellen Sie sich einen Werkzeugschuppen in Ihrem Garten vor. Sie lagern einige Werkzeuge – Daten – in einem Werkzeugkasten oder auf (relativ) organisierten Regalen. Dieses spezielle, zugängliche, organisierte Werkzeuglager ist Ihre Datenbank. Der Werkzeugschuppen, in dem all das gespeichert wird, ist Ihr Data Warehouse. Sie könnten viele (und viele!) Werkzeugkästen in der Werkstatt haben. Einige Werkzeugkästen könnten Ihnen gehören, aber Sie könnten Werkzeugkästen Ihrer Freunde oder Nachbarn lagern, solange Ihr Schuppen groß genug ist. Auch wenn Sie ihre Werkzeuge lagern, bewahren Ihre Nachbarn sie in ihren eigenen Werkzeugkästen organisiert auf. Aber was, wenn deine Freunde keine Werkzeugkasten nutzen, um alle ihre Werkzeuge zu speichern? Sie haben sie einfach dort hineingeworfen, unorganisiert, unklar, wofür manche Werkzeuge gedacht sind – das ist dein Data Lake. In einem Data Lake sind die Daten roh und unorganisiert, wahrscheinlich unstrukturiert. Alle Rohdaten aus dem Data Lake, die nicht in Regale (Datenbanken) oder ein organisiertes System (Data Warehouses) organisiert wurden, sind kaum ein Werkzeug – in Rohform sind diese Daten nicht nützlich.
Vergleich der Datenspeicherung
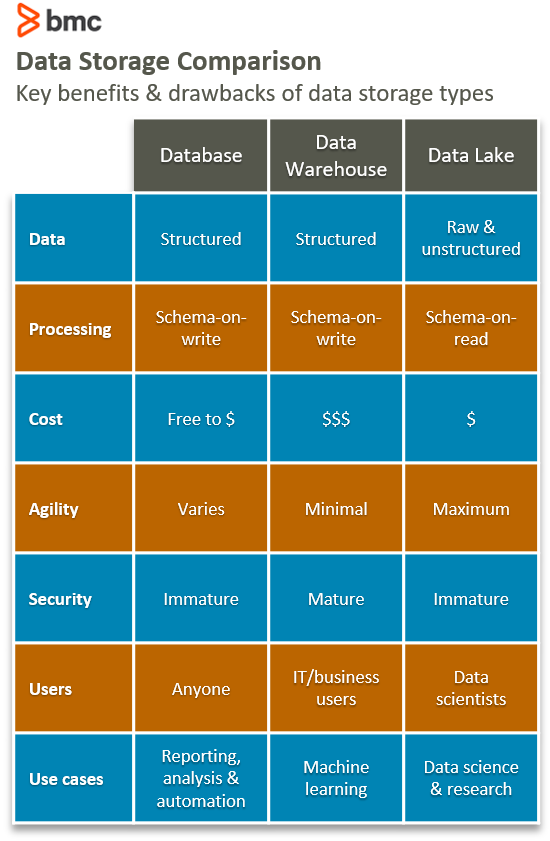
Jetzt, da wir die Konzepte beherrscht haben, schauen wir uns die Unterschiede zwischen Datenbanken, Data Warehouses und Data Lakes in sechs Schlüsselbereichen an.
Daten
Datenbanken und Data Warehouses können nur Daten speichern, die bereits strukturiert wurden. Ein Data Lake hingegen respektiert Daten nicht wie ein Data Warehouse und eine Datenbank. Er speichert alle Arten von Daten: strukturierte, halbstrukturierte oder unstrukturierte. Alle drei Datenspeicherorte können heiße und kalte Daten verarbeiten, aber kalte Daten eignen sich in der Regel am besten in Data Lakes, wo die Latenz kein Problem darstellt. (Mehr zur Latenz unten.)
Verarbeitung
Bevor Daten in ein Data Warehouse geladen werden können, müssen sie eine gewisse Form und Struktur haben – also ein Modell. Der Prozess, Daten eine Form und Struktur zu geben, nennt man Schema-on-Write. Eine Datenbank verwendet ebenfalls den Schema-on-Write-Ansatz. Ein Data Lake hingegen akzeptiert Daten in ihrer Rohform. Wenn Sie Daten benötigen, müssen Sie ihnen Form und Struktur geben. Dies nennt man Schema-on-Read, eine ganz andere Art, Daten zu verarbeiten.
Kosten
Eine der attraktivsten Eigenschaften von Big-Data-Technologien sind die Kosten für die Datenspeicherung. Die Datenspeicherung mit Big-Data-Technologien ist relativ günstiger als die Lagerung in einem Data Warehouse. Das liegt daran, dass Datentechnologien oft Open Source sind, sodass Lizenzierung und Community-Unterstützung kostenlos sind. Die Datentechnologien sind darauf ausgelegt, auf kostengünstiger Standardhardware installiert zu werden. Die Speicherung eines Data Warehouse kann teuer sein, besonders wenn das Datenvolumen groß ist. Ein Data Lake hingegen ist für kostengünstige Speicherung konzipiert. Eine Datenbank hat flexible Speicherkosten, die je nach Bedarf entweder hoch oder niedrig sein können.
Agilität
Ein Data Warehouse ist eine hochstrukturierte Datenbank mit einer festen Konfiguration und wenig Agilität. Die Änderung der Struktur ist zumindest technisch gesehen nicht allzu schwierig, aber das ist zeitaufwendig, wenn man alle bereits an das Warehouse gebundenen Geschäftsprozesse berücksichtigt. Ebenso sind Datenbanken aufgrund ihrer strukturierten Natur weniger agil zu konfigurieren. Im Gegensatz dazu fehlt einem Data Lake die Struktur. Diese Agilität macht es Datenentwicklern und Data Scientists leicht, Datenmodelle, Abfragen und Anwendungen einfach zu konfigurieren und neu zu konfigurieren. (Das erklärt, warum Datenexperten – nicht Laien – hauptsächlich in Data Lakes arbeiten: für Forschung und Testing. Das Fehlen einer Struktur hält Nicht-Experten fern.)
Sicherheit
Data-Warehouse-Technologien, im Gegensatz zu Big Data-Technologien, existieren und werden seit Jahrzehnten verwendet. Data Warehouses sind viel ausgereifter und sicherer als Data Lakes. Big Data-Technologien, die Data Lakes integrieren, sind relativ neu. Deshalb ist die Fähigkeit, Daten in einem Data Lake zu sichern, noch unausgereift. Überraschenderweise sind Datenbanken oft weniger sicher als Warehouses. Das liegt wahrscheinlich daran, wie Datenbanken für kleine Datensätze entwickelt wurden – nicht an den heutigen Big-Data-Anwendungsfällen. Glücklicherweise entwickelt sich die Datensicherheit rasant.
Nutzer
Data Warehouses, Data Lakes und Datenbanken eignen sich für verschiedene Nutzer:
- Datenbanken sind sehr flexibel und somit für jeden Nutzer geeignet.
- Data Warehouses werden hauptsächlich in der Geschäftswelt von Fachleuten genutzt.
- Data Lakes werden hauptsächlich in wissenschaftlichen Bereichen von Data Scientists genutzt.
Vorsicht bei Datenseen
Unternehmen setzen Data Lakes ein, manchmal anstelle von Data Warehouses. Aber Data Lake sind nicht frei von Nachteilen und Schwächen. Neue Technologien bringen oft Herausforderungen mit sich – manche vorhersehbar, andere nicht. Data Lakes sind da keine Ausnahme. Data Lakes sind nicht fehleranfällig. Stattdessen sollten Unternehmen, die sich in Data Lakes einlassen, dies mit Vorsicht tun.
Nachteile von Data Lake
Data Lakes lösen nicht alle Ihre Datenprobleme. Tatsächlich können sie das Feuer noch weiter aufs Wasser treiben und mehr Probleme schaffen, als sie eigentlich lösen sollten. Das liegt daran, dass Data Lakes oft Best Practices für Daten übersehen.
- Data Lakes ermöglichen es Ihnen, alles zu speichern, ohne zu hinterfragen, ob Sie alle Daten benötigen. Dieser Ansatz ist fehlerhaft, weil es einem Data Lake-Nutzer schwerfällt, Wert aus den Daten zu ziehen.
- Data Lakes priorisieren nicht, welche Daten in eine Lieferkette gelangen und wie diese Daten nützlich sind. Dieser Mangel an Datenpriorisierung erhöht die Kosten von Data Lakes (im Vergleich zu Data Warehouses und Datenbanken) und verwässert jede Klarheit darüber, welche Daten benötigt werden. Das verlangsamt oder stoppt sogar Ihren gesamten Analyseprozess. Vermeiden Sie dieses Problem, indem Sie Daten zusammenfassen und darauf reagieren , bevor Sie sie in Data Lakes speichern.
- Die Datenlatenz ist in Data Lakes höher. Data Lakes werden häufig für Berichterstattung und Analysen verwendet; jede Verzögerung bei der Datenerhebung beeinflusst Ihre Analyse. Die Latenz bei Daten verlangsamt interaktive Antworten und damit auch die Taktfrequenz Ihrer Organisation. Ihr Grund für diese Daten und die Geschwindigkeit, auf sie zuzugreifen, sollten entscheiden, ob die Daten besser in einem Data Warehouse oder einer Datenbank gespeichert sind.
- Data Lakes haben keine Regeln, die überwachen, was sie aufnehmen dürfen, was Ihr organisatorisches Risiko erhöht. Die Tatsache, dass Sie alle Ihre Daten speichern können, unabhängig von deren Herkunft, setzt Sie einer Vielzahl regulatorischer Risiken aus. Multiplizieren Sie dies auf alle Nutzer des Data Lake innerhalb Ihrer Organisation. Das Fehlen einer Datenpriorisierung verschärft Ihr Compliance-Risiko zusätzlich.
- Data Lakes fördern eine Datenüberlastung. Zu viele unpriorisierte Daten erzeugen Komplexität, was zu mehr Kosten und Verwirrung für Ihr Unternehmen führt – und wahrscheinlich zu wenig Mehrwert. Organisationen sollten Data Lakes nicht allein anstreben; stattdessen sollten Data Lakes nur im Rahmen einer umfassenden Datenstrategie genutzt werden, die mit umsetzbaren Lösungen übereinstimmt.
Daten sind nur dann wertvoll, wenn sie genutzt werden können, um Entscheidungen zeitnah zu treffen. Ein Nutzer oder ein Unternehmen, das Daten analysieren will, die in einem Data Lake gespeichert sind, verbringt viel Zeit damit, diese zu finden und für Analysen vorzubereiten – das genaue Gegenteil von Dateneffizienz für datengetriebene Abläufe. Stattdessen sollten Sie Daten immer aus der Perspektive der Lieferkette betrachten: Anfang, Mitte und Ende. Unabhängig von den Daten sollten Sie immer eine Strategie planen, wie Sie:
- Finden Sie die Daten
- Daten in die organisatorische Datenspeicherung bringen
- Erkunden und transformieren Sie die Daten
Ein solcher Ansatz ermöglicht es, die Wertoptimierung aus Daten zu extrahieren.
Die Zukunft liegt bei Data Warehouses
Wenn Data Warehouses zugunsten von Data Lakes vernachlässigt wurden, könnten sie ein Comeback erleben. Das hat laut Mark Cusack, CTO von Yellowbrick, zwei Hauptgründe:
- Data-Warehouse-Unternehmen verbessern das Cloud-Erlebnis für Verbraucher und machen es am einfachsten, Ihr Warehouse mit wenig bis gar keinem administrativen Aufwand zu versuchen, zu kaufen und zu erweitern.
- Data Warehousing wird im Bereich maschinelles Lernen und KI von entscheidender Bedeutung werden. Das liegt daran, dass das Potenzial von ML auf aktuellen Daten basiert, sodass diese Daten am besten in Lagern – nicht in Seen – gespeichert werden.
Bei der Entwicklung von Machine-Learning-Modellen verbringen Sie etwa 80 % dieser Zeit damit, die Daten vorzubereiten. Warehouses verfügen über integrierte Transformationsfunktionen, die die Datenvorbereitung besonders im Big-Data-Maßstab einfach und schnell durchzuführen machen. Und diese Warehouses können Funktionen und Funktionen in Analyseprojekten wiederverwenden, was bedeutet, dass Sie ein Schema über verschiedene Funktionen hinweg anlegen können. Das reduziert Duplikation und erhöht Ihre Datenqualität.
Da Unternehmen maschinelles Lernen und Data Science annehmen, werden Data Warehouses zum wertvollsten Werkzeug in Ihrem Datenwerkzeug-Schuppen.
Welche Datenspeicherlösung ist die richtige für mich?
Wenn es um Datenbanken, Data Warehouses oder Data Lakes geht, hängt die richtige Wahl von Ihrem Anwendungsfall und den Bedürfnissen Ihrer Organisation ab. Einige Organisationen nutzen alle drei Ansätze, um verschiedene Datennutzungen zu unterstützen. Der hybride Ansatz balanciert Flexibilität, Skalierung und Leistung, um eine wachsende Anzahl von Anwendungsfällen kosteneffizient zu unterstützen.
- Wenn Ihre Organisation Transaktionen effizient in Echtzeit abwickeln muss, sind Datenbanken ideal.
- Wenn Sie Business-Intelligence-Analysen und Berichte aus großen Mengen strukturierter und semistrukturierter Daten unterstützen müssen, bietet ein Data Warehouse Leistung und Leistung.
- Wenn Sie große Mengen vielfältiger Rohdaten verwenden und fortschrittliche Analytik, maschinelles Lernen oder Big-Data-Verarbeitung anwenden, ist ein Data Lake am besten bedient.
BMC für Datenlösungen
BMCs preisgekröntes Control-M ist ein Industriestandard für Unternehmensautomatisierung und Orchestrierung. Und unsere brandneue SaaS-Lösung Control-M Saas bietet Ihnen dieselbe Organisation, Kontrolle und Orchestrierung – in der Cloud.
Zusätzliche Ressourcen
Für mehr zu diesem Thema entdecken Sie diese Ressourcen:
- BMC Machine Learning & Big Data Blog
- 3 Schlüssel zum Aufbau widerstandsfähiger Datenpipelines
- Befähigung des Citizen Data Scientist
- Dark Data: Die Grundlagen und die Herausforderungen
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.