




Auf einen Blick: Datenmaskierung ist eine Sicherheitstechnik, die sensible Informationen verschleiert, während deren Benutzerfreundlichkeit erhalten bleibt – entscheidend für die Einhaltung von Vorschriften wie der DSGVO. Techniken umfassen statische und dynamische Maskierung, Verschlüsselung und Substitution, wobei jede spezifische Bedürfnisse beim Schutz von Daten berücksichtigt.
- Datenmaskierung schützt sensible Informationen und verhindert unbefugten Zugriff.
- Es ist entscheidend, dass Organisationen effektive Best Practices für Maskierung einführen, um die Datensicherheit zu gewährleisten.
Datenpannen weltweit legen jedes Jahr Millionen sensible Daten von Menschen frei, wodurch viele Unternehmen Millionen verlieren. Tatsächlich im Jahr 2024, die durchschnittlichen Kosten einer Datenpanne war 4 Dollar.88 Millionen. Personenbezogene Daten (PII) sind die teuerste Art von Daten unter allen kompromittierten Datentypen. Daher ist Datenschutz für viele Organisationen zur obersten Priorität geworden. Deshalb ist Datenmaskierung zu einer unverzichtbaren Technik geworden, die viele Unternehmen benötigen, um ihre sensiblen Daten zu schützen.
Was ist Datenmaskierung?
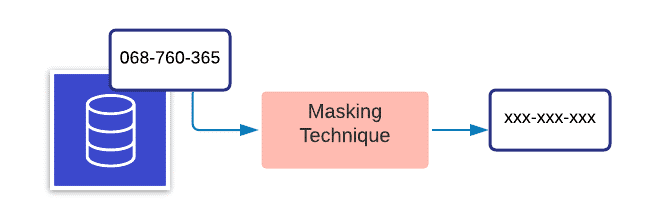
Datenmaskierung, auch bekannt als Datenverschleierung, verbirgt die tatsächlichen Daten mithilfe modifizierter Inhalte wie Zeichen oder Zahlen. Das Hauptziel der Datenmaskierung ist es, eine alternative Version von Daten zu schaffen, die nicht leicht identifizierbar oder rückentwickelt werden kann, um als sensibel eingestufte Daten zu schützen. Wichtig ist, dass die Daten über mehrere Datenbanken hinweg konsistent sind und die Benutzerfreundlichkeit unverändert bleibt. Es gibt viele Datentypen, die Sie mit Maskierung schützen können, aber gängige Datentypen, die für Datenmaskierung geeignet sind, sind:
- PII: Persönlich identifizierbare Informationen
- PHI: Geschützte Gesundheitsinformationen
- PCI-DSS: Zahlungskarteninformationen
- ITAR: Geistiges Eigentum
Datenmaskierung gilt im Allgemeinen für nicht-produktive Umgebungen wie Softwareentwicklung und -tests, Benutzerschulungen usw. – Bereiche, die keine tatsächlichen Daten benötigen. Sie können verschiedene Techniken zur Maskierung verwenden, die wir in den folgenden Abschnitten dieses Artikels besprechen werden. (Sehen Sie sich unsere Big-Data - und Datensicherheitserklärungen an.)
Bedeutung der Datenmaskierung
Datenmaskierung ist für Unternehmen auf verschiedene Weise wichtig:
- Hilft Unternehmen, die Einhaltung der Datenschutz-Grundgesetze (DSGVO) zu gewährleisten, indem das Risiko sensibler Datenexposition eliminiert wird. Aus diesem Grund bietet Datenmaskierung vielen Organisationen einen Wettbewerbsvorteil.
- Macht Daten für Cyberangreifer nutzlos und bewahrt gleichzeitig ihre Benutzerfreundlichkeit und Konsistenz.
- Verringert die Risiken im Zusammenhang mit dem Teilen der Daten mit integrierten Drittanbieteranwendungen und Cloud-Migrationen.
- Vermeidet Risiken, die mit der Auslagerung eines Projekts verbunden sind. Da die meisten Organisationen beim Umgang mit ausgelagerten Personen lediglich auf Vertrauen vertrauen, verhindert das Maskieren den Missbrauch oder Diebstahl von Daten.
Arten der Datenmaskierung
Es gibt verschiedene Arten von Datenmaskierung, die du je nach Anwendungsfall verwenden kannst. Von den vielen sind statische und spontane Datenmaskierung am gebräuchlichsten.
Statische Datenmaskierung (SDM)
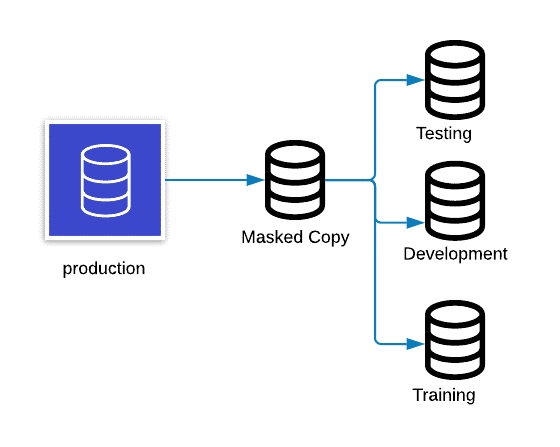
Statische Datenmaskierung funktioniert in der Regel auf einer Kopie einer Produktionsdatenbank. SDM ändert die Daten so, dass sie genau aussehen, um genau zu entwickeln, zu testen und zu trainieren – ohne die tatsächlichen Daten preiszugeben. Der Prozess läuft wie folgt ab:
- Mach ein Backup oder eine goldene Kopie der Produktionsdatenbank in eine andere Umgebung.
- Entferne unnötige Daten und maskiere sie während der Stase.
- Speichere die maskierte Kopie an der gewünschten Stelle.
Dynamische Datenmaskierung (DDM)
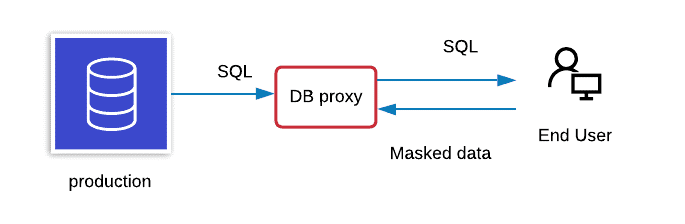
DDM erfolgt dynamisch zur Laufzeit und streamt Daten direkt aus einem Produktionssystem, sodass maskierte Daten nicht in einer anderen Datenbank gespeichert werden müssen. Es wird hauptsächlich für die Verarbeitung rollenbasierter Sicherheit von Anwendungen verwendet, wie zum Beispiel die Bearbeitung von Kundenanfragen und die Verarbeitung medizinischer Unterlagen. Daher gilt DDM für Nur-Lese-Szenarien, um zu verhindern, dass maskierte Daten zurück ins Produktionssystem zurückgeschrieben werden. Man kann DDM mit einem Datenbankproxy implementieren, der die Anfragen in die Originaldatenbank verändert und die maskierten Daten an die anfordernde Partei weiterleitet. Mit DDM muss man eine maskierte Datenbank nicht im Voraus vorbereiten, aber die Anwendung kann Leistungsbehinderungen haben.
Deterministische Datenmaskierung
Deterministische Datenmaskierung beinhaltet das Ersetzen von Spaltendaten durch denselben Wert. Wenn es zum Beispiel eine Vornamenspalte in deiner Datenbank gibt, die aus mehreren Tabellen besteht, könnten viele Tabellen mit dem Vornamen vorhanden sein. Wenn du 'Adam' zu 'James' maskierst, solltest du nicht nur in der maskierten Tabelle, sondern auch in allen zugehörigen Tabellen als 'James' angezeigt werden. Immer wenn du die Maskierung ausführst, erhältst du dasselbe Ergebnis.
On-the-fly Datenmaskierung
On-the-fly-Datenmaskierung tritt auf, wenn Daten von Produktionsumgebungen in eine andere Umgebung wie Test oder Entwicklung übertragen werden. On-the-fly-Datenmaskierung ist ideal für Organisationen, die:
- Software kontinuierlich bereitstellen
- Intensive Integrationen
Da es schwierig ist, eine Sicherungskopie maskierter Daten kontinuierlich zu speichern, sendet dieser Prozess bei Bedarf nur eine Teilmenge der maskierten Daten.
Statistische Datenverschleierung
Die Produktionsdaten können unterschiedliche statistische Informationen enthalten, die statistische Datenverschleierungstechniken tarnen können. Differenzielle Privatsphäre ist eine Technik, bei der man Informationen über Muster in einem Datensatz teilen kann, ohne Informationen über die tatsächlichen Personen im Datensatz preiszugeben.
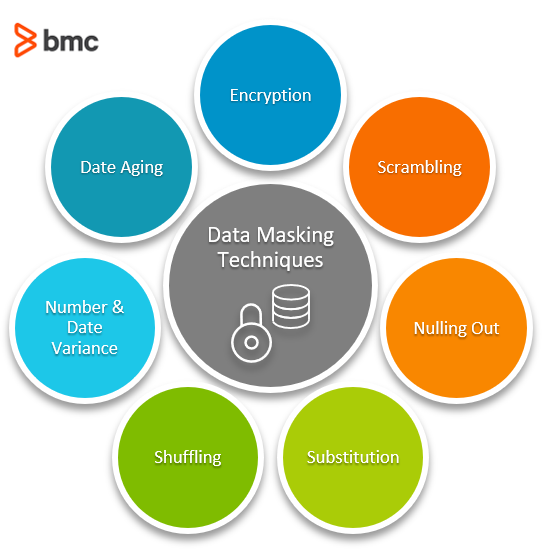
Datenmaskierungstechniken
Schauen wir uns nun Techniken zur Datenmaskierung an.
Verschlüsselung
Verschlüsselung ist die komplexeste – und sicherste – Art der Datenmaskierung. Hier verwendet man einen Verschlüsselungsalgorithmus, der die Daten maskiert und einen Schlüssel (Verschlüsselungsschlüssel) benötigt, um die Daten zu entschlüsseln. Verschlüsselung eignet sich besser für Produktionsdaten, die in ihren ursprünglichen Zustand zurückkehren müssen. Die Daten sind jedoch sicher, solange nur autorisierte Benutzer den Schlüssel besitzen. Wenn eine unautorisierte Partei kompromittiert, können die Schlüssel die Daten entschlüsseln und die tatsächlichen Daten einsehen. Daher ist eine ordnungsgemäße Verwaltung des Verschlüsselungsschlüssels entscheidend.
Scrambling
Scrambling ist eine grundlegende Maskierungstechnik, bei der die Zeichen und Zahlen in einer zufälligen Reihenfolge vermischt werden, um den ursprünglichen Inhalt zu verbergen. Obwohl dies eine einfache Technik ist, kann man sie nur auf bestimmte Datentypen anwenden, und sie macht sensible Daten nicht so sicher, wie man erwarten würde. Wenn zum Beispiel ein Mitarbeiter mit der ID-Nummer 934587 in einer Produktionsumgebung das Zeichen-Scrambling durchführt, liest er 489357 in einer anderen Umgebung. Jeder, der sich an die ursprüngliche Reihenfolge erinnert, kann jedoch möglicherweise trotzdem ihren ursprünglichen Wert entschlüsseln.
Nulling
Das Nullieren maskiert die Daten, indem ein Nullwert auf eine Datenspalte angewendet wird, sodass ein unbefugter Benutzer die tatsächlichen Daten darin nicht sieht. Dies ist eine weitere einfache Technik, aber die Hauptprobleme sind, dass sie:
- Verringert die Datenintegrität
- Macht das Testen und die Entwicklung mit solchen Daten schwieriger
Auswechslung
Substitution bedeutet, die Daten zu maskieren, indem sie durch einen anderen Wert ersetzt werden. Dies ist eine der effektivsten Methoden zur Datenmaskierung, die das ursprüngliche Aussehen nach dem Gefühl der Daten bewahrt. Die Substitutionstechnik kann auf verschiedene Datentypen angewendet werden. Zum Beispiel das Maskieren von Kundennamen mit einer zufälligen Abfragedatei. Das kann ziemlich schwierig sein, aber es ist eine sehr effektive Methode, Daten vor Sicherheitsverletzungen zu schützen.
Rascheln
Das Mischen ähnelt der Substitution, verwendet jedoch dieselbe individuelle Maskierungsdatenspalte für das zufällige Mischen. Zum Beispiel das Mischen von Mitarbeiternamen über mehrere Mitarbeiterdatensätze hinweg. Die Ausgabedaten sehen wie genaue Daten aus, zeigen aber keine tatsächlichen persönlichen Informationen. Wenn jedoch jemand den Mischalgorithmus kennenlernt, sind gemischte Daten anfällig für Reverse Engineering.
Nummern- und Datumsabweichung
Die Methode der Zahlen- und Datenvarianz ist anwendbar, um wichtige Finanz- und Transaktionsdaten zu verbergen. Zum Beispiel zeigt das Maskieren der Spalte Mitarbeitergehälter mit der Mitarbeitergehaltsvarianz die Gehälter zwischen den höchsten und niedrigsten bezahlten Mitarbeitern. Sie können die Bedeutungsvollität des Datensatzes sicherstellen, indem Sie die Varianz von etwa +/- 10 % auf alle Gehälter im Set anwenden.
Datumsreifung
Diese Maskierungstechnik vergrößert oder verringert ein Datumsfeld basierend auf der definierten Datenmaskenrichtlinie mit einem akzeptablen Datumsbereich. Zum Beispiel würde die Verringerung des Geburtsdatums um 1000 Tage das Datum '1. Januar 2021' auf '07. April 2018' ändern.
Beispiele für Datenmaskierung
Die folgenden Beispiele zeigen, wie verschiedene Techniken zur Maskierung von Daten funktionieren:
- Maskierung von Kundendaten im Finanzdienstleistungsbereich: Sie müssen möglicherweise Kreditkartennummern, Sozialversicherungsnummern und andere sensible Daten schützen, wenn Sie diese mit anderen teilen. Eine Kreditkartennummer 4111-1234-5678-9012 kann so verschleiert werden, dass sie wie 4111-XXXX-XXXX-9012 aussieht.
- Datenschutz von Patientendaten im Gesundheitswesen: Verschiedene Vorschriften wie HIPAA und Rahmenwerke wie Abschnitt 405(d) des Health Care Cybersecurity and Resiliency Act verlangen den Schutz von Patientendaten. Sie können die Daten weiterhin verwenden, wenn Sie sie maskieren. Zum Beispiel kann ein Patient namens "John Winston", geboren am 15. Mai 2001, als "Patient 1234" getarnt werden, geboren am "05.XX.2001".
- Mitarbeitergehaltsanonymisierung für HR-Analysen: Ihre Organisation möchte möglicherweise Gehaltstrends analysieren, aber die Privatsphäre einzelner Mitarbeiter wahren. Sie können den Namen des Mitarbeiters mit einer Nummer wie "Emp 001" maskieren und dessen Gehalt mit dieser Kennung verknüpfen.
- Datenmaskierung im Softwaretest für E-Commerce: Es kann hilfreich sein, Systeme mit realistischen Daten zu testen, aber Sie müssen echte Kundendaten sicher halten. Sie können beispielsweise eine Versandadresse als "123 Test Street, Test City, TS, 99999" maskieren.
Best Practices zur Datenmaskierung
Bereit, mit dem Maskieren von Daten zu beginnen? Hier sind einige Best Practices, denen Sie folgen sollten.
Identifizieren Sie die sensiblen Daten
Bevor Sie Daten maskieren, identifizieren und katalogisieren Sie die:
- Standort sensibler Daten
- Autorisierte Person(en), die sie einsehen können
- Ihre Verwendung
Jedes einzelne Datenelement eines Unternehmens benötigt keine Maskierung. Stattdessen sollten vorhandene sensible Daten sowohl in Produktions- als auch in Nicht-Produktionsumgebungen gründlich identifiziert werden. Je nach Datenkomplexität und Organisationsstruktur kann dies erhebliche Zeit in Anspruch nehmen.
Definieren Sie Ihren Stack von Datenmasking-Techniken
Es ist für große Unternehmen nicht praktikabel, im gesamten Unternehmen nur ein einziges Maskierungswerkzeug zu verwenden, da die Daten stark variieren. Außerdem kann die gewählte Technik erfordern, dass Sie bestimmte interne Sicherheitsrichtlinien einhalten oder Budgetanforderungen erfüllen. In manchen Fällen müssen Sie Ihre Maskierungstechnik entwickeln. Berücksichtigen Sie also all diese notwendigen Faktoren, um die richtigen Techniken auszuwählen. Halten Sie sie synchron, um sicherzustellen, dass derselbe Datentyp dieselbe Technik verwendet, um die referenzielle Integrität zu bewahren.
Sichere deine Datenmaskierungstechniken
Maskierungstechniken und zugehörige Daten sind genauso wichtig wie sensible Daten. Zum Beispiel kann die Substitutionstechnik eine Nachschlagedatei für die Substitution verwenden. Wenn diese Nachschlagedatei in falsche Hände gerät, kann sie den ursprünglichen Datensatz offenbaren. Organisationen sollten die erforderlichen Richtlinien festlegen, damit nur autorisierte Personen Zugriff auf die Maskierungsalgorithmen erhalten.
Mach das Maskieren wiederholbar
Im Laufe der Zeit können Änderungen an einer Organisation oder einem bestimmten Projekt oder einem Produkt zu Änderungen an den Daten führen. Vermeiden Sie es, jedes Mal von vorne anzufangen. Stattdessen sollten Sie das Maskieren zu einem wiederholbaren, schnellen und automatischen Prozess machen, damit Sie ihn umsetzen können, wenn Änderungen an sensiblen Daten auftreten.
Definieren Sie einen End-to-End-Datenmaskierungsprozess
Organisationen müssen einen End-to-End-Prozess haben, der Folgendes umfasst:
- Identifizierung sensibler Informationen
- Anwendung der passenden Datenmaskierungstechnik
- Kontinuierliche Audits, um sicherzustellen, dass die Datenmaskierung wie erwartet funktioniert
Datenmaskierung ist unerlässlich
Datenmaskierung ist ein wesentlicher Prozess für viele Organisationen, die sensible Daten schützen, indem sie deren Authentizität verbergen.
Verwandte Literatur
- BMC Machine Learning & Big Data Blog
- Datenethik für Unternehmen
- KI-Cyberangriffe und wie sie funktionieren, erklärt
- Salting vs. Stretching von Passwörtern für Unternehmenssicherheit
- 7 geschäftskritische IT-Richtlinien und deren Umsetzung
- IT-Best Practices: Die beste Einführung
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.