




Auf einen Blick: Datenorchestrierung ist entscheidend für die Automatisierung und Verwaltung von Datenabläufen in einem DataOps-Framework und steigert die operative Effizienz. Sie verbindet Aufgaben in eine kohärente Pipeline und gewährleistet Zuverlässigkeit sowie eine schnelle Wiederherstellung von Ausfällen.
- Datenorchestrierung automatisiert die Aufgabenplanung und Abhängigkeiten.
- Best Practices umfassen die Erstellung von Sub-DAGs für eine einfachere Verwaltung und die Möglichkeit der Single-Click-Wiederherstellung.
Datenorchestrierung ist der Prozess der Koordination und Automatisierung des Datenflusses über komplexe Pipelines hinweg – Verwaltung von Aufgabenabhängigkeiten, Planung, Fehlerbehandlung und End-to-End-Wiederherstellung . In einem DataOps-Framework ist Datenorchestrierung die grundlegende Schicht, die fragmentierte, ad-hoc-Datenoperationen in zuverlässige, wiederholbare Workflows verwandelt. Gemeinsam bieten Datenorchestrierung und DataOps den Data-Engineering-Teams die Geschwindigkeit, Governance und operative Strenge, die nötig sind, um datengetriebene Plattformen in großem Umfang zu bauen und aufrechtzuerhalten.
Warum benötigen Organisationen DataOps?
Alle Organisationen wollen datengetrieben sein, aber es gibt eine erhebliche Lücke zwischen diesem Ziel und der Umsetzung. Neue Technologien sind unreif und nicht kampferprobt – es ist die Operationalisierung von Technologie, die der wahre Weg zur Datengetriebenheit ist.
Die meisten Datenteams planen nicht für den "Tag 2" – den Zeitraum, der nach Abschluss der Entwicklung und dem Bereitstellen in die Produktion beginnt . Haben sie einen End-to-End-Prozess zur Bereitstellung von Artefakten? Haben sie Funktions-, Performance-, Last- und Stresstests durchgeführt? Sind sie bereit, Produktionsänderungen zurückzufahren, falls Probleme auftreten, während sie die Lichter am Laufen halten?
Die Diskrepanz zwischen dem Betrieb von POCs und POVs mit aufkommenden Technologien und der erfolgreichen Umsetzung realer Anwendungsfälle in die Produktion ist weit verbreitet. Die meisten der beitragenden Ursachen können durch die fehlende Komponente in der Datenökonomie adressiert werden: DataOps. Viele Organisationen praktizieren DataOps, jedoch auf ad-hoc-, fragmentierte Weise – ohne Leitlinien, Spezifikationen oder einen formalisierten Prozess aufgebaut.
Dateninfrastrukturen – von Aufnahme, Speicherung bis zur Verarbeitung – werden über verteilte Systeme verteilt bereitgestellt: On-Premises, Public und Private Cloud, Hybrid- und Edge-Umgebungen. Diese Umgebungen sind eine komplexe Mischung aus Servern, virtuellen Maschinen, Netzwerken, Speicher und CPU, in denen Ausfälle unvermeidlich sind. Organisationen benötigen Werkzeuge und Prozesse, die schnell eine Ursachenanalyse durchführen und die mittlere Wiederherstellungszeit (MTTR) reduzieren können.
DataOps beseitigt Lücken, Ineffizienzen und Fehlanpassungen in jedem Schritt von der Datenproduktion bis zum Konsum. Es koordiniert und orchestriert Entwicklung und Operationalisierung auf kollaborative, strukturierte und agile Weise – was es Organisationen ermöglicht, die Datenbereitstellung zu optimieren, die Produktivität durch Automatisierung zu steigern und datengetriebene Anwendungen mit Vertrauen und Governance bereitzustellen.
Was ist DataOps?
DataOps optimiert und automatisiert Datenprozesse und -abläufe, um den Aufbau von Datenprodukten und -lösungen zu beschleunigen und Organisationen dabei zu unterstützen, datengetrieben zu werden . Das Ziel von DataOps ist es, von Ad-hoc-Datenpraktiken zu einem formalisierten Data-Engineering-Ansatz mit einem kontrollierten Rahmenwerk zur Verwaltung von Prozessen und Aufgaben überzugehen.
DataOps wird durch einen formalen Satz von Prozessen und Tools realisiert , die Probleme erkennen, verhindern und mindern, die während der Entwicklung und Produktion von Pipelines auftreten. DataOps wendet CI/CD-Prinzipien an, um agile Datenpipelines zu entwickeln und fördert die Wiederverwendbarkeit durch Datenversionierung, um die Integration von Datenproduzenten bis zu Konsumenten kollaborativ zu steuern. Es reduziert außerdem die End-to-End-Zeit und Kosten für den Aufbau, Bereitstellung und Fehlersuche bei Datenplattformen und -diensten.
Für Organisationen, die in digitale Transformation mit Analyse, KI und ML investieren, ist DataOps eine unverzichtbare Praxis zur Freischaltung von Datenressourcen und zur Verbesserung der Entscheidungsfindung. DataOps ermöglicht Innovation durch Dezentralisierung – und eine Plattform zur Datenorchestrierung und Automatisierung von Workflows bietet die zentrale Koordination, die disaggregierte Datenwerkzeuge in eine kohärene, geregelte Pipeline verwandelt. Globale Orchestrierung über gemeinsame Infrastruktur mit interdomänenübergreifenden Abhängigkeiten und Durchsetzung von Richtlinien zu bewältigen.
Warum benötigen Organisationen Datenorchestrierung?
Datenorchestrierung ist notwendig, weil kein einzelnes Tool die volle Komplexität eines modernen Datenstacks bewältigt. Das Datenökosystem bietet heute eine reiche Landschaft von Werkzeugen, Frameworks und Bibliotheken – einige über klar definierte APIs zugänglich, andere über Kommandozeilen aufgerufen –, die alle zusammengefügt werden müssen, um end-to-end-datengetriebene Systeme zu erstellen.
Die meisten Organisationen verwalten nicht nur eine Handvoll Pipelines – sie verwalten Dutzende oder Hunderte, mit komplexen Bereitstellungsmodellen, die von Edge über On-Premises bis hin zu mehreren Cloud-Rechenzentren reichen. Komponenten laufen in verschiedenen Rechenzentren, die auf verteilten Architekturen basieren, wobei Unterkomponenten über Server und virtuelle Maschinen verteilt sind. Jeder Handshaking-Punkt ist ein potenzieller Ausfallpunkt, von Netzwerkstörungen bis hin zu Serverausfällen.
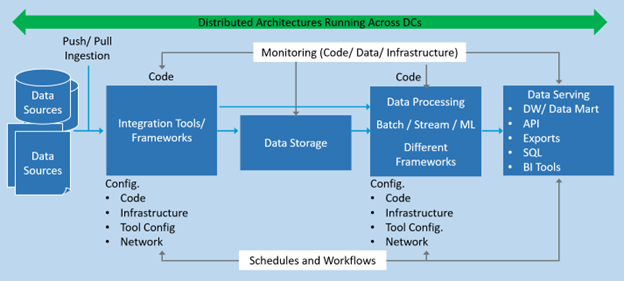
Beim Aufbau dieser Pipelines müssen Data Engineers sicherstellen, dass der Pipeline-Code wie vorgesehen ausgeführt wird, die Best Practices des Data Engineering einhält und sowohl den Happy Path als auch das Ausfallszenario behandelt. Das Ziel ist es, jede Komponente so zu koordinieren, dass die gesamte Pipeline resilient ist, Failover unterstützt und sich vom Ausfallpunkt erholt.
Produktionspipelines sind komplex – mehrere Forks, Abhängigkeiten und Trigger-Logik, die alle von der Planungs- und Workflow-Engine des Orchestrators verwaltet werden. Die Datenorchestrierung steuert und koordiniert Arbeitsabläufe über mehrere Stakeholder hinweg, verfolgt die Ausführungshistorie, löst Jobs aus, erzwingt Aufgabenabhängigkeiten und protokolliert Aktionen mit vollständigen Audit-Traces zur Fehlersuche. Die wichtigsten Funktionen, die von Data Engineers und Data Scientists gewünscht werden, umfassen Benutzerfreundlichkeit, Überwachung und starke Pipeline-Observabilität – alles bereitgestellt durch eine gut implementierte Datenorchestrierungsschicht.
Was ist Datenorchestrierung?
Datenorchestrierung ist der Klebstoff zwischen Aufgaben im gesamten Datenstack. Sie verwaltet Abhängigkeiten, koordiniert Aufgaben in definierten Workflows, plant die Ausführung, verwaltet Ausgaben und behandelt Ausfallszenarien. Der Orchestrierungsprozess steuert den Datenfluss gemäß Orchestrierungsregeln und Geschäftslogik, plant und führt die mit jedem Datenstrom verbundenen Workflows aus.
Diese Flussstruktur wird als Abhängigkeitsgraph dargestellt, auch DAG (gerichteter azyklischer Graph) genannt. Datenorchestrierung ist der Prozess, Aufgaben in eine Kette logischer Schritte zu verbinden, die eine gut koordinierte End-to-End-Datenpipeline bildet .
Datenorchestratatoren lassen sich in zwei Typen einteilen: aufgabengetrieben und datengesteuert. Ein aufgabengetriebener Orchestrator konzentriert sich ausschließlich auf die Reihenfolge der Workflow-Ausführung, ohne zu wissen, welche Daten in jedem Schritt ein- oder austreten. Ein datengetriebener Orchestrator geht noch weiter – er ist sich der Daten, die zwischen den Aufgaben fließen, bewusst, einschließlich Artefaktausgaben, die versionskontrolliert und mit automatisierten Tests verknüpft werden können.
Ein guter Data Orchestrator ermöglicht es Datenteams, Fehler und Fehler schnell zu isolieren. Data Orchestrators können durch zeitbasierte Zeitpläne oder benutzerdefinierte Ereignislogik ausgelöst werden, und die für Datendomänen benötigte Infrastruktur kann in eine Self-Service-Infrastruktur als Plattform integriert werden, die über ein DataOps-Framework verwaltet wird.
Was sind Best Practices für Datenorchestrierung?
Die Datenorchestrierung sollte konfigurationsgesteuert sein, um Portabilität sicherzustellen – was auch ein Kernprinzip einer breiteren Workflow-Orchestrierungsplattform ist, die den gesamten Anwendungs- und Datenpipeline-Stack abdeckt.
Eine effektive Datenorchestrierung erfordert bewusste Designentscheidungen. Die folgenden Maßnahmen verbessern die Widerstandsfähigkeit von Pipelines, die Portabilität und die Rückgewinnbarkeit.
Entkoppeln DAGs in Unter-DAGs
Zerlegt komplexe Abhängigkeitsgraphen in die einfachsten möglichen Sub-DAGs. Kleinere, fokussierte Sub-DAGs lassen sich leichter testen, umgehen und unabhängig erneut ausführen, wenn ein Fehler auftritt.
Machen Sie DAGs fehlertolerant
Entwickle Sub-DAGs so, dass, falls eine Komponente ausfällt, sie ohne das komplette Ausführen der gesamten Pipeline von Anfang an erneut ausgeführt werden kann.
Verwenden Sie konfigurationsgesteuerte Orchestrierung
Konfigurationsgetriebene Datenorchestrierung gewährleistet Portabilität über Umgebungen hinweg und unterstützt Wiederholbarkeit und Reproduzierbarkeit – entscheidend für Teams, die Pipelines in Entwicklung, Staging und Produktion verwalten.
Ein-Klick-Wiederherstellung mit Checkpoints aktivieren
Datenorchestrierungsprozesse sollten Checkpoints enthalten, die eine Single-Click-Wiederherstellung vom Fehlerpunkt aus unterstützen, mit der Möglichkeit, fehlgeschlagene Aufgaben mit einer konfigurierbaren Backoff-Strategie erneut zu versuchen.
Fazit
Unternehmen sollten keine Datenplattformen für datengetriebene Entscheidungsfindung aufbauen, ohne vorher die Prinzipien von Data Engineering und DataOps zu integrieren. Diese synergetischen Fähigkeiten bieten Organisationen die Prozessformalität und Geschwindigkeit , die für die Skalierung erforderlich sind, und reduzieren langfristig Daten- und technische Verschuldungen . Datenorchestrierung ist keine optionale Ebene – sie ist die Kernsäule, auf der produktionsfähiges DataOps aufgebaut ist.
Häufig gestellte Fragen
Was ist der Unterschied zwischen Datenorchestrierung und Datenintegration?
Datenintegration ist der Prozess, Daten aus mehreren Quellen zu einer einheitlichen Ansicht zu kombinieren. Datenorchestrierung verwaltet den breiteren Workflow – Planung, Sequenzierung, Abhängigkeitsdurchsetzung, Fehlerbehandlung und Wiederherstellung – über die gesamte Datenpipeline hinweg. Datenintegrationsaufgaben laufen typischerweise als Schritte innerhalb eines größeren Datenorchestrierungs-Workflows.
Was ist ein DAG in der Datenorchestrierung?
Ein DAG, oder gerichteter azyklischer Graph, ist die Abhängigkeitsstruktur, die in der Datenorchestrierung verwendet wird, um die Beziehungen zwischen Pipeline-Aufgaben darzustellen . Jeder Knoten in einem DAG ist eine Aufgabe; jede Kante definiert eine Abhängigkeit zwischen Aufgaben. Die "azyklische" Eigenschaft bedeutet, dass keine zirkulären Abhängigkeiten existieren, was Pipelines vorhersehbar und leichter zu debuggen macht.
Was ist der Unterschied zwischen aufgabengetriebener und datengetriebener Orchestrierung?
Ein aufgabengetriebener Orchestrator verwaltet die Workflow-Ausführungsreihenfolge ohne Kenntnis der Daten, die zwischen den Schritten fließen. Ein datengetriebener Orchestrator ist sich der Daten- und Artefaktausgaben in jeder Phase bewusst – was Versionskontrolle, automatisierte Tests und eine stärkere Datenlinienverfolgung in der gesamten Pipeline ermöglicht.
Wie unterstützt Datenorchestrierung ein DataOps-Framework ?
Datenorchestrierung ist der operative Kern eines DataOps-Frameworks . Sie automatisiert die Ausführung von Pipelines, erzwingt Aufgabenabhängigkeiten, behandelt Fehler mit Wiederherstellungs-Logik und stellt vollständige Audit-Traces für die Governance bereit. Ohne Datenorchestrierung bleiben DataOps-Praktiken ad hoc und lassen sich schwer über komplexe, multi-umfeldübergreifende Dateninfrastrukturen skalieren.
Was löst einen Datenorchestrierungs-Workflow aus?
Datenorchestrierungs-Workflows werden auf zwei Hauptarten ausgelöst: auf einem zeitbasierten Zeitplan (wie stündliche oder nächtliche Batch-Jobs) oder durch benutzerdefinierte ereignisbasierte Logik (wie eine neue Datendatei, die eintrifft, oder eine Upstream-Pipeline, die abgeschlossen wird). Die meisten Enterprise-Orchestratoren unterstützen beide Trigger-Typen innerhalb einer einzigen Pipeline-Konfiguration.
Die in diesem Beitrag geäußerten Ansichten und Meinungen sind die des Autors und spiegeln nicht unbedingt die offizielle Position von BMC wider.
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.