




Auf einen Blick: Eine automatisierte maschinelle Lernpipeline zur Erkennung von Finanzbetrug mit Amazon SageMaker und Control-M erhöht Effizienz und Genauigkeit durch integrierte Datenprozesse. Die Lösung nutzt verschiedene AWS-Dienste, um sich an sich entwickelnde Betrugsmuster anzupassen.
- Nutzt Modelle wie logistische Regression und Entscheidungsbäume für optimale Betrugserkennung.
- Implementierung von End-to-End-Automatisierung mit Control-M für effizientes Workflow-Management.
BMC & AWS Logo
BMC & AWS Logo
Modelltraining und -evaluation sind grundlegend für die Erkennung von Zahlungsbetrug, da die Effektivität eines auf maschinellem Lernen (ML)-basierten Betrugserkennungssystems von seiner Fähigkeit abhängt, betrügerische Transaktionen genau zu identifizieren und gleichzeitig Fehlalarme zu minimieren. Angesichts des hohen Volumens, der Geschwindigkeit und der sich wandelnden Natur von Finanzbetrug sind richtig geschulte und kontinuierlich bewertete Modelle unerlässlich, um Genauigkeit und Effizienz zu gewährleisten. Betrugserkennung erfordert einen skalierbaren, automatisierten und effizienten Ansatz zur Analyse umfangreicher Transaktionsdatensätze und zur Identifizierung betrügerischer Aktivitäten.
Dieser Blog präsentiert eine ML-gestützte Betrugserkennungspipeline, die auf Amazon Web Services (AWS)-Lösungen – Amazon SageMaker, Amazon Redshift, Amazon EKS und Amazon Athena – basiert und mittels Control-M orchestriert wird, um nahtlose Automatisierung, Terminplanung und Workflow-Management in einer produktionsbereiten Umgebung sicherzustellen. Das Ziel ist es, drei Modelle – logistische Regression, Entscheidungsbaum und Multi-Layer-Perzeptron (MLP)-Klassifikator – über drei Vektoren zu trainieren – Präzision, Rückruf und Genauigkeit. Die Ergebnisse helfen dabei, zu entscheiden, welches Modell in die Produktion gebracht werden kann.
Während Modelltraining und -evaluation das Ergebnis sind, sind Training und Evaluation Teil der größeren Pipeline. In diesem Blog integriert die repräsentierte Pipeline die Automatisierung in jeder Phase, von der Datenextraktion und -vorverarbeitung bis hin zu Modelltraining, -evaluation und Ergebnisvisualisierung. Durch die Nutzung der Orchestrierungsfähigkeiten von Control-M sorgt der Workflow für minimale manuelle Eingriffe, optimierte Ressourcennutzung und effiziente Ausführung voneinander abhängiger Aufgaben.
Prozessfluss:
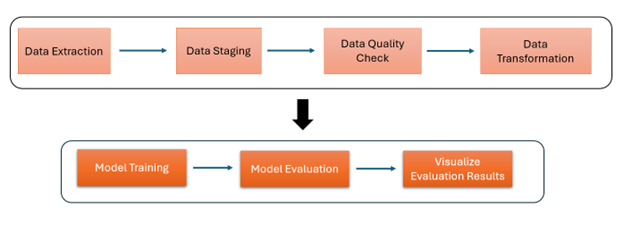
Wichtige architektonische Höhepunkte sind:
- Automatisierte Datenextraktion und -übertragung von Amazon Redshift zu Amazon S3 mittels Control-M Managed File Transfer (MFT)
- Orchestrierte Datenvalidierung und -vorverarbeitung mit AWS Lambda und Kubernetes (Amazon EKS)
- Automatisiertes Modelltraining und -auswertung in Amazon SageMaker mit skalierbaren Rechenressourcen
- Geplante Leistungsüberwachung und Visualisierung mit Amazon Athena und QuickSight
- End-to-End-Workflow-Orchestrierung mit Control-M, was Fehlertoleranz, Abhängigkeitsmanagement und optimierte Planung ermöglicht
In Produktionsumgebungen ist die manuelle Ausführung von ML-Pipelines aufgrund der Komplexität der Verarbeitung groß angelegter Daten, Modell-Retraininging-Zyklen und kontinuierlicher Überwachung nicht machbar. Durch die Integration von Control-M für die Workflow-Orchestrierung gewährleistet diese Lösung Skalierbarkeit, Effizienz und Echtzeit-Betrugserkennung und reduziert den operativen Overhead. Der Blog behandelt außerdem Best Practices, Sicherheitsaspekte und Erkenntnisse, die Organisationen dabei unterstützen, ihre Betrugserkennungssysteme mit robusten Automatisierungs- und Orchestrierungsstrategien aufzubauen und zu optimieren.
Der Kerndienst in diesem Workflow ist Amazon SageMaker – und durch die Nutzung der Control-M SageMaker-Integration zur Orchestrierung von SageMaker-ML-Pipelines erhalten Teams über den gesamten Modelltrainingszyklus Enterprise-Planung, Abhängigkeitsmanagement und Audit-Trails hinweg. Wir haben unseren ML-Workflow mit Amazon SageMaker Pipelines automatisiert, das ein leistungsstarkes Framework für die Orchestrierung komplexer ML-Workflows bietet. Das Ergebnis ist eine Betrugserkennungslösung, die die Kraft der Kombination von AWS' ML-Fähigkeiten mit seinen Datenverarbeitungs- und Speicherdiensten demonstriert. Dieser Ansatz beschleunigt nicht nur die Entwicklung, sondern gewährleistet auch Skalierbarkeit und Zuverlässigkeit in Produktionsumgebungen.
Datensatzübersicht
Der für diese Übung verwendete Datensatz stammt von Kaggle und bietet eine ausgezeichnete Grundlage zur Bewertung der Modellleistung an realweltähnlichen Daten.
Der für diese Analyse verwendete Kaggle-Datensatz bietet eine synthetische Darstellung finanzieller Transaktionen, die reale Komplexitäten reproduzieren und betrügerisches Verhalten integriert. Abgeleitet vom PaySim-Simulator, der aggregierte Daten aus Finanzprotokollen eines mobilen Gelddienstes in einem afrikanischen Land verwendet, ist der Datensatz eine unschätzbare Ressource für Betrugserkennung und Finanzanalyse.
Der Datensatz enthält folgende Merkmale:
- Schritt: Zeiteinheit in Stunden über einen simulierten Zeitraum von 30 Tagen.
- Typ: Transaktionstypen wie CASH-IN, CASH-OUT, DEBIT, ZAHLUNG und TRANSFER.
- Betrag: Transaktionswert in lokaler Währung
- nameOrig: Der Kunde initiiert die Transaktion.
- oldbalanceOrg/newbalanceOrig: Saldo vor und nach der Transaktion für den initiierenden Kunden.
- nameDest: Empfänger der Transaktion.
- oldbalanceDest/newbalanceDest: Saldo vor und nach der Transaktion für den Empfänger.
- isFraud: Identifiziert Transaktionen mit betrügerischen Aktivitäten.
- isFlagedFraud: Markiert unautorisierte großflächige Übertragungen.
Architektur
Die Pipeline hat folgende Architektur und wird mit Control-M orchestriert.
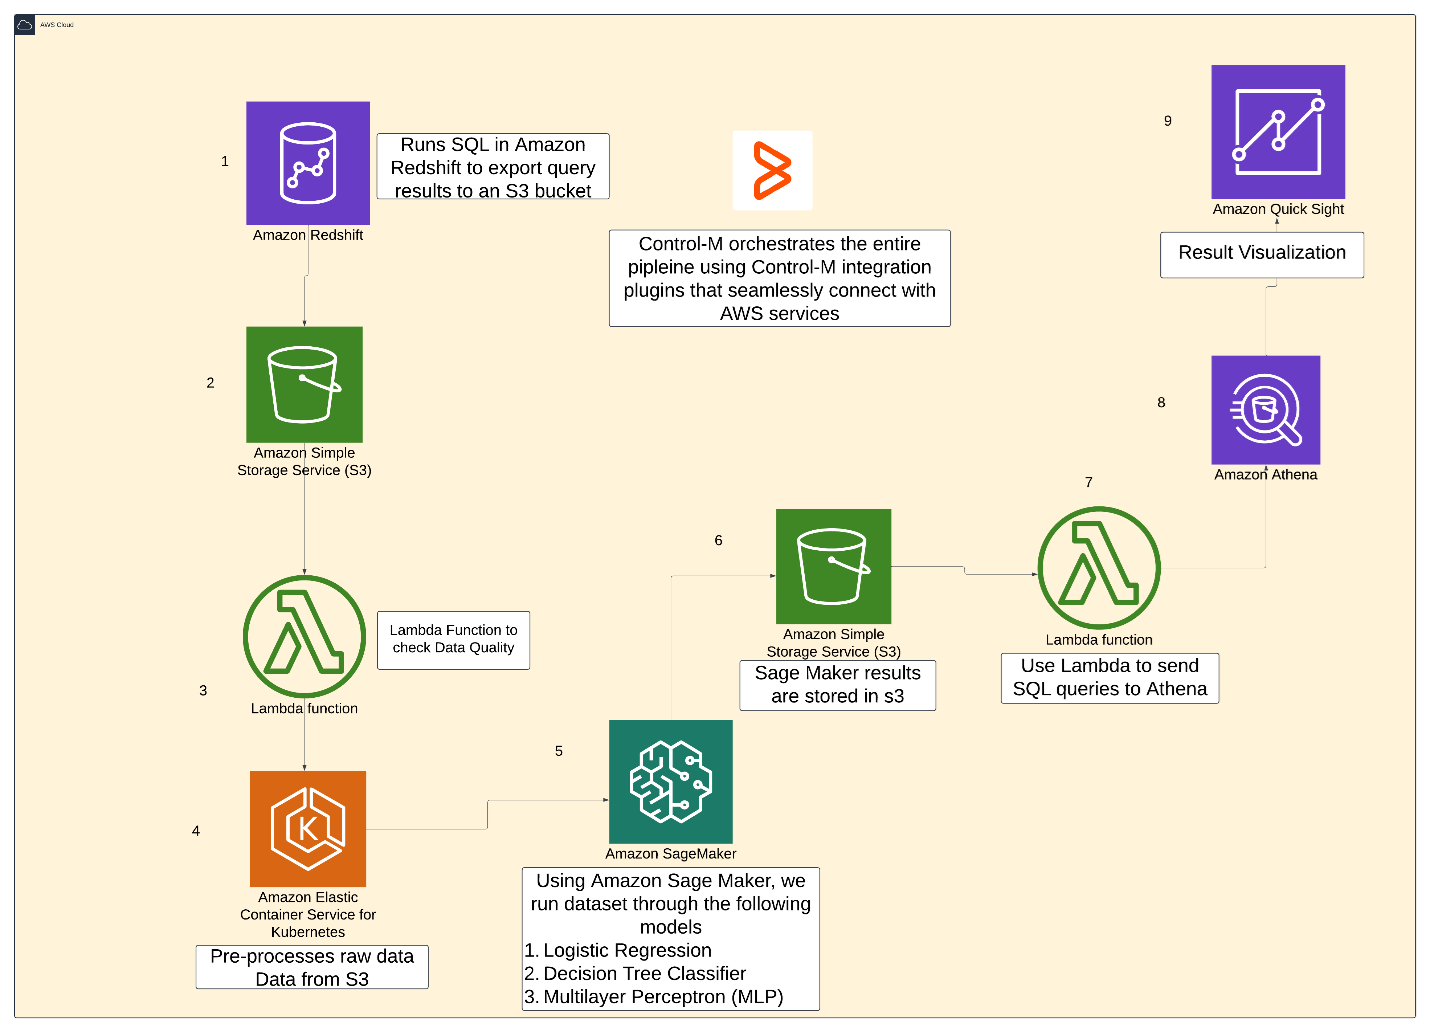
Amazon SageMaker:
Hinweis: Alle verwendeten Code-Artefakte sind unter diesem Link verfügbar.
Control-M-Integrations-Plug-ins in dieser Architektur verwendet
Um diese Analysepipeline zu orchestrieren, nutzen wir Control-M-Integrations-Plug-ins, die nahtlos mit verschiedenen Plattformen und Diensten verbunden sind, darunter:
-
- Control-M für SageMaker:
- Führt ML-Modell-Trainingsaufträge auf Amazon SageMaker aus.
- Ermöglicht die Integration mit SageMaker, um Trainingsaufträge auszulösen, den Fortschritt zu überwachen und Ausgaben abzurufen.
- Control-M für Kubernetes:
- Führt Python-Skripte für Datenverarbeitung und Normalisierung in einer Amazon EKS-Umgebung aus.
- Ideal, um containerisierte Jobs im Rahmen des Datenvorbereitungsprozesses auszuführen.
- Control-M verwaltete Dateiübertragung:
- Erleichtert den Dateiwechsel zwischen Amazon S3-Buckets und anderen Speicherdiensten.
- Gewährleistet sichere und automatisierte Datenübertragungen zur Vorbereitung auf die Analyse.
- Control-M-Datenbanken:
- Ermöglicht eine optimierte Jobplanung und Ausführung von SQL-Skripten, gespeicherten Prozeduren und Datenbankverwaltungsaufgaben über mehrere Datenbankplattformen hinweg und gewährleistet so Automatisierung und Konsistenz bei den Datenbankoperationen.
- Control-M für AWS Lambda:
- Ermöglicht eine nahtlose Planung und Ausführung von AWS Lambda-Funktionen, sodass Nutzer serverlose Workflows automatisieren, ereignisgesteuerte Prozesse auslösen und cloudbasierte Aufgaben effizient verwalten können.
- Gewährleistet die Orchestrierung, Überwachung und Automatisierung der Lambda-Funktionen innerhalb breiterer Unternehmensabläufe, verbessert die operative Effizienz und reduziert manuelle Eingriffe
- Control-M für SageMaker:
AWS-Dienste in dieser Architektur verwendet
- Amazon S3: Amazon S3 ist ein vollständig verwalteter Objektspeicherdienst.
- Amazon SageMaker: Amazon SageMaker ist ein vollständig verwalteter ML-Dienst.
- Amazon EKS: Amazon Elastic Kubernetes Service (Amazon EKS) ist ein vollständig verwalteter Kubernetes-Service, der es Ihnen ermöglicht, Kubernetes nahtlos sowohl in AWS Cloud als auch in lokalen Rechenzentren zu betreiben.
- Amazon Redshift: Amazon Redshift ist ein beliebtes Cloud Data Warehouse, das von AWS bereitgestellt wird.
Einrichtung der Kubernetes-Umgebung
Die Amazon EKS Kubernetes-Umgebung ist zentral für die Datenvorverarbeitungsphase der Pipeline. Sie führt Python-Skripte aus, um die Daten zu bereinigen, zu normalisieren und zu strukturieren, bevor sie an die ML-Modelle weitergegeben werden. Das Einrichten der Kubernetes-Umgebung umfasst folgende Schritte:
- Amazon EKS Cluster-Aufbau:
- Nutzen Sie Terraform, um einen Amazon EKS-Cluster zu erstellen oder richten Sie Ihre Kubernetes-Umgebung in einem beliebigen Cloud-Anbieter ein.
- Stellen Sie sicher, dass die Kubernetes-Knoten mit dem Cluster kommunizieren können und umgekehrt.
- Containerisiertes Python-Skript:
- Erstellen und übertragen Sie ein Container-Image in das Amazon Elastic Container Registry (ECR) für das Preprocessing-Skript.
- Deploye einen Kubernetes-Job, um das Skript auszuführen.
Eine ausführliche Anleitung zum Einrichten einer Kubernetes-Umgebung für ähnliche Workflows finden Sie in diesem Blog, in dem wir den Kubernetes-Einrichtungsprozess Schritt für Schritt beschrieben haben.
Für eine umfassende Anleitung zur Einrichtung von Snowflake in ähnlichen Pipelines siehe bitte diesen Blog.
Workflow-Zusammenfassung
- Redshift_Unload Job
- Aktion: Führt ein SQL-Skript (copy_into_s3.sql) aus, um strukturierte Daten aus Amazon Redshift zu extrahieren und in Amazon S3 zu speichern.
- Zweck: Bewegt Rohdaten in einen zugänglichen S3-Bucket für spätere Transformationen.
- Nächster Schritt: Löst S3_to_S3_Transfer aus, Daten vom Warehouse-Bucket in den Verarbeitungs-Bucket zu verschieben.
- S3_to_S3_Transfer Job
- Aktion: Verwendet Control-M's Managed File Transfer (MFT), um den Datensatz vom sam-sagemaker-warehouse-bucket in den bf-sagemaker-bucket zu verschieben.
- Zweck: Stellt sicher, dass die Daten am richtigen Ort für die Vorverarbeitung verfügbar sind, und benennt sie in Synthetic_Financial_datasets_log.csv.
- Nächster Schritt: Löst den Data_Quality_Check Job aus.
- Data_Quality_Check Beruf
- Aktion: Führt eine AWS Lambda-Funktion (SM_ML_DQ_Test) aus, um den Datensatz zu validieren.
- Zweck: Stellt sicher, dass die CSV-Datei mindestens 5 Spalten und mehr als 1000 Zeilen enthält und verhindert, dass beschädigte oder unvollständige Daten in die ML-Pipeline gelangen.
- Nächster Schritt: Löst EKS-Preprocessing-Job für Datentransformation aus.
- EKS-Preprocessing-Job
- Aktion: Führt einen Kubernetes-Job aus, um den in Amazon S3 gespeicherten Datensatz zu bereinigen und zu transformieren.
- Zweck:
- Führt ein Python-Skript (main.py) in einem Container aus, um Synthetic_Financial_datasets_log.csv zu verarbeiten
- Erzeugt einen bereinigten und strukturierten Datensatz (verarbeitete Daten/output.csv).
- Konfigurationsdetails:
- Bild: new-fd-repo gespeichert in Amazon ECR
- Umweltvariablen: Definiert S3-Eingabe-/Ausgabe-Dateistandorte
- Ressourcenzuweisung: Verwendet 2Gi-Speicher, 1 CPU (skaliert bis zu 4Gi Speicher, 2 CPUs)
- IAM-Berechtigungen: Verwendet ein Kubernetes-Servicekonto für den Zugriff auf S3
- Logging & Bereinigung: Logs abgerufen und der Job nach Abschluss gelöscht
- Nächster Schritt: Löst den Amazon SageMaker Trainingsjob aus.
- Amazon SageMaker_TE_Pipeline
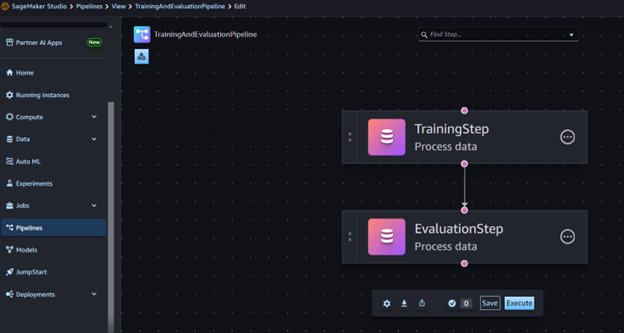
- Aktion: Führt die TrainingAndEvaluation-Pipeline in Amazon SageMaker durch.
- Zweck:
- Trainiert und evaluiert mehrere ML-Modelle auf dem vorverarbeiteten Datensatz (verarbeitete Daten/output.csv).
- Speichert trainierte Modellartefakte und Bewertungsmetriken in einem S3-Bucket.
- Gewährleistet automatische Ressourcenskalierung für effiziente Verarbeitung.
- Nächster Schritt: Triggert Load_Amazon_Athena_Table, um Ergebnisse in Athena für die Visualisierung zu speichern.
- Load_Amazon_Athena_Table Job
- Aktion: Führt eine AWS-Lambda-Funktion (athena-query-lambda) aus, um die Auswertungsmetriken in Amazon Athena zu laden.
- Zweck:
- Führt eine SQL-Abfrage aus, um eine Athena-Tabelle (evaluation_metrics) zu erstellen oder zu aktualisieren.
- Ermöglicht es QuickSight , die Modellleistungsergebnisse abzufragen und zu visualisieren.
Wie die Schritte verbunden sind
- Redshift → S3-Übertragung: Die Daten werden aus Amazon Redshift extrahiert und zu Amazon S3 übertragen.
- Datenvalidierung und Vorverarbeitung: Die Qualitätsprüfung der Daten stellt sicher, dass die Eingabe vor der Transformation mit Kubernetes sauber ist.
- ML-Training: Amazon SageMaker trainiert und bewertet mehrere ML-Modelle.
- Integration von Athena und QuickSight: Die Ergebnisse der Modellbewertung werden über Athena abgerufen, was eine Echtzeitvisualisierung in Amazon QuickSight ermöglicht.
- Endergebnis: Ein optimierter, automatisierter ML-Workflow, der ein trainiertes Modell und Leistungseinblicke für weitere Entscheidungsprozesse liefert.
Diese detaillierte Workflow-Zusammenfassung verknüpft jeden Schritt und hebt gleichzeitig die entscheidenden Rollen des Kubernetes-Preprocessing-Jobs und der Amazon SageMaker Trainingspipeline hervor.
S3_to_S3_Transfer Job
Data_Quality_Check Job
EKS-Preprocessing-Job
Load_Amazon_Athena_Table Job
Zusammenfassung
Control-M-Workflow-Definition
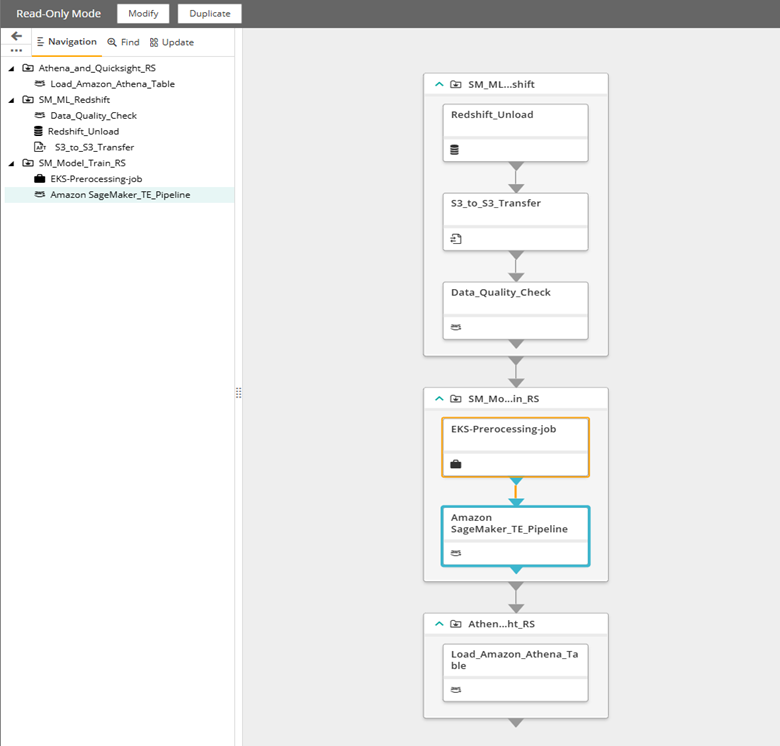
Im nächsten Abschnitt werden wir die Definition jedes dieser Jobs durchgehen. Die Jobs können mit einem Drag-and-Drop-No-Code-Ansatz im Planungsbereich von Control-M definiert werden oder als Code in JSON definiert werden. Für die Zwecke dieses Blogs verwenden wir den as-Code-Ansatz.
Amazon Redshift und Dateiübertragungs-Workflows
Redshift_Unload Job
Typ: Job:Datenbank:SQLScript
Aktion: Führt ein SQL-Skript in Amazon Redshift aus, um Daten aus Redshift-Tabellen in einen S3-Bucket zu entladen.
Beschreibung: Dieser Job führt ein vordefiniertes SQL-Skript (copy_into_s3.sql) aus, das auf dem Control-M-Agenten gespeichert ist, um strukturierte Daten von Redshift in Amazon S3 zu exportieren. Die entladenen Daten werden für die spätere Verarbeitung in der ML-Pipeline vorbereitet.
Abhängigkeiten: Der Auftrag läuft unabhängig, löst aber nach erfolgreichem Abschluss das Copy_into_bucket-TO-S3_to_S3_MFT-262-Ereignis aus.
Wichtige Konfigurationsdetails: Redshift SQL-Skriptausführung
SQL-Skript:
Ereignishandhabung
Wichtige Konfigurationsdetails:
Wichtige Konfigurationsdetails:
Abhängigkeiten: Der Job läuft unabhängig, löst aber nach Abschluss das Ereignis sagemaker-preprocessing-job-TO-AWS_SageMaker_Job_1-751-262 aus, was signalisiert, dass die verarbeiteten Daten für das Modelltraining in SageMaker bereit sind.
Wichtige Konfigurationsdetails:
Wichtige Konfigurationsdetails:
Wichtige Konfigurationsdetails:
    UNLOAD ('SELECT * FROM SageTable')
TO 's3://sam-sagemaker-warehouse-bucket/Receiving Folder/Payments_RS.csv'
IAM_ROLE 'arn:aws:iam::xyz:role/jogoldbeRedshiftReadS3'
FORMAT AS csv
HEADER
ALLOWOVERWRITE
PARALLEL OFF
DELIMITER ','
MAXFILESIZE 6GB; -- 1GB max per file
- Ereignisse, die ausgelöst werden:
- Copy_into_bucket-TO-S3_to_S3_MFT-262 → signalisiert, dass die Daten erfolgreich an S3 entladen wurden und bereit für weitere Verarbeitung oder Übertragungen sind.
Siehe ein Beispiel unten:
Siehe ein Beispiel unten:
Siehe ein Beispiel unten:
Siehe ein Beispiel unten:
Siehe ein Beispiel unten:
Siehe ein Beispiel unten:
    "Redshift_Unload" : {
"Type" : "Job:Database:SQLScript",
"ConnectionProfile" : "ZZZ-REDSHIFT",
"SQLScript" : "/home/ctmagent/redshift_sql/copy_into_s3.sql",
"Host" : "<>",
"CreatedBy" : "<>",
"RunAs" : "ZZZ-REDSHIFT",
"Application" : "SM_ML_RS",
"When" : {
"WeekDays" : [ "NONE" ],
"MonthDays" : [ "ALL" ],
"DaysRelation" : "OR"
},
"eventsToAdd" : {
"Type" : "AddEvents",
"Events" : [ {
"Event" : "Copy_into_bucket-TO-S3_to_S3_MFT-262"
} ]
}
}
Typ: Job:Dateiübertragung
Aktion: Übertragung einer Datei von einem S3-Bucket in einen anderen mittels Control-M Managed File Transfer (MFT).
Beschreibung: Dieser Job verschiebt einen Datensatz (Payments_RS.csv000) von sam-sagemaker-warehouse-bucket zu bf-sagemaker und benennt ihn dabei als Synthetic_Financial_datasets_log.csv um. Dadurch werden die Daten für weitere Verarbeitung und Validierung vorbereitet.
Abhängigkeiten: Der Job wartet auf Copy_into_bucket-TO-S3_to_S3_MFT-262, um sicherzustellen, dass die Daten erfolgreich aus Redshift exportiert und in S3 gespeichert wurden, bevor die Übertragung gestartet wird.
- Quelle-Eimer: sam-sagemaker-warehouse-bucket
- Quellpfad: /Receiving Folder/Payments_RS.csv000
- Zieleimer: bf-sagemaker
- Zielweg: /temp/
- Umbenannte Datei: Synthetic_Financial_datasets_log.csv am Ziel.
- Verbindungsprofile: Verwendet das MFTS3-Profil sowohl für die Quell- als auch die Ziel-S3-Buckets.
- Dateibeobachter: Überwacht die Quelldatei auf Bereitschaft mit einer mindestens erkannten Größe von 200 MB.
Ereignishandhabung
- Ereignisse, auf die Sie warten müssen:
- Copy_into_bucket-TO-S3_to_S3_MFT-262 → Stellt sicher, dass Daten von Redshift nach S3 exportiert wurden, bevor sie in einen anderen S3-Bucket übertragen werden.
- Ereignisse, die ausgelöst werden:
- S3_to_S3_MFT-TO-Data_Quality_Check → Teilt den nächsten Schritt mit, dass der Datensatz zur Validierung bereit ist.
- SM_ML_Snowflake_copy-TO-SM_Model_Train_copy → Signalisiert den Beginn des Modelltrainingsprozesses unter Verwendung der verarbeiteten Daten.
    "S3_to_S3_Transfer" : {
"Type" : "Job:FileTransfer",
"ConnectionProfileSrc" : "MFTS3",
"ConnectionProfileDest" : "MFTS3",
"S3BucketNameSrc" : "sam-sagemaker-warehouse-bucket",
"S3BucketNameDest" : "bf-sagemaker",
"Host" : : "<>",
"CreatedBy" : : "<>",
"RunAs" : "MFTS3+MFTS3",
"Application" : "SM_ML_RS",
"Variables" : [ {
"FTP-LOSTYPE" : "Unix"
}, {
"FTP-CONNTYPE1" : "S3"
}, {
"FTP-ROSTYPE" : "Unix"
}, {
"FTP-CONNTYPE2" : "S3"
}, {
"FTP-CM_VER" : "9.0.00"
}, {
"FTP-OVERRIDE_WATCH_INTERVAL1" : "0"
}, {
"FTP-DEST_NEWNAME1" : "Synthetic_Financial_datasets_log.csv"
} ],
"FileTransfers" : [ {
"TransferType" : "Binary",
"TransferOption" : "SrcToDestFileWatcher",
"Src" : "/Receiving Folder/Payments_RS.csv000",
"Dest" : "/temp/",
"ABSTIME" : "0",
"TIMELIMIT" : "0",
"UNIQUE" : "0",
"SRCOPT" : "0",
"IF_EXIST" : "0",
"DSTOPT" : "1",
"FailJobOnSourceActionFailure" : false,
"RECURSIVE" : "0",
"EXCLUDE_WILDCARD" : "0",
"TRIM" : "1",
"NULLFLDS" : "0",
"VERNUM" : "0",
"CASEIFS" : "0",
"FileWatcherOptions" : {
"VariableType" : "Global",
"MinDetectedSizeInBytes" : "200000000",
"UnitsOfTimeLimit" : "Minutes"
},
"IncrementalTransfer" : {
"IncrementalTransferEnabled" : false,
"MaxModificationAgeForFirstRunEnabled" : false,
"MaxModificationAgeForFirstRunInHours" : "1"
},
"DestinationFilename" : {
"ModifyCase" : "No"
}
} ],
"When" : {
"WeekDays" : [ "NONE" ],
"MonthDays" : [ "ALL" ],
"DaysRelation" : "OR"
},
"eventsToWaitFor" : {
"Type" : "WaitForEvents",
"Events" : [ {
"Event" : "Copy_into_bucket-TO-S3_to_S3_MFT-262"
} ]
},
"eventsToAdd" : {
"Type" : "AddEvents",
"Events" : [ {
"Event" : "S3_to_S3_MFT-TO-Data_Quality_Check"
} ]
},
"eventsToDelete" : {
"Type" : "DeleteEvents",
"Events" : [ {
"Event" : "Copy_into_bucket-TO-S3_to_S3_MFT-262"
} ]
}
},
"eventsToAdd" : {
"Type" : "AddEvents",
"Events" : [ {
"Event" : "SM_ML_Snowflake_copy-TO-SM_Model_Train_copy"
} ]
}
}
Typ: Job:AWS Lambda
Aktion: Führt eine AWS-Lambda-Funktion aus, um eine Datenqualitätsprüfung auf einer CSV-Datei durchzuführen.
Beschreibung: Dieser Job ruft die Lambda-Funktion SM_ML_DQ_Test auf, um die Struktur und Integrität des Datensatzes zu validieren. Er stellt sicher, dass die CSV-Datei mindestens 5 Spalten hat und mehr als 1.000 Zeilen enthält, bevor mit der nachgelagerten Verarbeitung fortgesetzt wird. Der Job protokolliert die Ausführung zur Prüfung.
Abhängigkeiten: Der Job wartet auf das Ereignis S3_to_S3_MFT-TO-Data_Quality_Check und stellt sicher, dass die Dateiübertragung zwischen den S3-Buckets abgeschlossen ist, bevor die Datenvalidierung durchgeführt wird.
- Lambda-Funktionsname: SM_ML_DQ_Test
- Ausführungsumgebung:
- Host: Läuft auf ip-172-31-18-169.us-west-2.compute.internal
- Verbindungsprofil: JOG-AWS-LAMBDA
- RunAs: JOG-AWS-LAMBDA
- Validierungskriterien:
- ✅ Die CSV-Datei muss mindestens 5 Spalten haben.
- ✅ Die CSV-Datei muss mehr als 1.000 Zeilen enthalten.
- Protokollierung: Aktiviert (Log an Ausgabe anhängen: aktiviert) für Debugging und Validierungsverfolgung.
Ereignishandhabung:
- Ereignisse, auf die Sie warten müssen:
- Der Job wartet darauf, dass S3_to_S3_MFT-TO-Data_Quality_Check bestätigt, dass der Datensatz erfolgreich übertragen wurde und zur Validierung verfügbar ist.
- Zu löschende Ereignisse:
- Das Ereignis S3_to_S3_MFT-TO-Data_Quality_Check wird nach der Verarbeitung gelöscht, um die Workflow-Kontinuität zu gewährleisten und eine Nachbearbeitung zu verhindern.
Ausführungsumgebung
Abhängigkeiten: Der Job wartet auf das Ereignis sagemaker-preprocessing-job-TO-AWS_SageMaker_Job_1-751-262 und stellt sicher, dass der Preprocessing-Job abgeschlossen ist und der bereinigte Datensatz verfügbar ist, bevor das Training beginnt.
Typ: Job:AWS Lambda
Aktion: Führt eine AWS-Lambda-Funktion aus, um Bewertungsergebnisse in eine Amazon-Athena-Tabelle zu laden, um weitere Abfragen und Visualisierungen durchzuführen.
Abhängigkeiten: Der Job wartet auf das Ereignis SM_Model_Train_copy TO-Athena_and_Quicksight_copy und stellt sicher, dass der SageMaker-Schulungs- und Bewertungsprozess abgeschlossen ist, bevor die Ergebnisse in Athena geladen werden.
    "Data_Quality_Check" : {
      "Type" : "Job:AWS Lambda",
      "ConnectionProfile" : "JOG-AWS-LAMBDA",
      "Append Log to Output" : "checked",
      "Function Name" : "SM_ML_DQ_Test",
      "Parameters" : "{}",
      "Host" : : "<>",
      "CreatedBy" : : "<>",
      "Description" : "This job performs a data quality check on CSV file to make sure it has at least 5 columns and more than 1000 rows",
      "RunAs" : "JOG-AWS-LAMBDA",
      "Application" : "SM_ML_RS",
      "When" : {
        "WeekDays" : [ "NONE" ],
        "MonthDays" : [ "ALL" ],
        "DaysRelation" : "OR"
      },
      "eventsToWaitFor" : {
        "Type" : "WaitForEvents",
        "Events" : [ {
          "Event" : "S3_to_S3_MFT-TO-Data_Quality_Check"
        } ]
      },
      "eventsToDelete" : {
        "Type" : "DeleteEvents",
        "Events" : [ {
          "Event" : "S3_to_S3_MFT-TO-Data_Quality_Check"
        } ]
      }
    }
Amazon SageMaker: Modelltrainings- und Bewertungs-Workflows
Typ: Job:Kubernetes
Aktion: Führt einen Kubernetes-Job auf einem Amazon-EKS-Cluster aus, um Finanzdaten, die in einem S3-Bucket gespeichert sind, vorzuverarbeiten.
Beschreibung: Dieser Job führt ein containerisiertes Python-Skript aus, das die in bf-sagemaker gespeicherten Roh-Finanzdatensätze verarbeitet. Er ruft die Eingabedatei Synthetic_Financial_datasets_log.csv ab, wendet notwendige Transformationen an und gibt den bereinigten Datensatz als verarbeitete Daten/output.csv aus. Der Kubernetes-Job sorgt für die angemessene Ressourcenzuweisung, Sicherheitsberechtigungen und das Logging zur Überwachung.
Kubernetes-Jobspezifikation
- Bild: 623469066856.dkr.ecr.us-west-2.amazonaws.com/new-fd-repo
- Befehlsausführung: Führt folgendes Skript im Container aus:
Bash
CopyEdit
python3 /app/main.py -b bf-sagemaker -i Synthetic_Financial_datasets_log.csv -o processed-data/output.csv
- Umweltvariablen:
- S3_BUCKET: BF-Sagemaker
- S3_INPUT_FILE: Synthetic_Financial_datasets_log.csv
- S3_OUTPUT_FILE: verarbeitete Daten/output.csv
Ressourcenallokation
- Angeforderte Ressourcen: 2Gi-Speicher, 1 CPU
- Grenzen: 4 Gi-Speicher, 2 CPUs
- Lautstärkehalterungen: Temporäre Lagerung montiert bei /tmp
- Host: Läuft auf mol-agent-installation-sts-0
- Verbindungsprofil: MOL-K8S-CONNECTION-PROFILE für EKS-Cluster-Zugriff
- Pod-Logs: Konfiguriert, um Logs nach Abschluss abzurufen (Get Pod Logs: Get Logs)
- Job-Cleanup: Löscht den Kubernetes-Job nach der Ausführung (Job-Cleanup: Job löschen)
Ereignishandhabung:
- Ereignisse, die ausgelöst werden:
- sagemaker-preprocessing-job-TO-AWS_SageMaker_Job_1-751-262 → Signalisiert, dass die vorverarbeiteten Daten für das SageMaker-Modelltraining bereit sind.
    "EKS-Prerocessing-job" : {
      "Type" : "Job:Kubernetes",
      "Job Spec Yaml" : "apiVersion: batch/v1\r\nkind: Job\r\nmetadata:\r\n  name: s3-data-processing-job\r\nspec:\r\n  template:\r\n    spec:\r\n      serviceAccountName: default  # Ensure this has S3 access via IAM\r\n      containers:\r\n      - name: data-processing-container\r\n        image: 623469066856.dkr.ecr.us-west-2.amazonaws.com/new-fd-repo\r\n        command: [\"/bin/sh\", \"-c\", \"python3 /app/main.py -b bf-sagemaker -i Synthetic_Financial_datasets_log.csv -o processed-data/output.csv\"]\r\n        env:\r\n        - name: S3_BUCKET\r\n          value: \"bf-sagemaker\"\r\n        - name: S3_INPUT_FILE\r\n          value: \"Synthetic_Financial_datasets_log.csv\"\r\n        - name: S3_OUTPUT_FILE\r\n          value: \"processed-data/output.csv\"\r\n        resources:\r\n          requests:\r\n            memory: \"2Gi\"\r\n            cpu: \"1\"\r\n          limits:\r\n            memory: \"4Gi\"\r\n            cpu: \"2\"\r\n        volumeMounts:\r\n        - name: tmp-storage\r\n          mountPath: /tmp\r\n      restartPolicy: Never\r\n      volumes:\r\n      - name: tmp-storage\r\n        emptyDir: {}\r\n\r\n",
      "ConnectionProfile" : "MOL-K8S-CONNECTION-PROFILE",
      "Get Pod Logs" : "Get Logs",
      "Job Cleanup" : "Delete Job",
      "Host" : : "<>",
      "CreatedBy" : : "<>",
      "RunAs" : "MOL-K8S-CONNECTION-PROFILE",
      "Application" : "SM_ML_RS",
      "When" : {
        "WeekDays" : [ "NONE" ],
        "MonthDays" : [ "ALL" ],
        "DaysRelation" : "OR"
      },
      "eventsToAdd" : {

        "Type" : "AddEvents",
        "Events" : [ {
          "Event" : "sagemaker-preprocessing-job-TO-AWS_SageMaker_Job_1-751-262"
        } ]
      }
    }
Amazon SageMaker_TE_Pipeline Job
Typ: Job: Amazon Sagemaker
Aktion: Führt eine Amazon Sagemaker Trainings- und Evaluierungspipeline aus, um ML-Modelle mit vorverarbeiteten Finanzdaten zu trainieren.
Beschreibung: Dieser Job führt die TrainingAndEvaluationPipeline aus, die ML-Modelle auf Basis des vorverarbeiteten Datensatzes trainiert und bewertet, der in bf-sagemaker gespeichert ist. Die Pipeline automatisiert Modelltraining, Hyperparameter-Optimierung und -bewertung und gewährleistet so eine optimale Leistung vor der Bereitstellung.
- Name der SageMaker-Pipeline: TrainingAndEvaluationPipeline
- Ausführungsumgebung:
- Host: Läuft auf Prodagents
- Verbindungsprofil: MOL-SAGEMAKER-CP für die Ausführung von SageMaker-Aufträgen
- RunAs: MOL-SAGEMAKER-CP
- Pipeline-Parameter:
- Parameter hinzufügen: nicht aktiviert (Standardeinstellungen verwendet)
- Pipeline-Ausführung erneut versuchen: nicht aktiviert (wird fehlgeschlagene Ausführungen nicht automatisch erneut versucht)
Ereignishandhabung:
- Ereignisse, auf die Sie warten müssen:
- sagemaker-preprocessing-job-TO-AWS_SageMaker_Job_1-751-262 → Stellt sicher, dass der vorbearbeitete Datensatz vor Beginn des Trainings verfügbar ist.
- Zu löschende Ereignisse:
- sagemaker-preprocessing-job-TO-AWS_SageMaker_Job_1-751-262 → Entfernt die Abhängigkeit, sobald das Training beginnt.
- SM_ML_Snowflake-TO-AWS_SageMaker_Job_1 → beseitigt frühere Ereignisabhängigkeiten.
    "Amazon SageMaker_TE_Pipeline" : {
      "Type" : "Job:AWS SageMaker",
      "ConnectionProfile" : "MOL-SAGEMAKER-CP",
      "Add Parameters" : "unchecked",
      "Retry Pipeline Execution" : "unchecked",
      "Pipeline Name" : "TrainingAndEvaluationPipeline",
      "Host" : : "<>",
      "CreatedBy" : : "<>",
      "RunAs" : "MOL-SAGEMAKER-CP",
      "Application" : "SM_ML_RS",
      "When" : {
        "WeekDays" : [ "NONE" ],
        "MonthDays" : [ "ALL" ],
        "DaysRelation" : "OR"
      },
      "eventsToWaitFor" : {
        "Type" : "WaitForEvents",
        "Events" : [ {
          "Event" : "sagemaker-preprocessing-job-TO-AWS_SageMaker_Job_1-751-262"
        } ]
      },
      "eventsToDelete" : {
        "Type" : "DeleteEvents",
        "Events" : [ {
          "Event" : "sagemaker-preprocessing-job-TO-AWS_SageMaker_Job_1-751-262"
        }, {
          "Event" : "SM_ML_Snowflake-TO-AWS_SageMaker_Job_1"
        } ]
      }
    }
Beschreibung: Dieser Job löst die Lambda-Funktion athena-query-lambda aus, die eine Athena-SQL-Abfrage ausführt, um eine Tabelle mit ML-Bewertungsmetriken zu erstellen oder zu aktualisieren. Die Tabelle ermöglicht eine nahtlose Integration mit Amazon QuickSight für Datenvisualisierung und Berichterstattung.
- Lambda-Funktionsname: athena-query-lambda
- Ausführungsumgebung:
- Moderator: Läuft mit Luftstromstoffen
- Verbindungsprofil: JOG-AWS-LAMBDA
- RunAs: JOG-AWS-LAMBDA
- Zweck des Athena-Tisches:
- Speichert Ergebnisse der ML-Modellbewertung, einschließlich Genauigkeit, Präzision und Abrufwerte.
- Ermöglicht eine einfache Abfrage von Leistungskennzahlen durch SQL-basierte Analyse.
- Bereitet Daten für die Visualisierung in Amazon QuickSight vor.
Ereignishandhabung:
- Ereignisse, auf die Sie warten müssen:
- SM_Model_Train_copy-TO-Athena_and_Quicksight_copy → Stellt sicher, dass der Schulungs- und Bewertungsprozess von SageMaker abgeschlossen ist, bevor Athena aktualisiert wird.
- Zu löschende Ereignisse:
- SM_Model_Train_copy-TO-Athena_and_Quicksight_copy → Beseitigt die Ereignisabhängigkeit nach erfolgreichem Laden der Daten.
    "Load_Amazon_Athena_Table" : {
      "Type" : "Job:AWS Lambda",
      "ConnectionProfile" : "JOG-AWS-LAMBDA",
      "Function Name" : "athena-query-lambda",
      "Parameters" : "{}",
      "Append Log to Output" : "unchecked",
      "Host" : "airflowagents",
      "CreatedBy" : "[email protected]",
      "RunAs" : "JOG-AWS-LAMBDA",
      "Application" : "SM_ML_RS",
      "When" : {
        "WeekDays" : [ "NONE" ],
        "MonthDays" : [ "ALL" ],
        "DaysRelation" : "OR"
      }
    },

    "eventsToWaitFor" : {
      "Type" : "WaitForEvents",
      "Events" : [ {
        "Event" : "SM_Model_Train_copy-TO-Athena_and_Quicksight_copy"
      } ]
    },
    "eventsToDelete" : {
      "Type" : "DeleteEvents",
      "Events" : [ {
        "Event" : "SM_Model_Train_copy-TO-Athena_and_Quicksight_copy"
      } ]
    }
  }
WORKFLOW-AUSFÜHRUNG:
Schulungs- und Bewertungsschritte in Amazon SageMaker
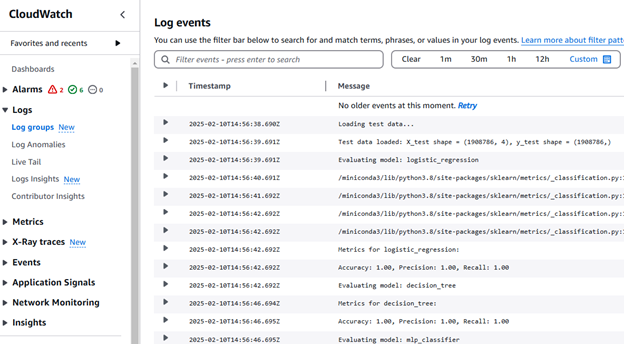
Pipeline-Ausführungsprotokolle in CloudWatch:
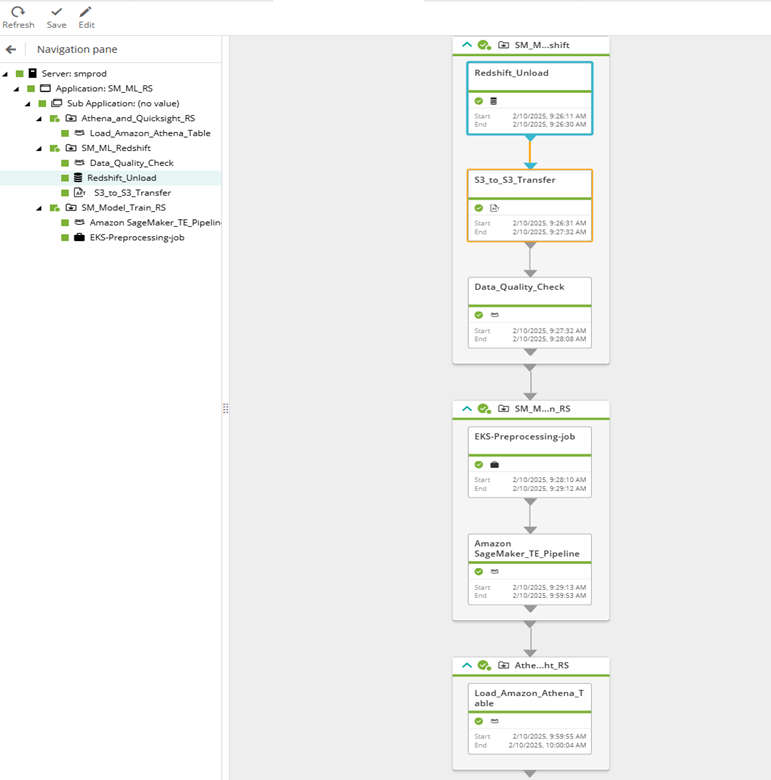
Workflow-Ausführung in Control-M
Die Rolle von Amazon SageMaker:
Um den Datensatz zu analysieren und Betrugsmuster zu erkennen, werden wir die Daten durch drei ML-Modelle laufen lassen, die in Amazon SageMaker verfügbar sind: logistische Regression, Entscheidungsbaumklassifizor und Multi-Layer-Perceptron (MLP). Jedes dieser Modelle bietet einzigartige Stärken, sodass wir ihre Leistung bewerten und den besten Ansatz zur Betrugserkennung wählen können.
- Logistische Regression: Logistische Regression ist ein lineares Modell, das die Wahrscheinlichkeit eines Ereignisses (z. B. Betrug) anhand von Eingabemerkmalen vorhersagt. Es ist einfach, interpretierbar und effektiv für binäre Klassifikationsaufgaben.
- Entscheidungsbaum-Klassifikator: Ein Entscheidungsbaum ist ein regelbasiertes Modell, das den Datensatz basierend auf Merkmalswerten in Zweige aufteilt. Jeder Ast stellt eine Entscheidungsregel dar, was das Modell leicht interpretierbar und gut geeignet macht, Muster in strukturierten Daten zu erkennen.
- Mehrschichtiges Perzeptron: Ein MLP ist eine Art neuronales Netzwerk, das darauf ausgelegt ist, komplexe, nichtlineare Beziehungen in den Daten zu erfassen. Es besteht aus mehreren Schichten von Neuronen und eignet sich ideal, um subtile Muster zu erkennen, die in einfacheren Modellen möglicherweise nicht offensichtlich sind.
Indem wir den Datensatz durch diese Modelle laufen lassen, wollen wir deren Leistung vergleichen und bestimmen, welches am effektivsten ist, um betrügerische Aktivitäten im Datensatz zu erkennen. Kennzahlen wie Genauigkeit, Präzision und Abruf werden unsere Bewertung leiten.
Trainmodels.py:
Dieses Skript verarbeitet Daten, um ML-Modelle für die Betrugserkennung zu trainieren. Es beginnt mit der Validierung und dem Laden des Eingabedatensatzes, stellt die Datenintegrität sicher, indem fehlende oder ungültige Werte behandelt werden und die Zielspalte isFraud überprüft wird. Die Daten werden dann in Trainings- und Testsätze aufgeteilt, die für die zukünftige Nutzung gespeichert werden. Die logistische Regression, der Entscheidungsbaumklassifizor und MLP werden auf dem Datensatz trainiert, wobei die trainierten Modelle als .pkl-Dateien für die Bereitstellung oder weitere Auswertung gespeichert werden. Die Pipeline gewährleistet eine robuste Ausführung mit umfassender Fehlerbehandlung und Modularität, was sie zu einer effizienten Lösung zur Erkennung betrügerischer Transaktionen macht.
Evaluatemodels.py:
Dieses Skript bewertet ML-Modelle zur Betrugserkennung mithilfe eines Testdatensatzes. Es lädt Testdaten und die drei vortrainierten Modelle, um deren Leistung zu bewerten. Für jedes Modell berechnet es Kennzahlen wie Genauigkeit, Präzision, Abruf, Klassifikationsbericht und Verwirrungsmatrix. Die Ergebnisse werden in einer JSON-Datei zur weiteren Analyse gespeichert. Das Skript stellt Modularität sicher, indem es über verfügbare Modelle iteriert und fehlende Dateien oder Fehler robust behandelt, was es zu einer umfassenden Bewertungspipeline für die Modellleistung macht.
Ergebnisse und Ergebnisse
Modellbewertungsergebnisse in Amazon QuickSight.
Modellbewertungsergebnisse in Amazon QuickSight
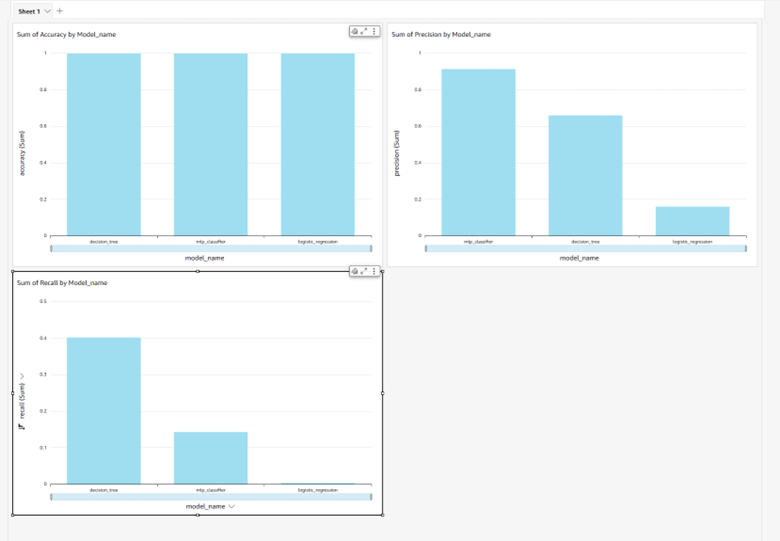
Das Entscheidungsbaum-Klassifikatormodell zeigt die ausgewogenste Leistung hinsichtlich Präzision und Abruf, gefolgt vom MLP. Logistische Regression schneidet trotz ihrer hohen Genauigkeit schlecht bei der korrekten Identifizierung positiver Fälle ab.
Der Aufbau einer automatisierten, skalierbaren und effizienten ML-Pipeline ist unerlässlich, um Betrug in der sich schnell wandelnden Finanzlandschaft von heute zu bekämpfen. Durch die Nutzung von AWS-Diensten wie Amazon SageMaker, Redshift, EKS und Athena in Kombination mit Control-M für die Orchestrierung sorgt diese Betrugserkennungslösung für eine nahtlose Datenverarbeitung, Echtzeit-Modelltraining und kontinuierliche Überwachung.
Eine Schlüsselsäule dieses Workflows ist Amazon SageMaker, das automatisiertes Modelltraining, Hyperparameter-Optimierung und skalierbare Inferenz ermöglicht. Es vereinfacht die Einführung von ML-Modellen und ermöglicht es Organisationen, mehrere Modelle – logistische Regression, Entscheidungsbaum-Klassifikator und MLP – zu trainieren und zu evaluieren, um die effektivste Betrugserkennungsstrategie zu bestimmen. Die integrierte Automatisierung für Training, Bewertung und Modellüberwachung stellt sicher, dass Betrugserkennungsmodelle aktuell, adaptiv und für reale Transaktionen optimiert bleiben.
Die Bedeutung von Automatisierung und Orchestrierung kann nicht hoch genug eingeschätzt werden – ohne sie wäre die Pflege einer produktionstauglichen ML-Pipeline zur Betrugserkennung umständlich, ineffizient und anfällig für Verzögerungen. Control-M ermöglicht End-to-End-Automatisierung und sorgt für eine reibungslose Ausführung komplexer Workflows – von der Datenerfassung über das Modelltraining in Amazon SageMaker bis hin zur Bewertung in Athena. Dies reduziert manuelle Eingriffe, optimiert die Ressourcenverteilung und verbessert die Effizienz der Betrugserkennung insgesamt.
Darüber hinaus stehen Modelltraining und -evaluation im Mittelpunkt des Erfolgs bei der Betrugserkennung. Durch kontinuierliches Training mit aktuellen Transaktionsdaten in Amazon SageMaker, Anpassung an sich entwickelnde Betrugsmuster und die rigorose Bewertung der Leistung anhand wichtiger Kennzahlen können Organisationen eine hohe Betrugserkennungsgenauigkeit aufrechterhalten und gleichzeitig Fehlalarme minimieren.
Während Betrüger weiterhin neue Angriffsstrategien entwickeln, müssen Finanzinstitute und Zahlungsabwickler mit adaptiven, KI-gesteuerten Betrugserkennungssystemen immer einen Schritt voraus sein. Durch die Implementierung einer skalierbaren und automatisierten ML-Pipeline mit Amazon SageMaker können Unternehmen nicht nur die Sicherheit verbessern und finanzielle Verluste reduzieren, sondern auch das Vertrauen der Kunden und die Transaktionsgenehmigungsraten verbessern.
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.