




Auf einen Blick: Apache Yarn ist ein Ressourcenmanager für Hadoop, der das Ressourcenmanagement von der Jobplanung trennt und so die Effizienz in verteilten Anwendungen erhöht. Es verwaltet Ressourcen wie CPU und Speicher über Scheduler- und ApplicationsManager-Daemons.
- Yarn erleichtert die Ressourcenverteilung über verteilte Architekturen.
- Es ist kompatibel mit Anwendungen wie Apache Spark.
Apache Yarn 101
Hier beschreiben wir Apache Yarn, ein Ressourcenmanager, der in Hadoop integriert ist. Aber es ist auch ein eigenständiges Programmierframework, das andere Anwendungen nutzen können, um diese Anwendungen über eine verteilte Architektur hinweg auszuführen.
Wir veranschaulichen Yarn, indem wir einen Hadoop-Cluster einrichten, denn Yarn allein ist nicht viel zu sehen. Es ist nichts, womit man über die Kommandozeile arbeitet, außer unter besonderen Umständen. Aber es über einen verteilten Cluster hinweg zum Laufen zu bringen, ist eine Übung, die veranschaulicht, was es bewirkt. Wenn man Hadoop auf einer einzigen Maschine einrichtet, nutzt man Yarn nicht so, wie es eigentlich gedacht ist. Das liegt daran, dass Yarn hilft, Dienste zu kolokieren, anstatt sie zu partitionieren. Das bedeutet, dass es die Anzahl der Server reduziert, die eine Organisation benötigt, indem jeder vollständig genutzt wird, anstatt nur einen Server oder mehrere Server für eine bestimmte Aufgabe zu reservieren.
Apache Yarn (Yet Another Resource Negotiator) ist das Ergebnis der Neuschreibung von Hadoop durch Yahoo, um das Ressourcenmanagement von der Jobplanung zu trennen. Das verbessert nicht nur Hadoop, sondern bedeutet auch, dass Yarn eine eigenständige Komponente ist, die man mit anderer Software wie Apache Spark verwenden kann, oder man kann seine eigene Anwendung mit Yarn schreiben, wodurch die Anwendung über eine verteilte Architektur läuft.
Yarn macht im Grunde dasselbe wie Mesos. Es führt den Überblick über verfügbare Ressourcen (Speicher, CPU, Speicher) im gesamten Cluster (also die Maschinen, auf denen Hadoop läuft). Dann fragt jede Anwendung (z. B. Hadoop) den Ressourcenmanager, welche Ressourcen verfügbar sind, und verteilt diese entsprechend. Dafür werden zwei Daemons ausgeführt: Scheduler und ApplicationsManager.
Yarn verwendet Linux-cgroups, um Aufgaben zu steuern und sie innerhalb ihrer Zuteilungsressourcen zu halten. Linux-cgroups ähneln den Docker- und Mesos-Containern. Das Ziel ist es, die Aufgabe mit ihrer zugewiesenen Speicher-, CPU-, Netzwerk- und Speichernutzung zu behalten, wobei dies bei Hadoop 2.7 auf die CPU-Begrenzung beschränkt ist.
Yarn ist ein Framework, also eine API. In der untenstehenden Grafik sehen wir, wie der Node Manager den Resource Manager anfragt, um die MapReduce-Aufgaben auszuführen und dann zu überwachen.
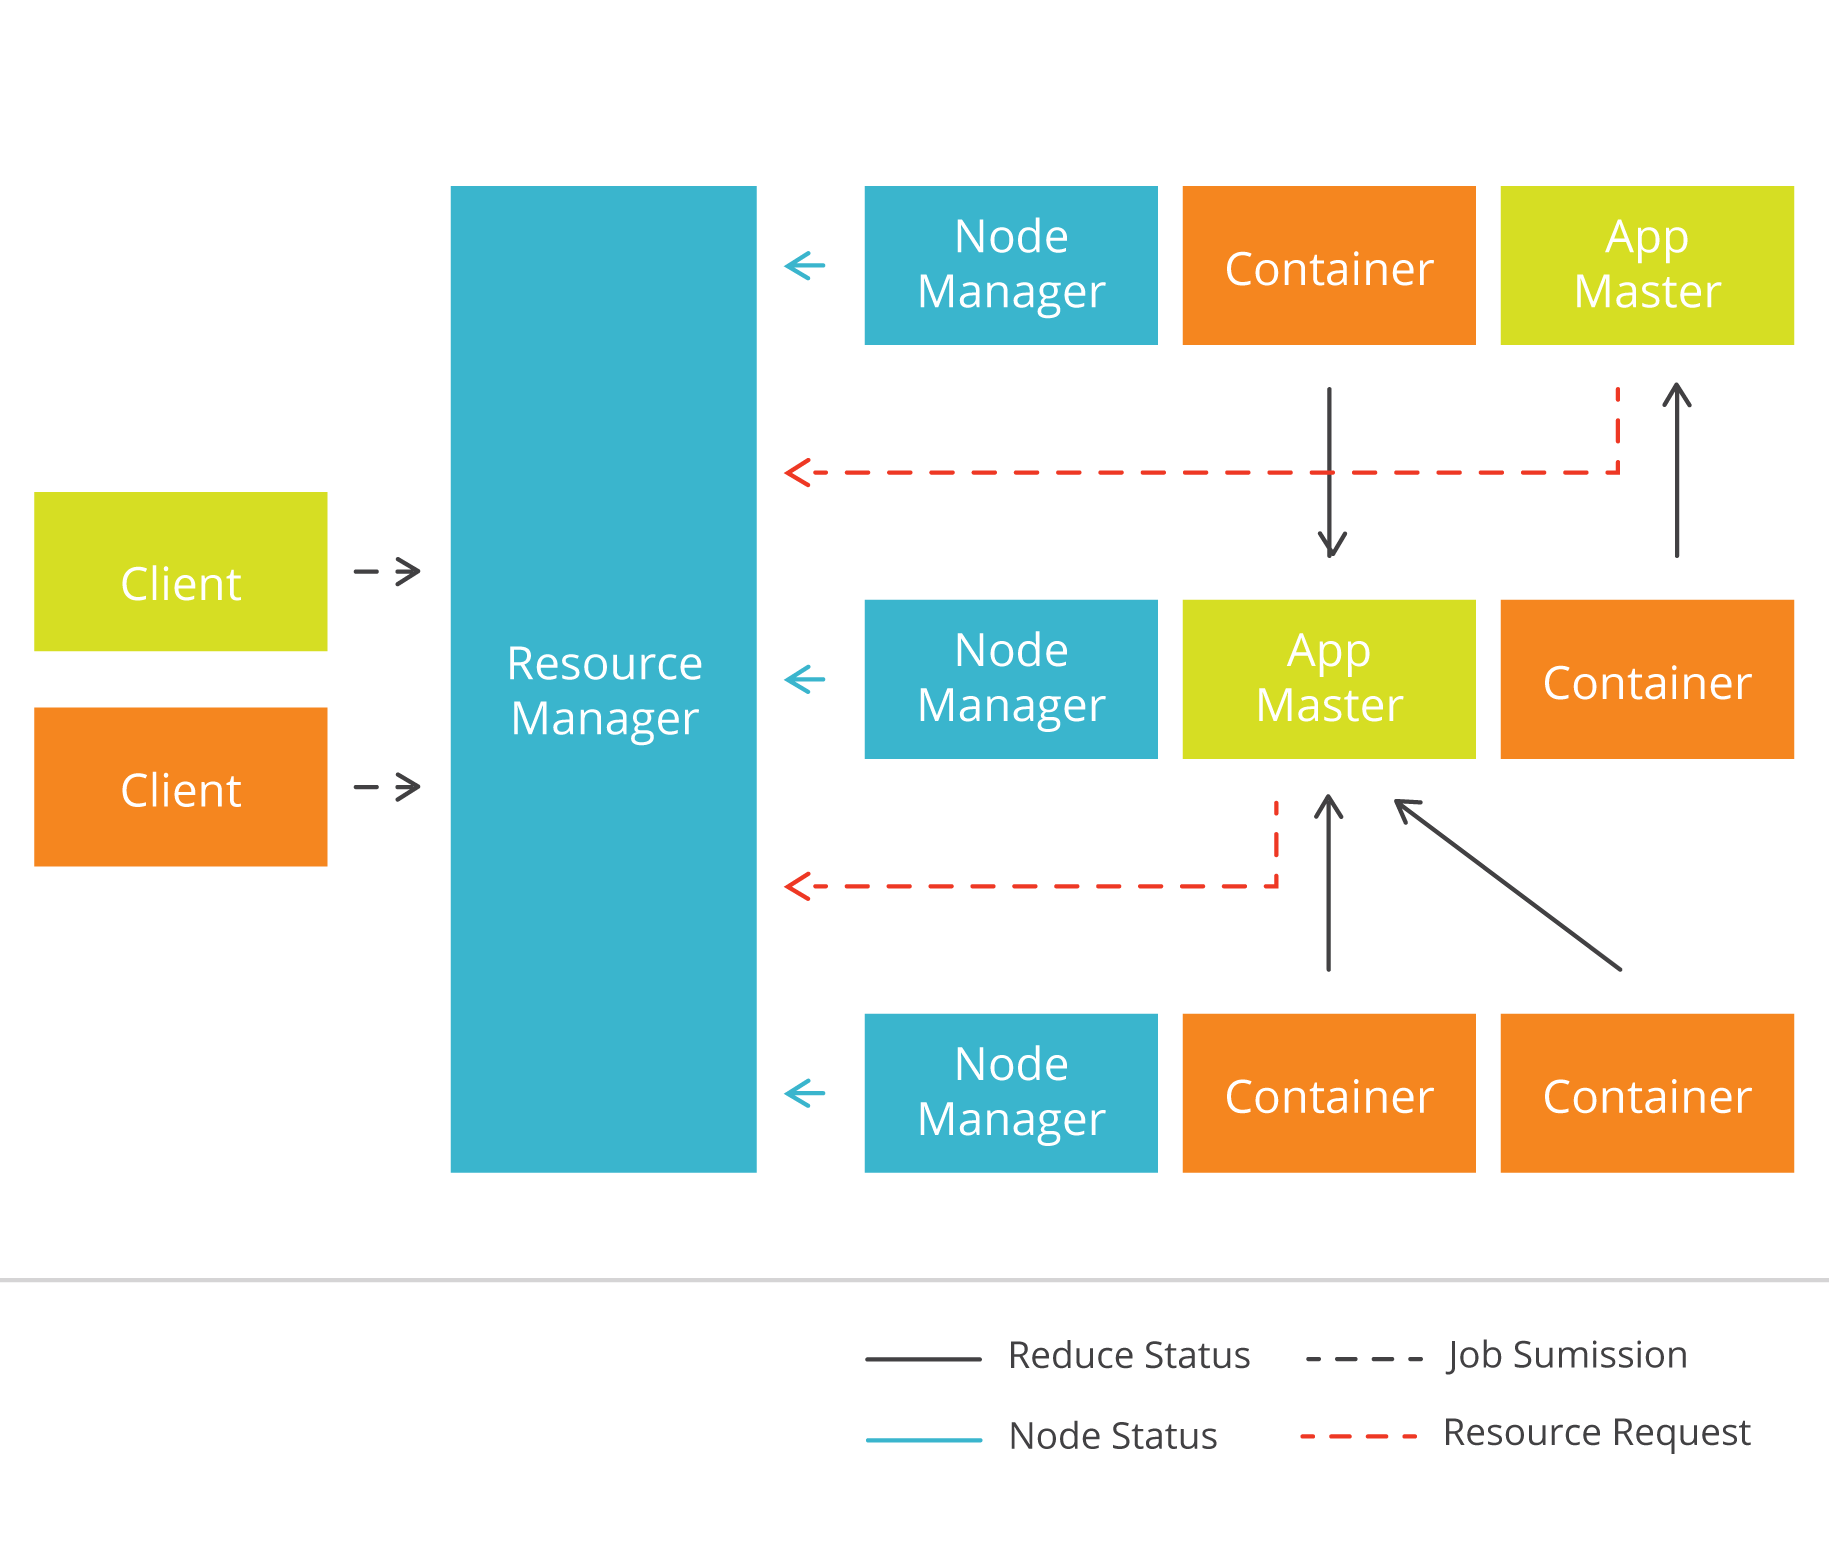
Um Hadoop zu überprüfen: Es handelt sich um ein verteiltes Dateisystem (HDFS), was bedeutet, dass man Dateien dorthin über eine verteilte Architektur kopieren kann. Aber es führt auch MapReduce-Jobs für Analytics aus. Das bedeutet, es nimmt eine Eingabedatei und mappt sie (d. h. führt eine Operation über jedes Datenelement im Set aus) und reduziert dann, wodurch all das zu einem einzigen Wert oder (Schlüssel->Wert-)Paare nach Schlüssel oder Tupeln (a,b,c) zusammengefasst werden. Es braucht also etwas wie Yarn, um das alles zu koordinieren.

Yarn-site.xml
In Hadoop befindet sich die Yarn-Konfigurationsdatei in
$HADOOP_HOME/etc/hadoop/yarn-site.xml.
Ebenso die Hadoop-Konfigurationsdateien.
Die Standard-Yarn-Konfiguration hat nur diese eine Eigenschaft, die für einen einfachen Test ausreicht.
    yarn.nodemanager.aux-services
    mapreduce_shuffle
Was du hier eingibst, überschreibt die Garn-Standardwerte.
Verwendung von Garn in einem Hadoop-Cluster
Wenn du Apache Yarn und Hadoop studierst, solltest du einen Hadoop-Cluster einrichten. Die meisten Hadoop-Studenten richten Hadoop auf einer Maschine ein und hören dort auf. Aber dann sehen sie nicht, wie Hadoop in einem Cluster läuft und wie man damit umgeht. Hinter den Kulissen koordiniert Yarn die MapReduce-Operationen, aber es gibt keine sichtbaren Hinweise darauf, es sei denn, du gräbst in den Logs. Wahrscheinlich wirst du eher in den Hadoop-Logs graben, da du core-site.xml und hdfs-site.xml die komplizierten Teile konfigurieren, und die Logs sind der Ort, an dem du nach Konfigurationsfehlern suchst und sie korrigierst. Was Yarn angeht, sind überhaupt keine Konfigurationsänderungen nötig.
Die Schritte zur Konfiguration von Hadoop so, dass es in einem Cluster läuft, sind:
- Starten Sie mindestens zwei virtuelle Maschinen. Drei wären besser.
- Erstellen Sie den Hadoop-Benutzer und führen Sie die folgenden Hadoop-Installationsschritte durch und führen Sie die Hadoop-Befehle als dieser Benutzer aus.
- Trage die Hostnamen aller drei Geräte und deren IPs in /etc/hosts ein
- Erstelle einen Ordner auf dem Master, um Hadoop-Daten zu speichern. Der hier angegebene Name muss Schritt 7 entsprechen.
- Installiere Hadoop auf dem Rechner, den du als Master kennst.
- Installiere Java auf allen drei VMs.
- Schau dir Hadoops Anweisungen zur Konfiguration von core-site.xml und hdfs.xml an. Die Anweisungen variieren leicht je nach Hadoop-Version.
- Bearbeiten Sie $HADOOP_HOME/etc/hadoop/slaves und fügen Sie die Wirtsnamen der Sklaven hinzu.
- Füge hadoop-env.sh JAVA_HOME hinzu.
- Installieren Sie Hadoop nicht auf den Slaves. Kopieren Sie stattdessen die gesamte Hadoop-Installation (also das Verzeichnis $HADOOP_HOME) auf die Slaves.
- Setze die .bashrc-Konfigurationsdatei oder den Hadoop-Benutzer wie unten gezeigt.
- Führe start_dfs.sh aus, um Hadoop und start_yarn.sh zu starten. Du musst Hadoop nicht neu starten, da du Installationsprobleme mit Hadoop und das neu anknüpfst. (Es wird wahrscheinlich ein paar Mal dauern, bis es richtig ist.)
- Führe JPS auf den Slaves aus und stelle sicher, dass der DataNode-Prozess läuft.
- Führe JPS auf dem Master aus und stelle sicher, dass der nameNode-Prozess läuft.
- Stellen Sie sicher, dass Sie diese URL im Master-http://localhost:50070/dfshealth.html#tab-overview
- Formatiere das Hadoop-Dateisystem mit: hadoop namenode -format.
- Installiere Apache Pig und stelle sicher, dass du das unten gezeigte Beispiel ausführen kannst.
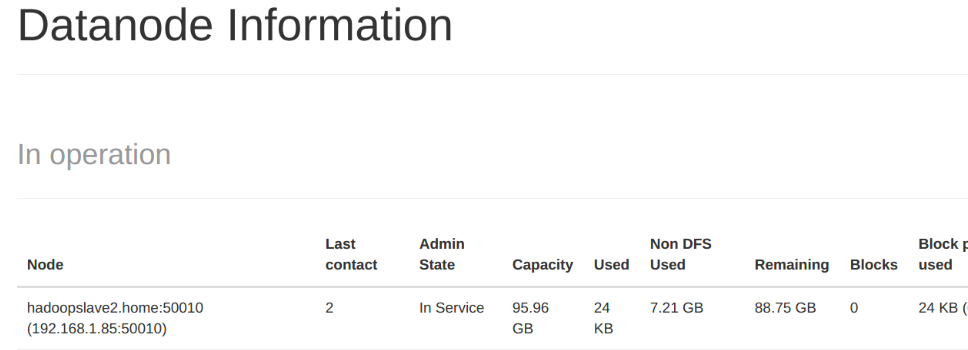
Wenn alles funktioniert, sollte Schritt 15 diese Webseite anzeigen:
Garn-Befehlszeile
Du kannst Yarn über die Kommandozeile ausführen, um Informationen zu bekommen. Aber du brauchst es eigentlich nicht.
Die Datei $YARN_HOME/etc/hadoop/yarn-env.sh ist, in der man die Garnoptionen für die Garn-Kommandozeile überschreibt.
Füge den Klassenpfad deiner Umgebung hinzu, damit du Yarn über die Kommandozeile verwenden kannst.
export CLASSPATH=`yarn classpath`:$CLASSPATH
Der Befehl Yarn classpath liefert alle jar-Dateien zurück, die zum Ausführen von Yarn benötigt werden
.bashrc
So sollte .bashrc aussehen. Ändern Sie Ihre Java- und Hadoop-Verzeichnisse so, dass sie zu den verwendeten Versionen passen:
    export JAVA_HOME=/usr/local/jdk-8u121/jdk1.8.0_121
export PATH=$PATH:$JAVA_HOME/bin
export HADOOP_HOME=/usr/local/hadoop/hadoop-2.7.3/
export HADOOP_MAPRED_HOME=$HADOOP_HOME
export HADOOP_COMMON_HOME=$HADOOP_HOME
export HADOOP_HDFS_HOME=$HADOOP_HOME
export YARN_HOME=$HADOOP_HOME
export HADOOP_COMMON_LIB_NATIVE_DIR=$HADOOP_HOME/lib/native
export PATH=$PATH:$HADOOP_HOME/sbin:$HADOOP_HOME/bin
export HADOOP_CONF_DIR=$HADOOP_HOME/etc/hadoop
export HADOOP_CLASSPATH=$HADOOP_HOME/etc/hadoop
Führe das Beispiel Apache Pig mit Yarn aus
Hier führen wir einen Hadoop-Job über den gesamten Cluster mit Apache Pig aus. Pig ist viel einfacher zu bedienen als langes Java-Schreiben zu verwenden. Das ist es, was Netflix macht.
Lade Apache Pig auf dem Master herunter und installiere es. Es ist eine einfache Installation, da du es einfach herunterlädst, entpackst und die Umgebung benutzt. Führe diese Befehle als Hadoop-Nutzer aus.
Erstelle diese einfache Textdatei data.csv. Diese zeigt einige Personen und ihr Alter an. Wir erstellen ein Verzeichnis und kopieren es nach Hadoop:
    walker,23
steen,45
antonella,35
fernando,24
Erstellen Sie das Hadoop-Verzeichnis:
hadoop fs -mkdir /data
Kopieren Sie die Datei data.csv dorthin:
hadoop fs -put /home/walker/Downloads/data.csv /data/
Führe nun Pig im mapReduce-Modus aus, also mit dem verteilten Cluster:
pig -x mapreduce
Es öffnet die Grunt-Konsole:
Dann gib diese beiden Befehle in die Grunt-Hülle ein:
Es sollte anzeigen:
    ages = LOAD '/data/data.csv' USING PigStorage(',') as (NAME:chararray,age:int);
dump ages
Es sollte anzeigen:
    (walker,23)
(steen,45)
 (antonella,35)
 (fernando,24)
Verwendung von Garn mit anderen Anwendungen
Du kannst Yarn mit jeder beliebigen Anwendung verwenden, die du schreibst, um ein Multithreaded verteiltes Programm zu erstellen. Alles, was du tun musst, ist, das YarnClient-Objekt in deinem Programm zu verwenden. Dann implementiere du ApplicationMaster. Du gibst Yarn an, welche JAR-Dateien und andere Dateien die App benötigt und welchen Befehl ausgeführt werden soll. Dann läuft deine Anwendung auf einem Container.
Das ist ziemlich komplex. Man könnte Apache Twill verwenden, dessen Ziel es ist, diese Komplexität zu verringern. Zum Zeitpunkt der Erstellung dieses Dokuments funktionierte Apache Will nicht.
Verwendung von Apache Spark mit Garn
Du kannst Apache Spark auch mit Garn ausführen. Du brauchst eine Verteilung von Spark, die mit Garnunterstützung gebaut ist. Wenn du es zum Laufen bringst, solltest du die Scala-Shell mit Folgendem öffnen können:
spark-shell --master yarn
Hadoop-Leitfaden
- Hadoop-Tutorial für Anfänger: Hadoop-Basics
- Eine Einführung in die Hadoop-Verwaltung
- Einführung in die Hadoop-Sicherheit
- Einführung in den Apache Flume
- Eine Einführung in Hive
- Eine Einführung in HDFS
- Einführung in Hbase
- Hadoop-Beispiele: 5 reale Anwendungsfälle
- Hadoop-Karrieren: Einstellung
- Hadoop-Interviewfragen
- Eine Einführung in die Hadoop-Analyse
- Einführung in Apache Pig
- Eine Einführung in Apache-Garn
- Eine Einführung in die Hadoop-Architektur
- Vorteile und Vorteile von Hadoop
- Hadoop mit Apache Cassandra verwenden
- Hadoop vs Kubernetes: Werden K8s & Cloud Native Hadoop beenden?
- Hadoop-Zertifizierungen
- Hadoop-Cluster: Eine Einführung
- Hadoop-Ökosystem und Komponenten
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.