




Auf einen Blick: Hadoop-Cluster verbessern das Datenmanagement durch verteilte Verarbeitung über Knoten hinweg, mit einem Master-Node (NameNode) und mehreren Slave-Nodes (DataNodes). Apache Yarn verwaltet Ressourcen effektiv und ermöglicht lineare Skalierbarkeit. Cluster können leicht erweitert werden, und Apache Ambari vereinfacht die Verwaltungsaufgaben.
- Die Architektur von Hadoop unterstützt effiziente Datenoperationen und hohe Verfügbarkeit.
- Ambari stellt robuste Werkzeuge zur Überwachung und Orchestrierung von Clustern bereit.
Hadoop-Cluster 101
Wenn wir über Hadoop-Cluster sprechen, müssen wir zunächst zwei Begriffe definieren: Cluster und Knoten. Ein Cluster ist eine Sammlung von Knoten. Ein Knoten ist ein Prozess, der auf einer virtuellen oder physischen Maschine oder in einem Container läuft. Wir sagen Prozess, weil ein Code andere Programme außer Hadoop ausführen würde.
Wenn Hadoop nicht im Cluster-Modus läuft, sagt man, dass es im lokalen Modus läuft. Das wäre zum Beispiel geeignet, um Hadoop auf einem Rechner zu installieren, nur um es zu lernen. Wenn man Hadoop im lokalen Node ausführt, schreibt es Daten ins lokale Dateisystem statt in HDFS (Hadoop Distributed File System).
Hadoop ist ein Master-Slave-Modell, bei dem ein Master (wenn auch mit einem optionalen High Availability Hot-Standby), der die Rolle vieler Slaves koordiniert. Yarn ist der Ressourcenmanager, der koordiniert, welche Aufgabe wo ausgeführt wird, wobei verfügbare CPU, Speicher, Netzwerkbandbreite und Speicher berücksichtigt werden.
Man kann einen Hadoop-Cluster skalieren, was bedeutet, dass man mehr Knoten hinzufügen muss. Hadoop soll linear skalierbar sein. Das bedeutet, für jeden Knoten, den du hinzufügst, bekommst du einen entsprechenden Durchsatzschub. Allgemeiner: Wenn du n Knoten hast, gibt dir das Hinzufügen von einem Modus (1/n) zusätzliche Rechenleistung. Diese Art des verteilten Rechnens ist ein großer Wandel gegenüber der Zeit, in der ein einzelner Server verwendet wurde, als man mit Speicher und CPUs nur eine marginale Steigerung des gesamten Knotens erzeugt.

Datanode und Namenode
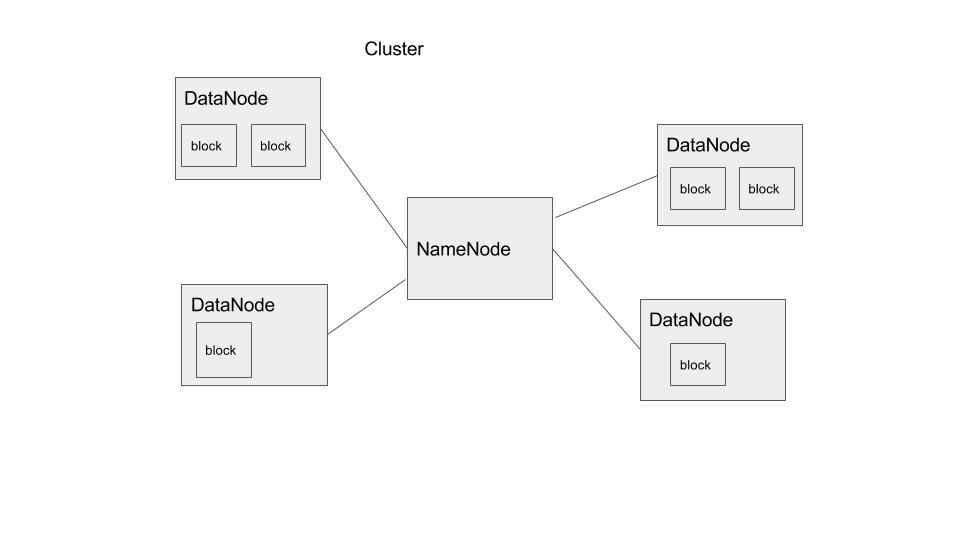
Der NameNode ist der Hadoop-Master. Er konsultiert mit DataNodes im Cluster, wenn Daten kopiert oder mapReduce-Operationen ausgeführt werden. Dieses Design ermöglicht es einem Benutzer, eine sehr große Datei auf einen Hadoop-Mountpunkt wie /data zu kopieren. Dateien, die auf /data kopiert werden, existieren als Blöcke auf verschiedenen DataNodes im Cluster. Die Sammlung von DataNodes nennt man HDFS.
Diese Grundidee wird unten dargestellt.
Garn
Apache Yarn ist ein Teil von Hadoop, der auch außerhalb von Hadoop als eigenständiger Ressourcenmanager verwendet werden kann. NodeManager erhält Anweisungen vom Yarn-Scheduler, um zu entscheiden, welcher Knoten welche Aufgabe ausführen soll. Yarn besteht aus zwei Teilen: ResourceManager und NodeManager. Der NodeManager berichtet an die CPU-, Speicher-, Festplatten- und Netzwerknutzung des ResourceManager, damit der ResourceManager entscheiden kann, wohin neue Aufgaben geführt werden. Der ResourceManager macht dies mit dem Scheduler und ApplicationsManager.
Hinzufügen von Knoten zum Cluster
Das Hinzufügen von Knoten zu einem Hadoop-Cluster ist so einfach, wie den Servernamen in die Datei $HADOOP_HOME/conf/slaves zu kopieren und dann den DataNode-Daemon auf dem neuen Knoten zu starten.
Kommunikation zwischen Knoten
Wenn du Hadoop installierst, aktivierst du ssh und erstellst SSH-Schlüssel für den Hadoop-Benutzer. So kann Hadoop zwischen den Knoten über RCP (Remote Procedure Call) kommunizieren, ohne ein Passwort eingeben zu müssen. Formal wird diese Abstraktion über das TCP-Protokoll Client Protocol und DataNode-Protokoll genannt. Die DataNodes senden einen Herzschlag an den NameNode, um ihm mitzuteilen, dass sie weiterhin funktionieren.
Hadoop-Knotenkonfiguration
Die Hadoop-Konfiguration ist relativ einfach, da man die Konfiguration auf dem Master durchführt und diese sowie die Hadoop-Software direkt auf die Datenknoten kopiert, ohne dass man auf jedem eine andere Konfiguration verwalten muss.
Die Haupt-Hadoop-Konfigurationsdateien sind core-site.xml und hdfs-site.xml. Hier legt man die Portnummer ein, auf die Hadoop-Dateien zugegriffen werden können, den Replikationsfaktor (also die Anzahl der Replikationen oder Kopien von Datenblöcken), den Standort des FSImage (der Änderungen an den Datendateien verfolgt) usw. Man kann dort auch die Authentifizierung konfigurieren, um Sicherheit in den Hadoop-Cluster zu bringen, der standardmäßig keine hat.
Clustermanagement
Hadoop hat eine Kommandozeilen-Schnittstelle sowie eine API. Aber es gibt kein echtes Werkzeug für Orchestrierung (also Verwaltung, einschließlich Überwachung) und zur Installation neuer Rechner.
Dafür gibt es einige Möglichkeiten. Eine davon ist Apache Ambari. Es wird von bestimmten Hadoop-Wolken wie Hortonworks genutzt und gefördert.
Hier ist eine Ansicht des Ambari-Dashboards von HortonWorks:
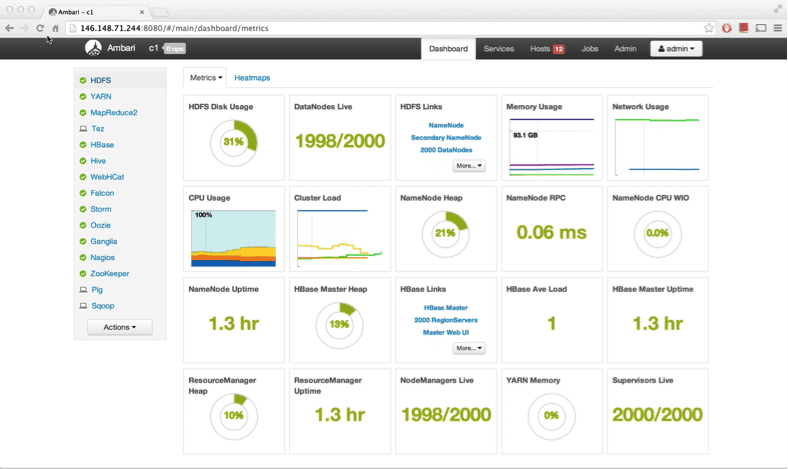
Wie Sie sehen, bietet es viele Metriken und Werkzeuge, die die einfachen, recht einfachen Hadoop- und Yarn-Weboberflächen nicht bieten.
Es stellt seine Dienste als REST-Web-APIs zur Verfügung. Andere Anbieter haben es also ihrer Betriebsplattform hinzugefügt, wie das Microsoft Systems Center und Teradata.
Mit Ambari kannst du statt stop-dfs.sh auf jeden Datenknoten zu tippen, die Funktion für rollende Neustarts nutzen, um jede Maschine neu zu starten, wenn du eine Änderung umsetzen möchtest. Wie du dir vorstellen kannst, wäre es zeitaufwendig, wenn du mehr als eine Handvoll Rechner hast, das über die Kommandozeile zu tun.
Ambari hilft auch, mehr als einen Cluster gleichzeitig zu verwalten. Und um jeden auszubauen, kannst du den Ambari Blueprint-Wizard nutzen, um NameNodes, DataNodes und Konfigurationsdetails anzugeben. Das ist auch nützlich, da du Entwicklungs- oder Testcluster erstellen und deren Aufbau automatisieren kannst. Du führst den Wizard nur einmal aus, dann speichert er ihn als API, damit du neue Cluster erstellen kannst.
Hadoop-Leitfaden
- Hadoop-Tutorial für Anfänger: Hadoop-Basics
- Eine Einführung in die Hadoop-Verwaltung
- Einführung in die Hadoop-Sicherheit
- Einführung in den Apache Flume
- Eine Einführung in Hive
- Eine Einführung in HDFS
- Einführung in Hbase
- Hadoop-Beispiele: 5 reale Anwendungsfälle
- Hadoop-Karrieren: Einstellung
- Hadoop-Interviewfragen
- Eine Einführung in die Hadoop-Analyse
- Einführung in Apache Pig
- Eine Einführung in Apache-Garn
- Eine Einführung in die Hadoop-Architektur
- Vorteile und Vorteile von Hadoop
- Hadoop mit Apache Cassandra verwenden
- Hadoop vs Kubernetes: Werden K8s & Cloud Native Hadoop beenden?
- Hadoop-Zertifizierungen
- Hadoop-Cluster: Eine Einführung
- Hadoop-Ökosystem und Komponenten
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.