




Auf einen Blick: Eine Einführung in HDFS erklärt seine Architektur und Dateiverwaltung innerhalb von Hadoop, hebt Datenreplikation zur Widerstandsfähigkeit sowie Einschränkungen wie die Unfähigkeit zur Aktualisierung von Dateien hervor. Außerdem wird die Eignung von HDFS für die Batchverarbeitung und das Wachstumspotenzial unbegrenzter Dateigrößen hervorgehoben.
- HDFS unterstützt unbegrenztes Dateigrößenwachstum durch Metadatenspeicherung in einem Namenode.
- Dateien können nur geschrieben oder gelöscht werden, was das Design für die Batch-Verarbeitung verstärkt.
HDFS-Namensknoten und Datenknoten
Hadoop besteht aus zwei Hauptteilen: einer verteilten Architektur zum Ausführen von MapReduce-Jobs, also Java- und anderen Programmen, die Daten von einem Format in ein anderes konvertieren, sowie ein verteiltes Dateisystem (HDFS) zur Speicherung von Daten in einer verteilten Architektur. Hier besprechen wir HDFS.
In einer regulären Datei auf einem normalen PC oder Server speichert der Computer Dateien in zusammenhängenden Festplattenspeicher, die als Blöcke bezeichnet werden. Ein zentraler Mechanismus verfolgt den Blick, welche Blöcke auf welchem Festplattenstandort gespeichert sind. Auf einem PC oder Server wird das FAT (File Allocation Table) oder NTFS (New Technology File System) genannt. Außerdem gibt es weitere Strukturen, die festhalten, welche Daten wo geschrieben werden.
Auf einem magnetischen Festplattenlaufwerk werden die Daten mit einem beweglichen Gerät, einem sogenannten Festplattencontroller, auf die Festplatte geschrieben. In HDFS werden Schreibvorgänge über das Netzwerk über Hadoop-Netzwerkprotokolle auf einzelne Server übertragen, die dann Hadoop-Datennotizoperationen zusammen mit FAT oder NTFS oder etwas Ähnlichem nutzen, um in die Datenblöcke des Host-Rechners zu schreiben. Dies ist meist lokal angeschlossener Speicher, um die Kosten zu senken, statt eines Speicherarrays wie ein Speicherrack. (Niedrige Betriebskosten sind einer der Verkaufsargumente von Hadoop.)
Hadoop beseitigt die physischen Beschränkungen fester Festplattengrößen, indem es Dateimetadaten (d. h. den Standort der Blöcke) in einem Name-Node-Prozess auf dem Masterserver und die Daten auf einer beliebigen unendlichen Anzahl von Datenknoten speichert.
Datanode-Prozesse, die auf jedem Knoten im Cluster laufen, verarbeiten, um Daten auf dort liegende Festplattenblöcke zu schreiben.
Im Gegensatz zu einem regulären Dateisystem kann das HDFS unbegrenzt wachsen, da Architektur und Administrator Knoten nach Belieben hinzufügen können. Diese Abstraktion einer einzelnen Datei über mehrere Computer hinweg ermöglicht es, dass Dateien unbegrenzt in ihrer Größe wachsen.
Aber es dient auch als praktische Bucket-Notation, bei der Nutzer Dateien konventionell speichern können, ohne sich Gedanken darüber machen zu müssen, in welchem Verzeichnis sie eingebunden sind, usw. Zum Beispiel können sie jede Art von Datei auf hdfs://(Servername):p ort kopieren und diese von jedem Computer im Netzwerk abrufen.
Viele andere Big-Data-Produkte wie Spark, Storm, Cassandra Hbase, Hive usw. nutzen zumindest einen Teil von HDFS für ihre Anwendungen.

HDFS schreibt nur Daten, aktualisiert nicht
In Hadoop kannst du nur Dateien schreiben und löschen. Du kannst sie nicht aktualisieren.
Das System ist darauf ausgelegt, widerstandsfähig und fehlersicher zu sein, denn wenn jeder Datenknoten seinen Speicher auf Festplattendatenblöcke schreibt, schreibt er diesen Speicher auch per Replikation an einen anderen Server. Die Anzahl der Replikate wird vom Benutzer festgelegt. Und Dataknoten können im Rack bewusst gemacht werden. Dies ist notwendig, weil Redundanz nicht funktioniert, wenn man Daten auf zwei Festplattenlaufwerke im selben Rack schreibt, die dieselbe Stromversorgung und Netzwerkverbindungen teilen.
Datenblöcke auf einem normalen PC sind etwa 4K oder 64K groß. Aber in Hadoop sind sie oft 64 MB.
Hadoop ist ein Batch-System, daher ist es nicht dafür ausgelegt, Daten schnell zu lesen. Stattdessen ist es dafür ausgelegt, große Datenmengen zu schreiben und diese mithilfe von Batch-MapReduce-Jobs abzurufen.
Im Folgenden zeigen wir ein Diagramm der Grundarchitektur.
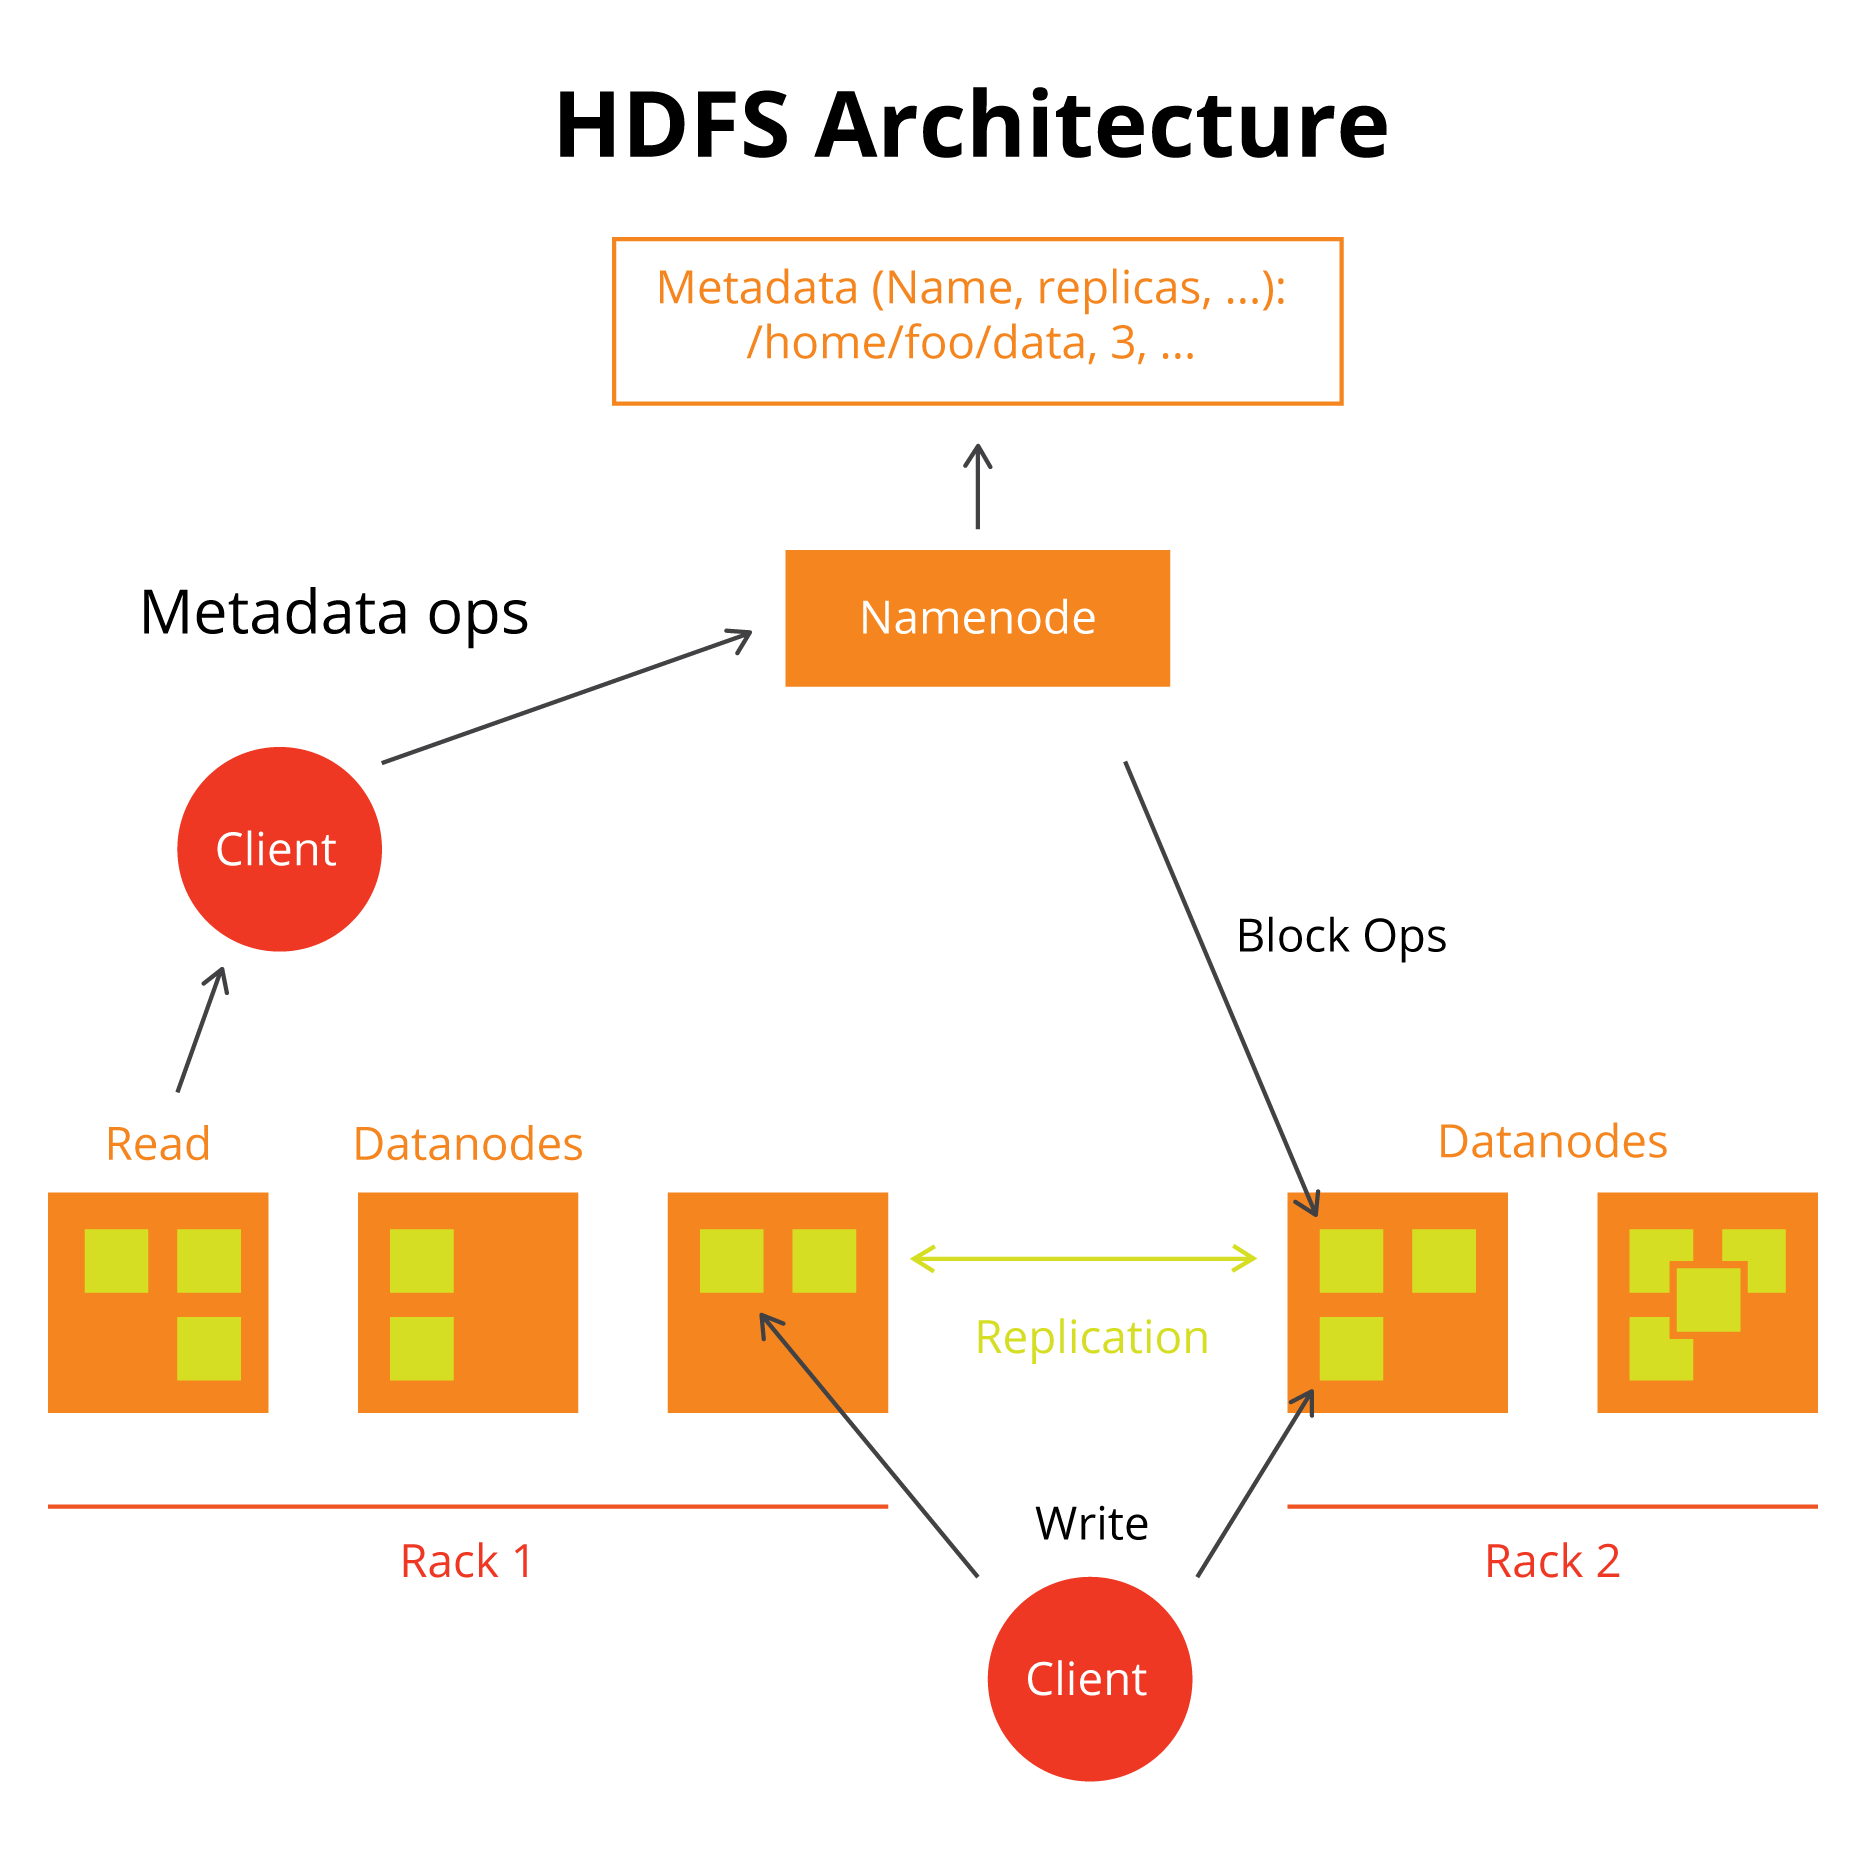
Hier sehen wir einen Mount-Punkt/Home/foo/Data. Dies wird Namespace genannt. Dieser Ordner existiert auf keiner Festplatte, er ist lediglich eine Abstraktion über den Cluster. Der Namespace existiert über alle Datanodes.
Der Namenode teilt den Datanodes an, wo sie Daten schreiben sollen. Die Datanodes berichten zurück, in welchen Block und auf welches Laufwerk sie Daten an den Namenode geschrieben haben, sodass ein zentrales Repository das wissen kann. Der Namenode dupliziert diese Informationen in einen sekundären Name-Node.
Die Datenknoten schreiben Daten im Blockformat in lokalen Speicher, genau wie bei einem normalen PC. Im Falle eines defekten Festplattenlaufwerks kann der Namenode die Daten auf einer anderen Datennotiz rekonstruieren. (In einem großen Rechenzentrum fallen Festplatten täglich aus.) Der Namenode verwendet das Editlog, um alle Schreibvorgänge zu verfolgen. Das Edit-Log wird auf den Namenode-Server auf dem regulären Festplattenspeicher geschrieben. Diese Datei wird FSImage genannt. Hadoop beschneidet den Editlog, da Transaktionen die FSImage-Metadatendatei zu den Datenknoten geschrieben werden.
HDFS CLI
Man arbeitet mit Hadoop-Dateien entweder von einem Client-Programm, das die API nutzt, wie das unten gezeigte Java-Programm, oder mit der Kommandozeile. Die Befehle sind fast identisch mit normalen Linux-Befehlen: ls, mkdir, chown usw. Sie sind also sehr einfach zu bedienen. Der einzige Unterschied ist, dass man "hadoop fs -(Befehl" schreibt. Zum Beispiel listet hadoop fs -ls Dateien in einem Verzeichnis (Namensraum) auf.
Die vollständige Liste der CLI-Befehle lautet:
appendToFile cat checksum chgrp chmod chown copyFromLocal copyToLocal count cp createSnapshot deleteSnapshot df du dus expunge find get getfacl getfattr getmerge help ls lsr mkdir moveFromLocal moveToLocal mv put renameSnapshot rm rmdir rmr setfacl setfattr setrep stat tail test text touchz truncate usage
Die Ausgabe des Befehls sieht genau wie ein normaler Linux-Befehl aus:
    hadoop fs -ls /data
-rw-r--r--   1 root supergroup    1081141 2017-03-31 15:37 /data/ssh.log
HDFS-Konfiguration
Die HDFS-Parameterliste ist sehr lang und wird am besten im Hadoop-Handbuch überprüft. Kurz gesagt, es gibt nur wenige Parameter, die man setzen muss, um Hadoop im lokalen oder Node-Modus zum Laufen zu bringen. Die gebräuchlichsten im Zusammenhang mit Speicher sind unten aufgeführt:
hdfs-site.xml
    dfs.namenode.name.dir
      file:///usr/local/hadoop


      dfs.datanode.name.dir
      file:///usr/local/hadoop
core-site.xml
    fs.defaultFS
      hdfs://hadoop-master:9000/


Turns on or off permissions checking.


      dfs.permissions
      false
Java
Hadoop ist in Java geschrieben. Apache Pig erstellt Java MapReduce-Programme basierend auf SQL-Befehlen, die in die Konsole eingegeben werden. Es ist also gut, Java zu kennen, wenn man mit HDFS arbeiten möchte.
Hier ist ein Beispielprogramm Hdfs.java, um einen String in eine Datei in HDFS zu kopieren.
Zuerst die Umwelt:
export HADOOP_CLASSPATH=$($HADOOP_HOME/bin/hadoop classpath)
Kompiliere das Programm folgendermaßen:
javac -classpath ${HADOOP_CLASSPATH} Hdfs.java
Dann führe es so aus:
java -cp .:$HADOOP_CLASSPATH Hdfs
Hier ist die Quelle Hdfs.java.
    import java.io.BufferedInputStream;
import java.io.BufferedOutputStream;
import java.io.File;
import java.io.FileInputStream;
import java.io.FileOutputStream;
import java.io.IOException;
import java.io.InputStream;
import java.io.OutputStream;

import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.fs.FSDataInputStream;
import org.apache.hadoop.fs.FSDataOutputStream;
import org.apache.hadoop.fs.FileSystem;
import org.apache.hadoop.fs.Path;

public class Hdfs {


public static void main(String[] args) throws IOException {

Configuration conf = new Configuration ();
FileSystem fileSystem = FileSystem.get(conf);

	Path path = new Path("/data/silly.txt");

  FSDataOutputStream out = fileSystem.create(path);


String helloWorld = "Hello Hadoop World.";

out.writeBytes(helloWorld);

out.close();
fileSystem.close();

}

}
Wenn wir dies zum ersten Mal ausführen, erhalten wir diesen Fehler:
Permission denied: user=walker, access=WRITE, inode="/data":root:supergroup:drwxr-xr-x
Ändere also die Ordnerberechtigung genauso wie mit dem Linux-Chagun-Befehl:
hadoop ds -chown walker /data
Dann versuche ich den Inhalt der Datei, um zu zeigen, dass es funktioniert hat:
    hadoop fs -cat /data/silly.txt

Hello Hadoop World.
Hadoop-Dateinamen
Hadoop-Dateien, die von Map und Reduce erstellt werden, werden als unterschiedliche Anzahl von Dateien in Ordnern gespeichert.
Das liegt daran, dass solche Jobs in parallele Prozesse aufgeteilt und im gesamten Cluster ausgeführt werden.
Wenn du also einen MapReduce-Job ausführst und den Ausgabeordner wie folgt einsetzt:
FileOutputFormat.setOutputPath(job, “/data.txt);
Die Ausgabe wird in Dateien namens "success" und "partn" im Ordner /data.txt/ aufgeteilt, wobei n von 1 bis zu den vielen Partitionen liegt, in die dieser Schritt unterteilt wurde.
Hadoop-Dateispeicher
Hadoop verwendet mehrere Dateispeicherformate, darunter Avro, Parquet, Sequence und Text.
Avro
Avro-Serialisierung für Hadoop schreibt Daten im JSON-Byte-Format, sodass sie von Programmen in jeder beliebigen Sprache konsumiert werden können. Avro ist in Hadoop integriert. (Serialisierung bedeutet, Daten in Speicher zu schreiben, wie zum Beispiel ein Feld, eine Websitzung oder Datei.) Mit Avro kann man komplexe Strukturen (Arrays, customClass) zusätzlich zu Primitiven (z. B. int, float, boolean) darstellen.
Parkett
Parquet ist ein Zeilen- und Spaltenspeicherformat, das von Cloudera und Twitter zu Hadoop hinzugefügt wurde. Es ähnelt Hbase, einem Speichermechanismus auf Hadoop, um Datenspalten nahe beieinander zu speichern, um einen schnellen Abruf in einem Zeilen-Spalten-Speicherdesign zu ermöglichen. HBase ist die Open-Source-Implementierung für Googles Big Table-Datenbank. Parquet ist darauf ausgelegt, komplexe Strukturen in großen Mengen zu serialisieren, wie die Klassen, die Sie in Java, Python und anderen Sprachen definieren, zusammen mit deren Mitgliedsfeldern und Funktionen. Parquet unterstützt außerdem APache Hive, Pig und Spark Storage.
Sequenzdateien
Ist eine JSON-Textdatei, aber in Binärform gespeichert (Key-Value= Format). Also wird (a=>b) als (01100001->01100010) gespeichert. Es gibt drei Arten von Sequenzdateien, wobei der Unterschied darin besteht, ob Schlüssel und Werte komprimiert sind oder nicht. Diese verwenden diese Codecs für die Kompression: BZip2Codec, DefaultCodec, GzipCodec. Ohne zu erklären, wie diese funktionieren, wird beobachtet, dass eine Folge von 6 Bits von 1 als etwas wie "6 1" geschrieben werden könnte, was weniger Platz einnimmt als 6 tatsächliche 1s.
Klartext (CSV und txt)
Es bedarf keiner Erklärung. In Java wird es als folgt bezeichnet:
job.setOutputFormatClass(TextOutputFormat.class);
Hadoop in der Wolke
Verschiedene Anbieter haben ihre eigene Hadoop-Abstraktion implementiert, zum Beispiel Windows Azure sowie Amazon EC2 und S3. S3 ist tatsächlich bereits ein URL-ähnliches Dateisystem wie Hadoop, das Verzeichnisnamen wie //server/directory/file durch URLs http:// ersetzt. Cloudera hat Hadoop zum Hauptgeschäft gemacht.
Hadoop-Leitfaden
- Hadoop-Tutorial für Anfänger: Hadoop-Basics
- Eine Einführung in die Hadoop-Verwaltung
- Einführung in die Hadoop-Sicherheit
- Einführung in den Apache Flume
- Eine Einführung in Hive
- Eine Einführung in HDFS
- Einführung in Hbase
- Hadoop-Beispiele: 5 reale Anwendungsfälle
- Hadoop-Karrieren: Einstellung
- Hadoop-Interviewfragen
- Eine Einführung in die Hadoop-Analyse
- Einführung in Apache Pig
- Eine Einführung in Apache-Garn
- Eine Einführung in die Hadoop-Architektur
- Vorteile und Vorteile von Hadoop
- Hadoop mit Apache Cassandra verwenden
- Hadoop vs Kubernetes: Werden K8s & Cloud Native Hadoop beenden?
- Hadoop-Zertifizierungen
- Hadoop-Cluster: Eine Einführung
- Hadoop-Ökosystem und Komponenten
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.