




Auf einen Blick: Maschinelle Lernarchitekturen sind für spezifische Anwendungen konzipiert, wie CNNs für Bildklassifikation und RNNs für Sequenzmodellierung. Diese Ressource behandelt verschiedene Architekturen, darunter GANs und Clustering-Algorithmen, und beschreibt deren Anwendungsfälle und Funktionalitäten.
- Verschiedene Architekturen erfüllen unterschiedliche Zwecke im maschinellen Lernen.
- Gängige Architekturen sind CNNs, RNNs und GANs.
- Die Anwendungen reichen von der Bildklassifikation bis zur Anomalieerkennung.
Verschiedene Machine-Learning-Architekturen werden für unterschiedliche Zwecke benötigt. Ein Auto ist ein Motorfahrzeug, das dich zur Arbeit und zu Roadtrips bringt, ein Traktor zieht einen Pflug, ein 18-Rad-Wagen transportiert viele Waren.
Jedes Machine-Learning-Modell wird für unterschiedliche Zwecke verwendet. Eines wird zur Klassifikation von Bildern verwendet, eines eignet sich gut zur Vorhersage des nächsten Elements in einer Sequenz und eines eignet sich gut, um Daten in Gruppen zu sortieren. Einige sind für mehrere Zwecke geeignet, andere nur für einen.
In diesem Artikel betrachten wir die gebräuchlichsten ML-Architekturen und deren Anwendungsfälle, darunter:
Konvolutionelle neuronale Netze (CNNs)
Häufig verwendet in:
- Bildklassifikation
- Objekterkennung
- Empfehlungssysteme
Die wesentliche Komponente des CNN ist seine Faltungsschicht – daher der Name. Die Faltungsschicht ist ein Filter zwischen Eingabe und Ausgabe. Sie erstellt eine Merkmalskarte der Eingaben, die die erkannten Merkmale zusammenfasst. Die Faltungsschicht kann ein Bild in wichtige Merkmale zerlegen und dann sein Label anhand dieser Merkmale vorhersagen.
Nach der Erstellung der Merkmalskarte sind die folgenden Schichten Pooling-Schichten. Pooling-Schichten vereinfachen die Berechnung, indem sie die Dimensionalität der Daten reduzieren. Dazu kombiniert sie die Ausgaben einer Schicht, bevor sie zur nächsten Schicht übergeht. Pooling kann lokal oder global stattfinden. Der Unterschied besteht darin, ob das Pooling in einem konvolutionalen Neuron oder über alle konvolutionalen Neuronen hinweg stattfindet.
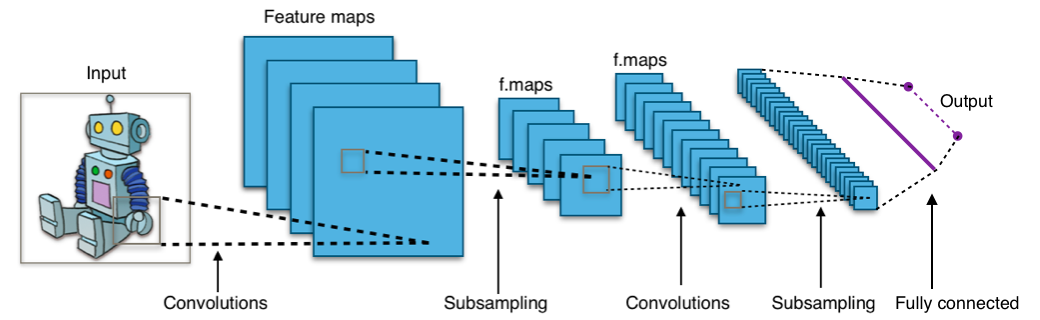
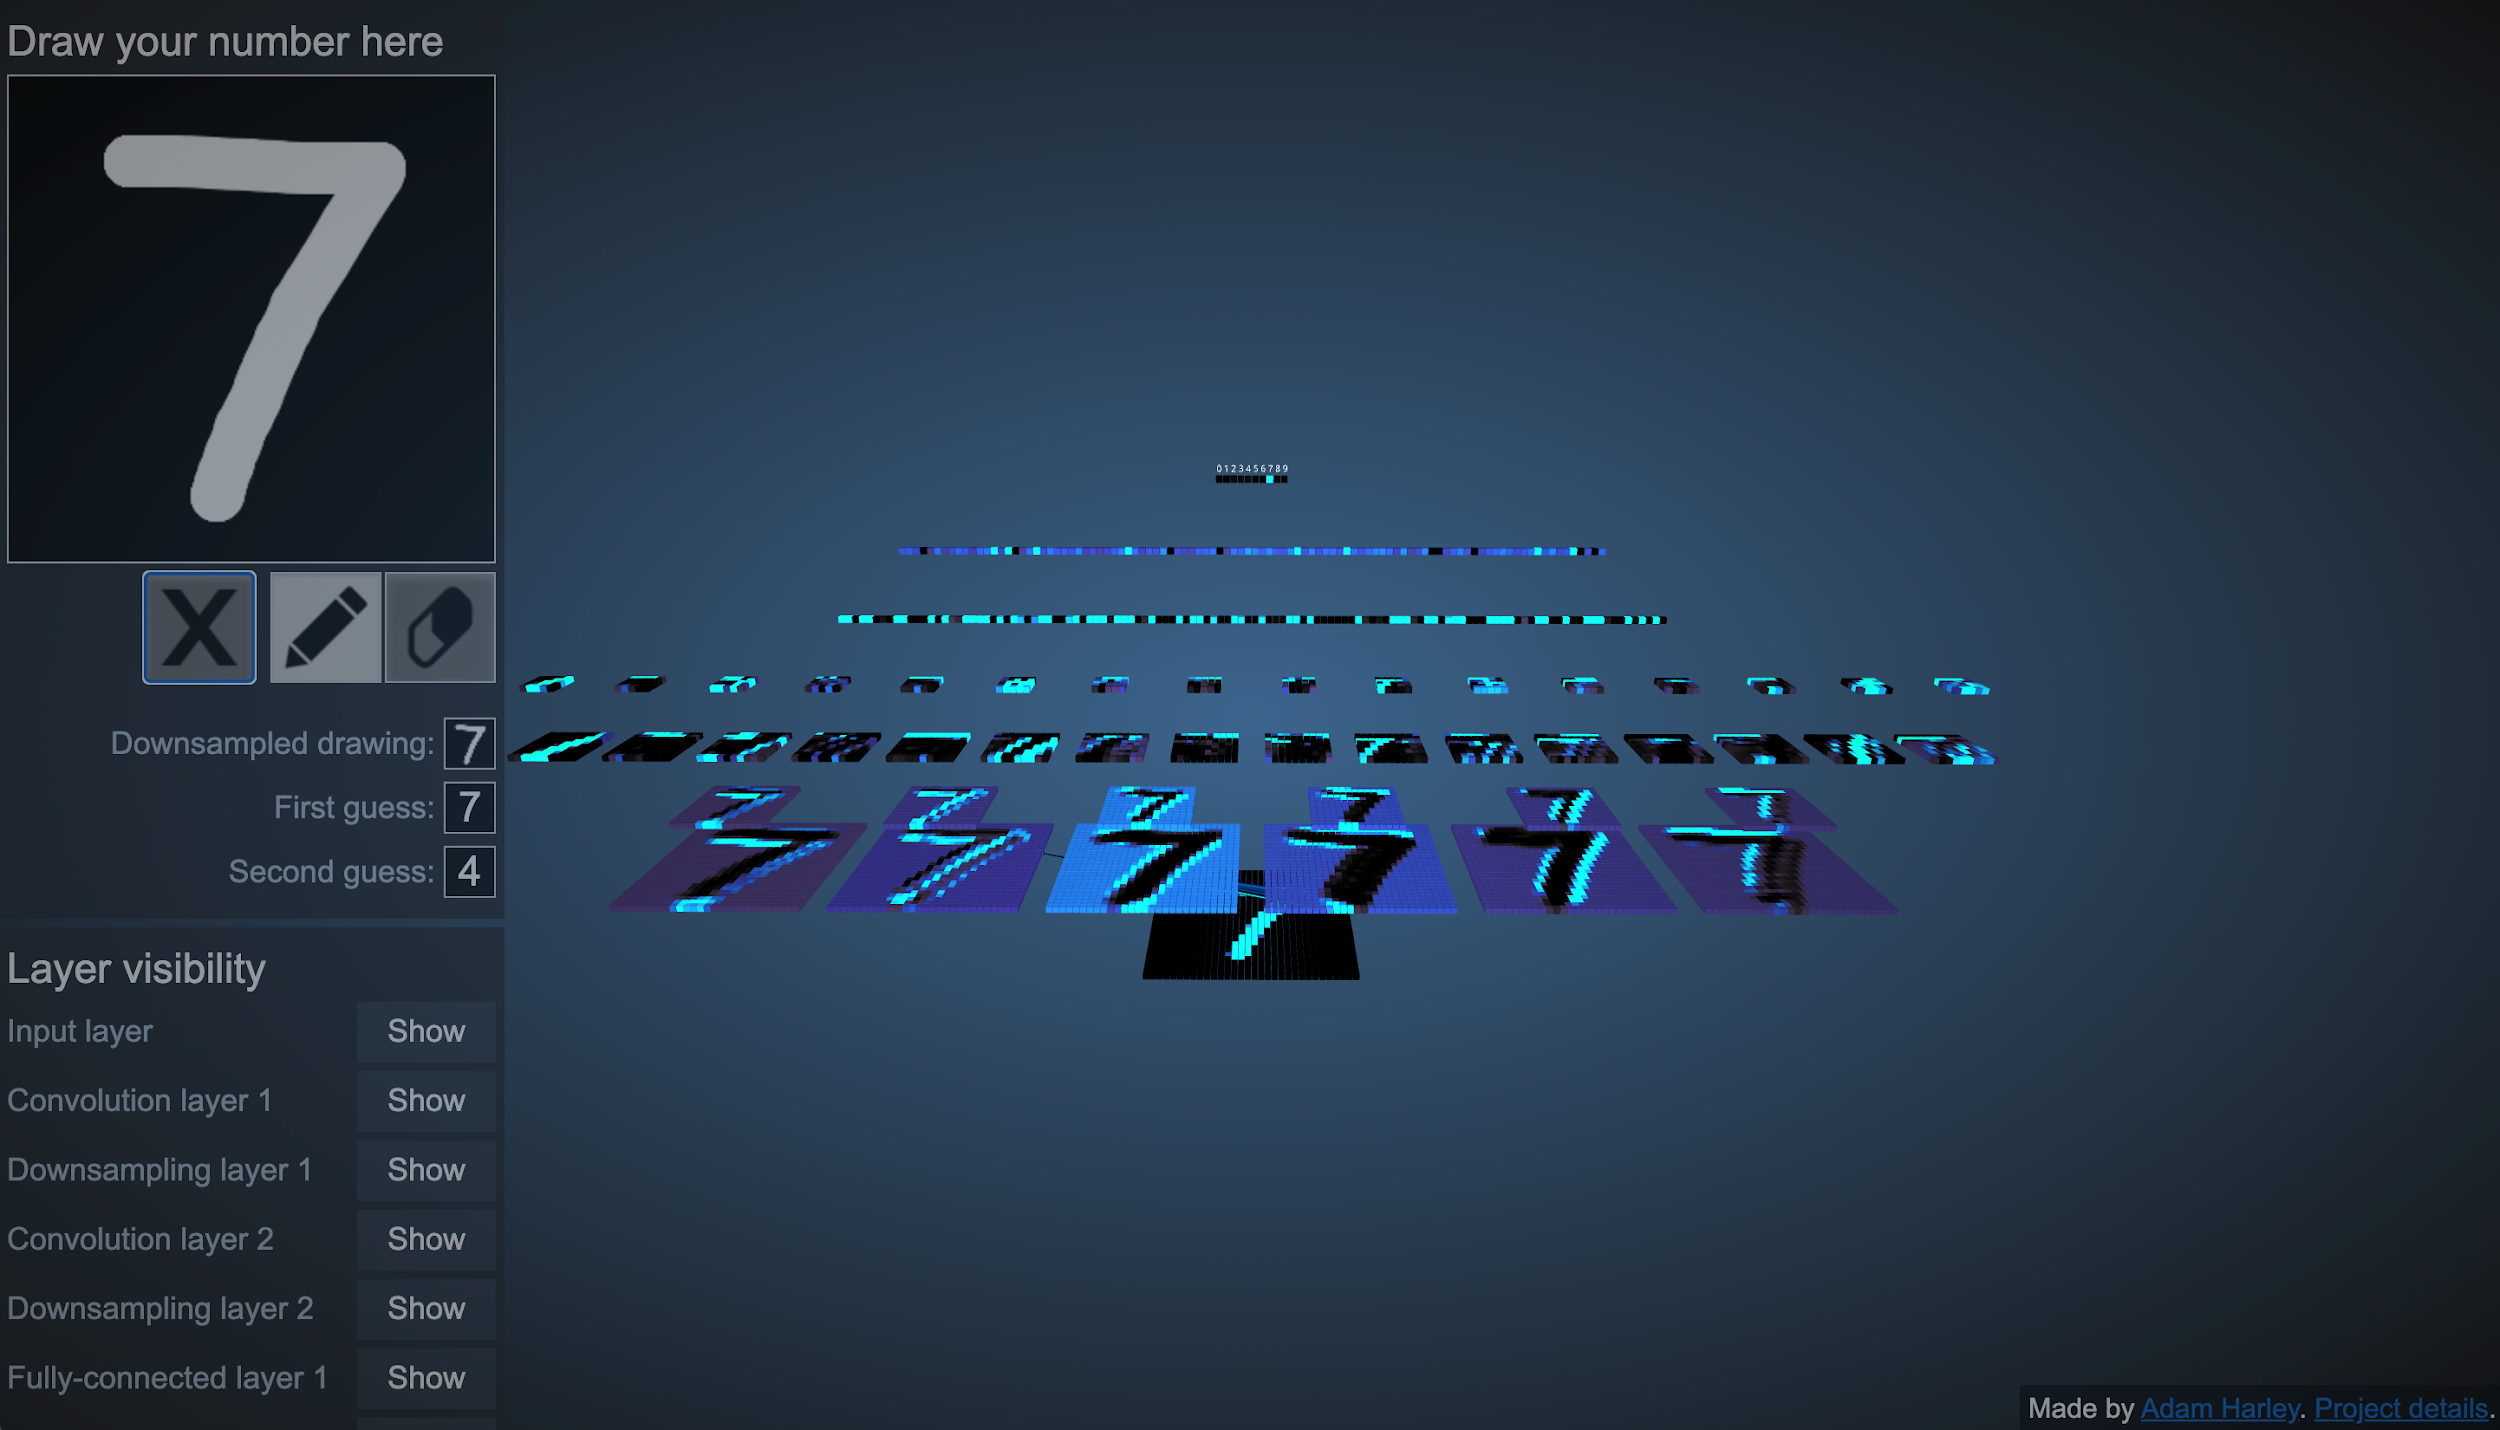
In dieser oben gezeigten interaktiven Visualisierung sieht man, wie die erste Ebene aus 6 Featuremaps der Eingabeschicht besteht (am unteren Rand des Stacks). Diese 6 Feature Maps werden dann heruntergescannt, wobei sie von 25x25 auf 14x14-große Bilder reduziert werden, während ihre Hauptform erhalten bleibt. Aus diesen neuen Bildern wird aus diesen neuen Bildern eine Feature-Ebene erstellt, bestehend aus 16 Featuremaps.

Schließlich führt der CNN nach der Betrachtung der wichtigsten Merkmale des gezeichneten Bildes die Eingaben durch zwei vollständig verbundene Schichten und sagt vorher, wie das Label aussehen soll.
Rekurrente/rekursive neuronale Netze (RNNs)
Verwendung für:
- Sequenzmodellierung
- Vorhersage des nächsten Wortes
- Laute in Wörter übersetzen
- Menschliche Sprachübersetzung
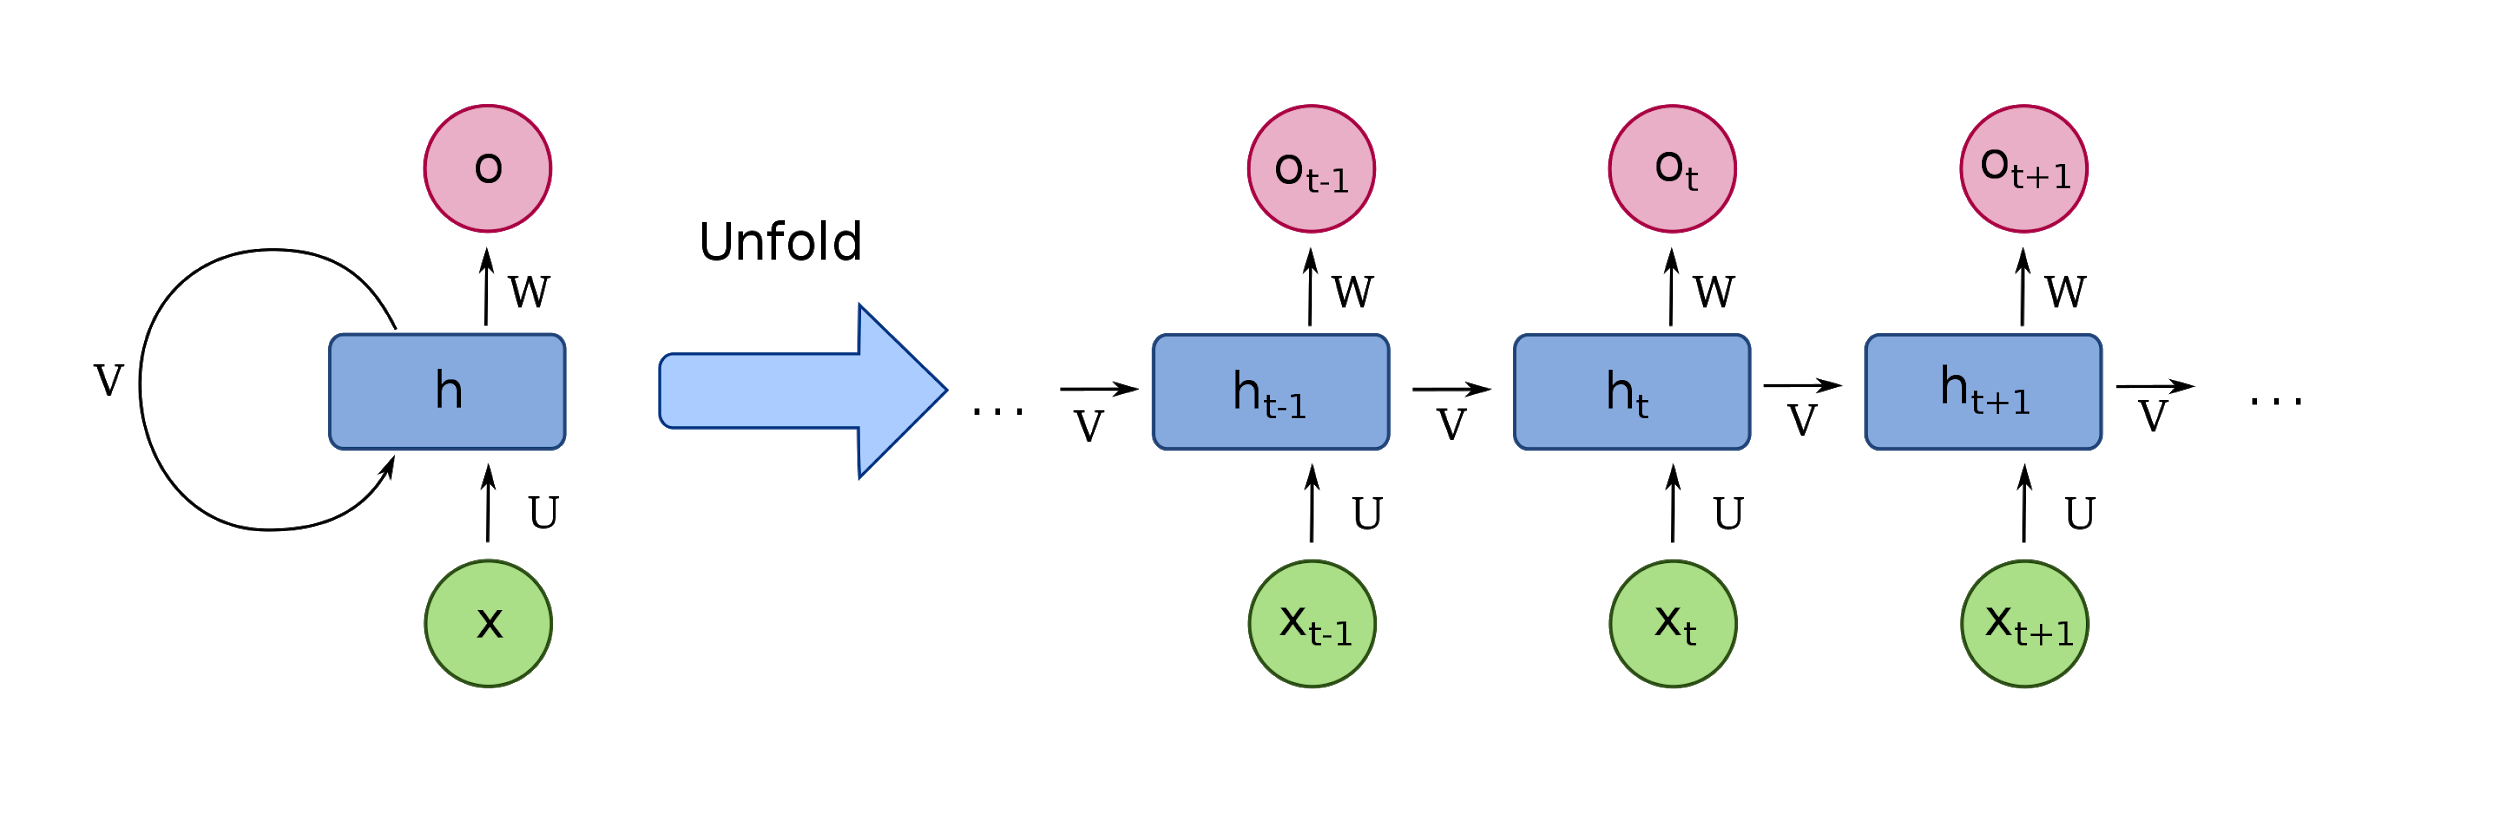
Rekurrente neuronale Netze sind eine grundlegende Architektur mit vielen Variationen. Ein RNN wird hauptsächlich verwendet, um Sequenz-zu-Sequenz-Probleme zu lösen, bei denen der Eingang eine Folge und der Ausgang eine andere Sequenz ist. Diese Probleme umfassen typischerweise:
- Sprachübersetzung (Englisch ins Chinesisch)
- Erzeugung (Vorhersage des nächsten Elements in einer Sequenz)
Es gibt viele Varianten. Von diesen sind das LSTM und der Transformer in der Regel die wichtigsten. Letzterer ist verantwortlich für den OpenAI GPT-3-Hype. LSTM und Transformer sind beide Möglichkeiten, dem Modell Speicher hinzuzufügen und zu steuern. So funktionieren sie: Das RNN ist eine Folge von Knoten, die als gerichteter Graph dargestellt werden können. Während Informationen durch jeden Knoten fließen, lernt der Knoten, vorherzusagen, was als Nächstes kommt.
- Das LSTM ist eine Ergänzung zum klassischen RNN, die es dem RNN ermöglicht, eine gewisse Kontrolle über seinen Speicher zu haben, indem Daten, die kürzlich entstanden sind, als wichtiger und Daten, die in der Vergangenheit entstanden sind, als weniger wichtig definiert wird.
- Der Transformator ist eine weitere Ergänzung, die der RNN auch mehr Speicherkontrolle verleiht, indem er nicht nur Entfernungen in der Vergangenheit als wichtig abbildet, sondern auch eine Populationsverteilung vergangener Ereignisse erzeugt und diese angibt, was für die Gegenwart am wichtigsten ist.
Sortier-/Clustering-Architekturen
Verwendung für:
- Anomalieerkennung
- Mustererkennung
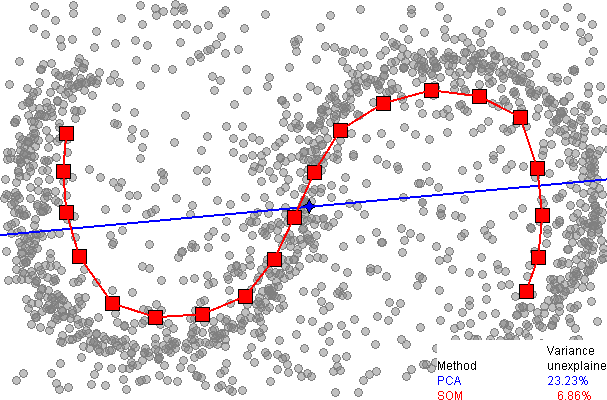
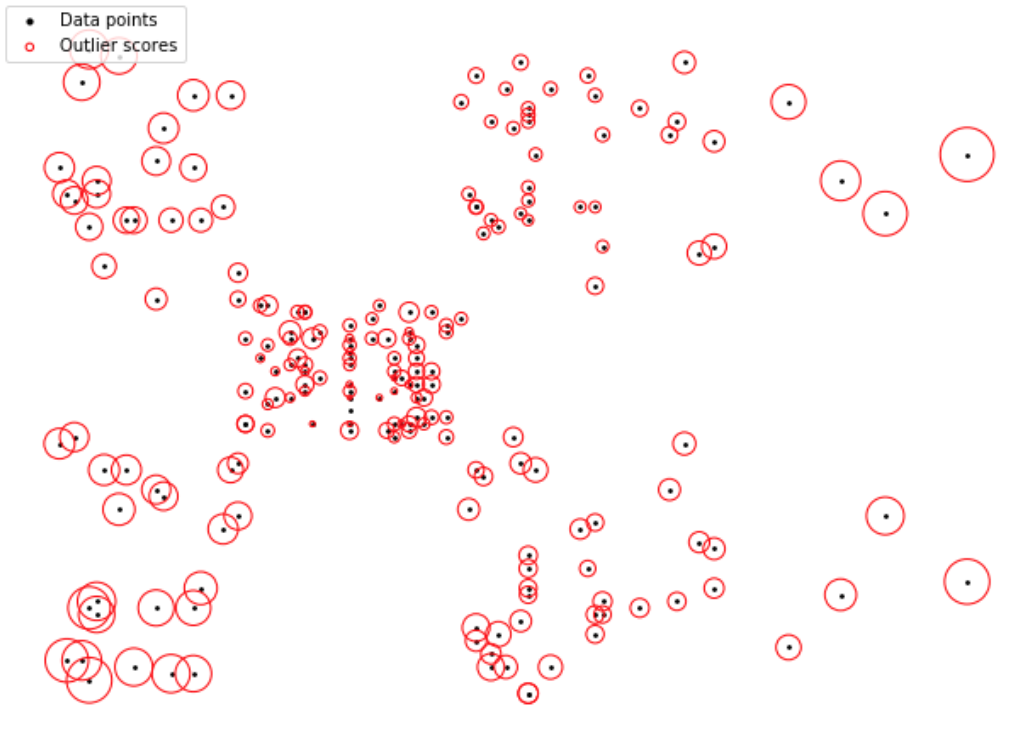
Sortier- und Clustering-Algorithmen werden verwendet, um die Verteilung einer Population zu betrachten und möglicherweise etwas Unknown in den Daten zu entdecken. Daher sind sie großartige Modelle für unüberwachte Modellierungsszenarien und unstrukturierte Daten. Die Modelle können verwendet werden, um:
- Erkenne Muster und teile eine Gruppe in Klassen ein, wie Gruppen von Menschen, die Country, Rock oder Hip-Hop mögen.
- Erkennungsanomalien durch das Identifizieren von Ausreißern in einem Datensatz, wie Personen, die keines dieser Genres mögen.
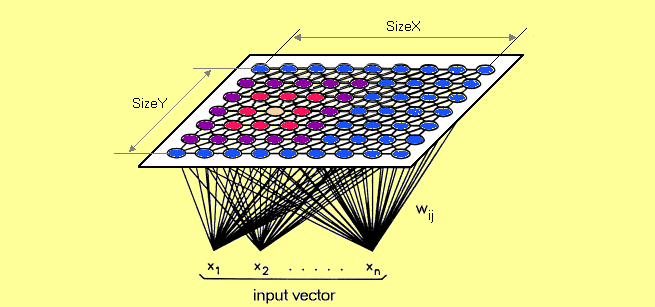
Die Selbstorganisierende Karte ist ein gängiges Werkzeug in RNNs. Die SOM besteht aus zwei Schichten, einer Eingabe und einer Ausgabe. Die Ausgabeschicht der selbstorganisierenden Karte ist eine Merkmalskarte. Sehr ähnlich wie die erste Schicht des CNN: Man sieht, dass die Art und Weise, wie die Merkmalskarte gebildet wird, von Modell zu Modell stark variieren kann. Aber die Ausgabeschicht bleibt ein wesentlicher Schritt, um Datenpunkte in eine ML-Architektur sinnvoll zu verwandeln.
Die Datenausgabe könnte ähnlich aussehen wie in der untenstehenden Grafik, wo:
- Jeder blaue Knoten (Punkt) könnte Personen mit niedriger Kreditwürdigkeit sein.
- Der khakifarbene Punkt in der Mitte könnte eine Person mit einem Kredit-Score von 800+ sein.
Die selbstorganisierende Karte kennt diese Merkmale natürlich nicht im Voraus. Wenn sie die Karte erstellt, vergleicht der Algorithmus die Dateneingaben nebeneinander und dann:
- Wenn sie ähnlich sind, bleiben sie nah beieinander.
- Wenn sie nicht ähnlich sind, werden die beiden weiter auseinandergedrängt.
Sprachmodelle verwenden üblicherweise eine ähnliche Sortiermethode , um bedeutungslose Wörter in eine Merkmalskarte umzuwandeln, die für Berechnungen verwendet werden kann.
Beliebte ML-Modelle, die auf unstrukturierten Daten verwendet werden, sind:
- Selbstorganisierende Karten (SOM)
- K-bedeutet
- C-bedeutet
- Erwartungsmaximierungs-Metaalgorithmus (EM)
- Adaptive Resonanztheorie (ART)
- Ein-Klassen-Unterstützungsvektormaschine
Generative Modelle
Verwendung für:
- Anomalieerkennung
- Mustererkennung
- Cybersicherheit
- Selbstfahrende Autos
- Verstärktes Lernen
Generative Modelle sind eine Art von ML-Modellen, die dazu dienen, Daten zu generieren, die identisch mit den Proben sind. Sie werden verwendet, um zu sagen, wie wahrscheinlich ein bestimmtes Beispiel ist. Sie können Gesichter erzeugen, die wie Prominente aussehen. Sie werden in der Cybersicherheit eingesetzt, um zu sagen, wie wahrscheinlich es ist, dass ein Bild ein Deepfake ist oder wie wahrscheinlich eine IP-Adresse ein Angreifer ist. GANs können Fälschungen erkennen.
In dieser Architektur trainiert ein ML-Modell, indem es ein zufälliges Datenstück generiert und es mit einem echten Datensatz testet:
- Wenn ein Diskriminator es als real ausgibt, funktioniert es; wenn nicht, geht es zurück und versucht es erneut.
- Wenn ein gefälschter Datenpunkt durchgeht, kann der Diskriminator besser in seiner Arbeit werden und wird mit dem generierten Datensatz der Fälschungen aktualisiert.
Der Generator und der Diskriminator spielen ein Spiel miteinander, um den anderen zu übertreffen.
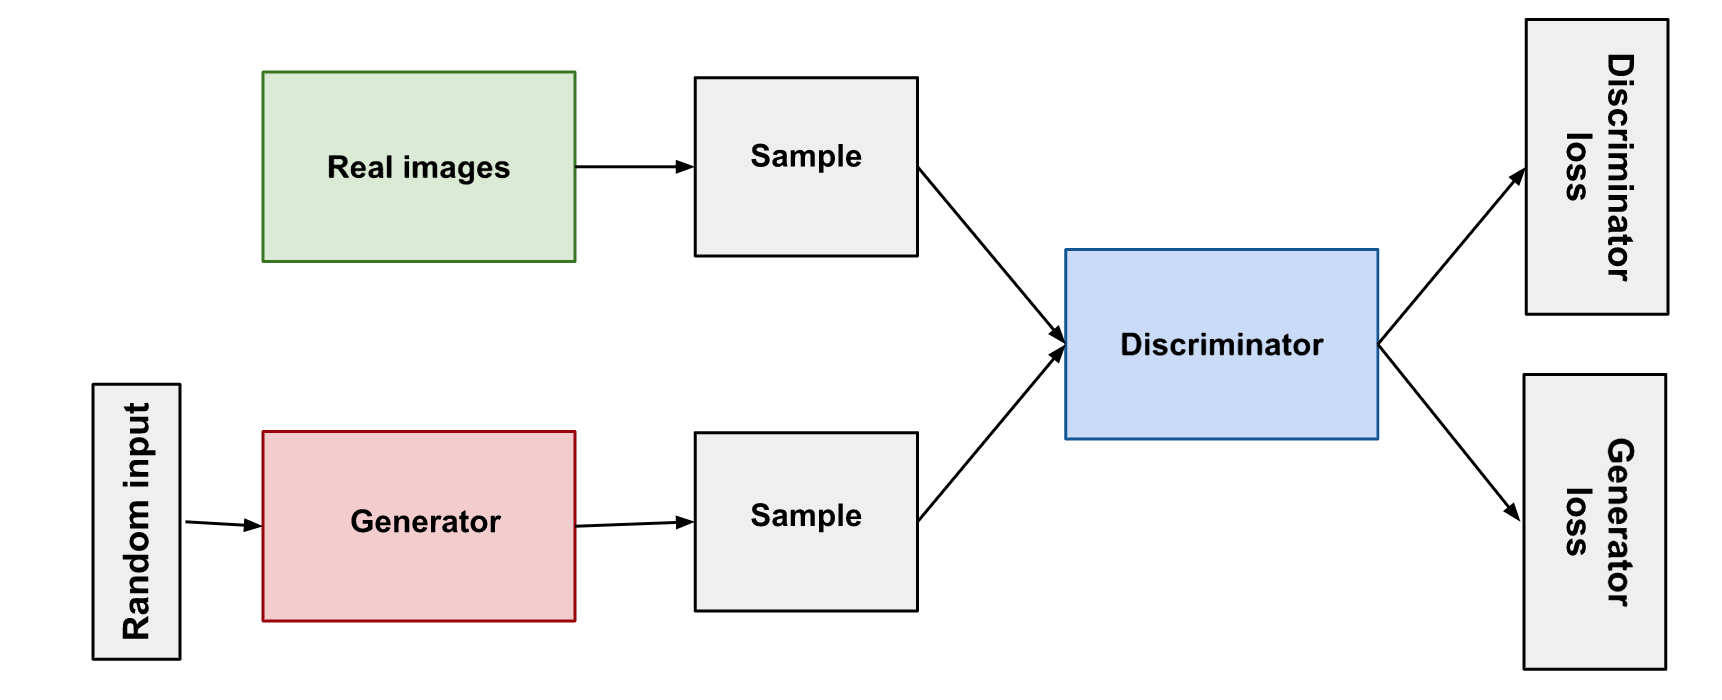
Für Simulationsspiele ist der Generator ähnlich wie Tom Cruise in Edge of Tomorrow, der (eine Generation) spawnt und versucht, bis zum Ende zu schaffen, um den Krieg zu besiegen. Oder, wie Neo in The Matrix, der ein generierter Datenpunkt ist, der immer seinen Weg zum Großen Schöpfer findet, und wenn er das tut, versagt das System und muss von vorne beginnen.
Beliebte generative ML-Modelle sind:
- Generative Adversariale Netzwerke (GANs)
- Boltzmann-Maschinen
- Verstecktes Markov-Modell
- Variations-Autoencoder
Maschinelle Lernmodelle vs. Architekturen
Modelle und Architektur sind nicht dasselbe. Denken Sie daran, dass Ihre maschinelle Lernarchitektur das größere Element ist. Betrachten Sie es als Ihren Gesamtansatz für das Problem, das Sie lösen müssen. Die Architektur liefert die Arbeitsparameter – wie Anzahl, Größe und Art der Schichten in einem neuronalen Netzwerk.
Modelle sind ein Teil Ihrer Architektur; eine spezifische Instanz, die auf einem ausgewählten Datensatz trainiert. Zum Beispiel bilden in einem neuronalen Netz die trainierten Gewichte jedes Knotens gemäß der Architektur das Modell.
Zusätzliche Ressourcen
Für mehr zu diesem Thema entdecken Sie diese Ressourcen:
- BMC Machine Learning & Big Data Blog
- Was ist ein tiefes neuronales Netzwerk? Tiefe Netze erklärt
- Top-Frameworks für maschinelles Lernen
- Leitfaden zu ML mit Keras & TensorFlow
- scikit-learn-Leitfaden
- Containerisiertes maschinelles Lernen: Eine Einführung in ML in Containern
- Wie man maschinelle Lerntransformationen in AWS Glue ausführt
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.