




Auf einen Blick: Die Erkennung von Ausreißern ist entscheidend für Anwendungen wie Betrugserkennung und Analyse von Gerätefehlern. Der Leitfaden erklärt die Isolation Forest-Methode in scikit-learn, die Ausreißer durch Analyse von Datenverteilungen und Anomaliewerten identifiziert.
- Techniken zur Erkennung von Ausreißern umfassen Z-Score und Isolation Forest.
- Isolation Forest verwendet Entscheidungsbäume, um Ausreißer durch zufällige Datenaufteilung zu identifizieren.
In diesem Artikel erklären wir, wie man Ausreißererkennung durchführt. Ausreißererkennung ist in verschiedenen Szenarien wichtig: Kreditkartenbetrug, Cybersicherheit und zum Beispiel zur Erkennung fehlerhafter Geräte in Systemen.
Der Ansatz
Der einfachste Ansatz zur Ausreißererkennung ist die Annahme einer Normalverteilung und dann eine Schwelle bei einer bestimmten Anzahl von Standardabweichungen. Das nennt man den z-Wert.
In diesem Beispiel verwenden wir einen anderen Ansatz – einen Isolationswald. Es handelt sich um eine Art Entscheidungsbaum, der Werte zufällig auswählt, jeden Datenpunkt auf einen zufällig ausgewählten Bereich aufteilt und dann einen weiteren zufällig ausgewählten Wert in einem immer kleiner werdenden Wertebereich auswählt, bis ihm die Werte zum Aufteilen ausgehen. Schließlich markiert er Ausreißer, die auf dem kürzesten Pfad in diesem Baum liegen. Dadurch werden Ausreißer durch Berechnung eines Anomaliewerts markiert.
In der untenstehenden Probe simulieren wir Beispieldaten, um zu veranschaulichen, wie man Anomalieerkennung mit einem Isolationswald im scikit-learn-Machine-Learning-Framework durchführt.
Der Code, erklärt
Der Code für dieses Beispiel ist hier.
Zuerst ziehen wir 100 Proben aus einer Standardnormalverteilung mit Mittelwert 4 und Standardabweichung 1, um eine 100x2-Matrix zu erstellen:
train = rng.normal(4,1,(100,2))
Jetzt trainiere dieses Modell:
    from sklearn.ensemble import IsolationForest

clf = IsolationForest(behaviour='new', max_samples=100,
                      random_state=rng, contamination='auto')

clf.fit(train)
Als Nächstes erstellen wir eine weitere Probe.
typical = rng.normal(4,1,(100,2))
Wenn wir das drucken, sehen wir, dass die Werte zwischen 2 und 6 liegen. Wir erstellen also Ausreißer der Werte 8 und 1:
    outliers = np.array([
                     [8,6],
                     [1,4]
])
Hier ist der vollständige Code:
    import numpy as np
import matplotlib.pyplot as plt
from sklearn.ensemble import IsolationForest

rng = np.random.RandomState(20)

train = rng.normal(4,1,(100,2))


typical =  rng.normal(4,1,(100,2))

outliers = np.array([
                     [8,6],
                     [1,4]
])


clf = IsolationForest(behaviour='new', max_samples=100,
                      random_state=rng, contamination='auto')

clf.fit(train)

pred_train = clf.predict(train)
pred_test = clf.predict(typical)
pred_outliers = clf.predict(outliers)
Hier ist eine Stichprobe der Daten. Sie liegen zwischen über 1 und unter 6, daher werden wir Daten über und unter 1 und 6 mocken, die der Algorithmus als Ausreißer markieren sollte.
    typical

array([[2.49602218, 5.31396783],
       [3.96987389, 4.63501308],
       [4.50243523, 5.16196591],
       [3.69425171, 5.71228277],
       [5.169437  , 3.72418513],
       [1.48821929, 3.58272819],
       [4.54157245, 3.8548927 ],
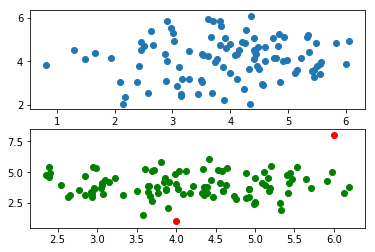
Dann führen wir drei Vorhersagen durch und zeichnen sie dar, wobei wir die zweite Spalte in jeder Matrix [:1] auf den x-Spalten und die erste Spalte auf der y-Achse [:0] darstellen, einfach als einfache Möglichkeit, die Paare zu visualisieren. Da sie aus einer Normalverteilung stammen, gruppieren sie sich um die Mitte.
    pred_train = clf.predict(train)
pred_test = clf.predict(typical)
pred_outliers = clf.predict(outliers)
    fig, axis = plt.subplots(2)

axis[0].scatter(train[:,1], train[:,0] )

axis[1].scatter(typical[:,1], typical[:,0]  , c='g'  )
axis[1].scatter(outliers[:,1], outliers[:,0] , c='r'  )
Die Punkte [8,6] und [1,4] sind Ausreißer, was leicht zu erkennen ist, da wir sie rot zeichnen.
scikit Lernleitfaden
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.