




Auf einen Blick: Eine resiliente Datenpipeline passt sich an Ausfälle an und gewährleistet gleichzeitig eine genaue Datenlieferung. Wichtige Komponenten sind Beobachtbarkeit zur Fehlererkennung, strukturierte Prozesse wie Idempotenz und Unveränderlichkeit für Zuverlässigkeit sowie Datenvalidatoren zur Bestätigung der Datenintegrität.
- Observabilität ermöglicht eine schnelle Fehlererkennung und -korrektur.
- Strukturierte Prozesse gewährleisten eine konsistente Datenbereitstellung bei Ausfällen.
- Datenvalidatoren überprüfen eingehende Daten anhand der erwarteten Formate und Einschränkungen.
Eine resiliente Datenpipeline erkennt Ausfälle, erholt sich davon und liefert dem Verbraucher genaue Daten. Resilienz basiert auf drei Komponenten: Observabilität, strukturierte Prozesse (einschließlich Idempotenz und Unveränderlichkeit) und Datenvalidatoren. Zusammen sorgen diese dafür, dass sich eine Datenpipeline anpasst, anstatt zu zerbrechen, wenn etwas schiefgeht.
Was macht eine Datenpipeline widerstandsfähig?
Resilienzbedeutet , die Fähigkeit zur Anpassung zu haben. Eine resiliente Datenpipeline passt sich im Falle eines Ausfalls an. Da Datenpipelines darauf ausgelegt sind, Daten von einem Punkt zum anderen zu transportieren und zu transformieren, muss eine resiliente Pipeline:
- Fehler erkennen
- Wiederherstellung von Ausfällen
- Geben Sie dem Verbraucher genaue Daten zurück
Idempotenz
Unveränderlichkeit
Eineunveränderliche Infrastruktur verringert die Komplexität und ermöglicht eine einfache Begründung des Systemverhaltens.
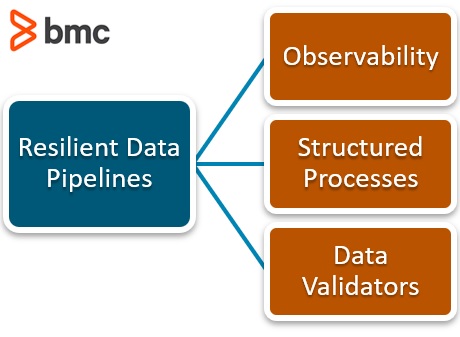
Um dies zu erreichen, sind drei Komponenten erforderlich: Observabilität, strukturierte Prozesse (einschließlich Idempotenz und Unveränderlichkeit) und Datenvalidatoren.
Wie unterstützt Observability resiliente Datenpipelines?
Beobachtbarkeit stellt sicher, dass Fehler schnell genug erkannt werden, um korrigiert zu werden. Wenn ein Fehler unbemerkt bleibt, kann er nicht behoben werden. Gute Protokollarbeit hilft, Fehler aufzudecken, und gut geschriebene Protokolle ermöglichen es, den Fehler schnell zu erkennen und zu lokalisieren . Entwickler – meist die Leser dieser Protokolle – müssen verstehen, was passiert ist und was dagegen zu tun ist.
Eine gute Logmeldung enthält drei Dinge:
- Eine angemessene, konsistente Kategorie für die Art des aufgetretenen Fehlers
- Eine konkrete Beschreibung, was den Fehler verursacht hat
- Klare Hinweise darauf, welche Maßnahmen ergriffen werden müssen, um den Fehler zu korrigieren
Wenn ein Log dem Entwickler einen Weg gibt, das Problem zu beheben, ohne dass er den Code durchsuchen muss, ist es ein gutes Log.
Logs können auch sowohl auf Pipeline- als auch auf Aufgabenebene geschrieben werden. Sie sollten folgende Antworten beantworten:
- Warum ist die Pipeline-Aufgabe gescheitert?
- Wann wurde die Pipeline geplant?
Egal, ob Sie eigene Prozessoren verwenden oder von einem Drittanbieter mieten, jeder Prozessor sollte Logs erstellen – und Sie sollten auf Drittanbieter-Logs zugreifen oder eigene Protokolle schreiben, um Ihr Sichtfenster zu erweitern.
Schließlich sollten die Daten, nachdem die Daten durch die Pipeline gegangen sind, bestätigen, dass die Daten ihr Ziel erfolgreich erreicht haben.
Beobachtbarkeit erstreckt sich auch auf Pipeline-Ressourcenmetriken. Überwachen Sie Systemlatenz, Batch-Warteschlangenzeit und Ressourcenverbrauch pro Lauf, um Leistungsverschlechterungen zu erkennen, bevor es zum Ausfall wird.
Wie verbessern strukturierte Prozesse die Widerstandsfähigkeit von Pipelines?
Die Resilienz verbessert sich, wenn die Infrastruktur einer Datenpipeline mit Blick auf Vorhersehbarkeit ausgelegt ist. Das Ziel ist es, Prozesse zu nutzen, die das gleiche erwartete Ergebnis konstant liefern – auch im Falle eines Ausfalls . Idempotenz und Unveränderlichkeit sind zwei solcher Prozesse, die sicherstellen, dass Daten den Endnutzer korrekt erreichen, auch wenn ein Prozessor nicht verfügbar ist, mitten im Versand stoppt oder mehrfach ausgelöst wird.
Strukturierte Prozesse erreichen zwei Dinge:
- Sie sorgen dafür, dass gute Daten den Endnutzer erreichen
- Sie sorgen dafür, dass Daten auch bei einem Systemausfall ankommen
Idempotenz ist eine Funktion, die bei jeder wiederholten Ausführung dasselbe Ergebnis zurückgibt. Absolute Funktionen und Rundungsfunktionen sind von Natur aus idempotent. Nicht alle Funktionen sind idempotent, aber Funktionen können so geschrieben werden, dass sie sich idempotent verhalten.
Betrachten wir eine Löschfunktion , die auf einer Datenliste arbeitet. Wenn das Ziel darin besteht, die Zahl 2 am Index 2 zu entfernen, ist eine Funktion, die einfach alles am zweiten Index löscht , nicht idempotent – mehrmals ausgeführt wird 2, dann 3, dann 4 nacheinander entfernt. Eine idempotente Version würde stattdessen angeben: Wenn der Wert am Index 2 2 ist, löschen Sie sie. Diese Version kann wiederholt ausgeführt werden und liefert immer die korrekte Ausgabe. (Wikipedia listet weitere Beispielefür idempotente Funktionen auf .)
Traditionell konnten veränderliche Server während der Nutzung aktualisiert und modifiziert werden. Das Problem ist, dass jedes Update kleine Unterschiede zwischen Servern erzeugt – einer läuft mit Version 1.34, ein anderer mit 1.74, ein anderer mit 1.22. Fehler auf diesen divergenten Servern zu identifizieren wird kompliziert, und die Versionsführung der Pipeline ist schwierig, wenn die zugrundeliegende Infrastruktur eine sich bewegende Mischung von Versionen ist.
Unveränderlichkeit bedeutet, dass Daten nach dem Schreiben auf den Server nicht gelöscht oder verändert werden können . Unveränderliche Infrastruktur vereinfacht die Pipeline-Versionierung und trennt Infrastrukturbaufehler von tatsächlichen Datenverarbeitungsaufgaben.
In einer unveränderlichen Infrastruktur könnte Schritt 1 darin bestehen , eine VM-Instanz zu erstellen, und Schritt 2, um Benutzerdaten darauf zu schreiben. Wenn die VM-Erstellung fehlschlägt, führt das System Schritt 1 erneut aus, bis eine stabile Instanz bereit ist, bevor Daten geschrieben werden. In einer veränderlichen Infrastruktur ist derselbe Ausfallweg komplexer, fehleranfälliger und schwerer zu versionieren.
Was tragen Datenvalidatoren zur Widerstandsfähigkeit von Pipelines bei?
Datenvalidatoren fungieren als letztes Qualitätsgatter in einer resilienten Datenpipeline. Die Validierung erfolgt, wenn die Daten beim Verbraucher ankommen und die eingehenden Daten schnell verarbeitet werden, um zu überprüfen, ob sie den Erwartungen des Verbrauchers entsprechen.
Datenvalidatoren prüfen auf:
- Datentypen – Ganzzahl-, String-, Boolean- und andere Typbeschränkungen
- Strukturelle Einschränkungen – zum Beispiel ein gültiges Universitäts-E-Mail-Format, eine Telefonnummer mit 10 Ziffern oder ein Wert größer als null
- Quantitative Validierung – domänenspezifische Plausibilitätsprüfungen, wie das Markieren einer NBA-Spielergröße, die mit vier Fuß angegeben ist, oder ein Dinosaurierfossil datiert vor drei Wochen
Validatoren helfen sicherzustellen, dass geeignete Daten an den Verbraucher zurückgegeben werden, bergen jedoch eigene Risiken: Je nach Implementierung können Validatoren die Pipeline-Latenz erhöhen, und schlecht geschriebene Validatoren erfüllen ihre vorgesehene Funktion möglicherweise nicht vollständig.
Wie passt sich eine resiliente Datenpipeline an, wenn ein Fehler auftritt?
Resilienz bedeutet, sich im Falle eines Ausfalls anzupassen. Durch die Integration von Observabilität in die Pipeline werden Fehler angekündigt und sichtbar gemacht, was Korrekturmaßnahmen ermöglicht. Strukturierte Prozesse wie Idempotenz und Unveränderlichkeit bauen eine Infrastruktur auf, die auch unter Ausfallbedingungen standhält. Datenvalidatoren bestätigen, dass geeignete Daten am Ende der Pipeline beim Verbraucher ankommen. Mit den durchgehenden korrekten Protokollen werden Fehler offengelegt und – ob automatisiert oder durch menschliche Korrektur – kann sich die Pipeline frei anpassen.
Der Aufbau resilienter Datenpipelines im Unternehmensmaßstab erfordert eine Datenpipeline-Orchestrierungslösung , die SLA-Überwachung, automatische Retry-Logik, Abhängigkeitsmanagement und plattformübergreifende Transparenz in einer einzigen Kontrollebene bietet.
Häufig gestellte Fragen: resiliente Datenpipelines
Was ist eine resiliente Datenpipeline?
Eine resiliente Datenpipeline ist eine, die Fehler erkennt, sich davon erholt und weiterhin genaue Daten an den Verbraucher zurückgibt . Resilienz wird durch Observabilität, strukturierte Prozesse wie Idempotenz und Unveränderlichkeit sowie Datenvalidatoren aufgebaut, die überprüfen, ob eingehende Daten den erwarteten Kriterien entsprechen.
Was ist Idempotenz in einer Datenpipeline?
Idempotenz in einer Datenpipeline bedeutet, dass eine Funktion dasselbe Ergebnis liefert, unabhängig davon, wie oft sie ausgeführt wird. Idempotente Funktionen sind entscheidend für Ausfallwiederherstellungsszenarien, in denen ein Prozessor neu gestartet, mehrfach ausgelöst oder mitten in der Ausführung stoppen kann.
Was ist der Unterschied zwischen Idempotenz und Unveränderlichkeit in Datenpipelines?
Idempotenz bezeichnet Funktionen, die bei wiederholter Ausführung konsistente Ergebnisse liefern. Unveränderlichkeit bezeichnet Daten oder Infrastrukturen, die nach dem Schreiben nicht mehr verändert werden können. Beide Eigenschaften verbessern die Zuverlässigkeit der Pipeline: Idempotenz sorgt für wiederholbare Ergebnisse bei Wiederholungen, während Unveränderlichkeit die Versionsführung vereinfacht und Build-Fehler aus der Datenverarbeitung isoliert.
Was sollte ein gutes Datenpipeline-Protokoll enthalten?
Ein gutes Datenpipeline-Protokoll sollte die Fehlerkategorie, eine spezifische Beschreibung der Fehlerursache und klare Anleitungen zur Behebung enthalten. Logs sollten sowohl auf Pipeline- als auch auf Aufgabenebene geschrieben werden und einen Bestätigungseintrag enthalten, wenn die Daten erfolgreich von Ende zu Ende durch die Pipeline gereist sind.
Wie schützen Datenvalidatoren die Datenintegrität?
Datenvalidatoren überprüfen, ob die beim Verbraucher ankommenden Daten mit erwarteten Typen, strukturellen Einschränkungen und domänenspezifischen Plausibilitätskriterien übereinstimmen. Sie fungieren als letzte Integritätsprüfung in der Pipeline und erkennen beschädigte, fehlgeformte oder unglaubwürdige Daten, bevor sie nachgelagerte Systeme oder Endnutzer erreichen.
Zusätzliche Ressourcen
Mehr zu diesem Thema finden Sie im BMC DevOps Blog oder sehen Sie sich diese Artikel an:
- Resilienz-Engineering: Eine Einführung
- Wie man eine Machine-Learning-Pipeline erstellt
- Maschinelles Lernen mit TensorFlow & Keras, einem mehrteiligen Tutorial
Die in diesem Beitrag geäußerten Ansichten und Meinungen sind die des Autors und spiegeln nicht unbedingt die offizielle Position von BMC wider.
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.