




Auf einen Blick: Scikit-learn ist eine leistungsstarke Python-Bibliothek für maschinelles Lernen, die statistische Funktionen und Algorithmen betont. Dieser Leitfaden behandelt die Installation über Anaconda und demonstriert ein einfaches Beispiel für eine lineare Regression mit perfekt korrelierten Daten.
- Installationsanleitung für scikit-learn über Conda.
- Beispiel für lineare Regression mit perfekt korrelierten Daten.
- Visualisierung der Ergebnisse mit Matplotlib.
Hier beleuchten wir ein weiteres Machine-Learning-Framework, scikit-learn, und zeigen außerdem, wie man Matplotlib zum Zeichnen von Graphen verwendet. Schau dir die offizielle Website von scikit-learn an.
Die scikit-learn Python-ML-API ist älter als Apache Spark und TensorFlow, das heißt, sie gibt es länger als Big Data. Sie wird schon lange von denen verwendet, die sich selbst als reine Data Scientists sehen, im Gegensatz zu Data Engineers. Dennoch kann man scikit-learn mit Spark verbinden, sodass man die Transformationen und Berechnungen über einen Cluster von Maschinen ausführen kann. Ohne das kann man nur mit Datensätzen arbeiten, die in den Speicher, die CPU-Geschwindigkeit und den Festplattenspeicher einer einzelnen Maschine passen.
Scikit-Learn ist sehr stark in statistischen Funktionen und vollgepackt mit fast jedem Algorithmus, den man sich vorstellen kann, einschließlich solcher, die nur Akademiker und Mathematiker verstehen würden, sowie neuronalen Netzen, das angewandte ML ist. Aber man muss kein Mathematiker sein, um mit dem Produkt zu beginnen. Hier zeigen wir, wie man das einfachste Beispiel kodiert.
Umwelt
Du solltest conda verwenden, um Python einzurichten und Pakete zu installieren. Das macht es einfach, sckit-learn mit Zeppelin Notebooks zu integrieren. Es ist schwierig, Python-Pakete zu Zeppelin hinzuzufügen.
Du könntest dieses Beispiel aus der Python-Kommandozeile ausführen, aber Zeppelin ist grafisch, sodass du mit MatplotLib schöne Graphen zeichnen kannst.
Wenn du Zeppelin installierst, installiere das Paket mit ALLEN Interpretern, sodass Python, Spark, Matplotlib usw. vorhanden sind. Folge diesem Beispiel , wenn du neu bei Zeppelin bist, um das zu verstehen.
Installiere Anaconda und gib dann diesen Befehl ein, um scikit-learn zu installieren:
Beispiel
conda install scikit-learn
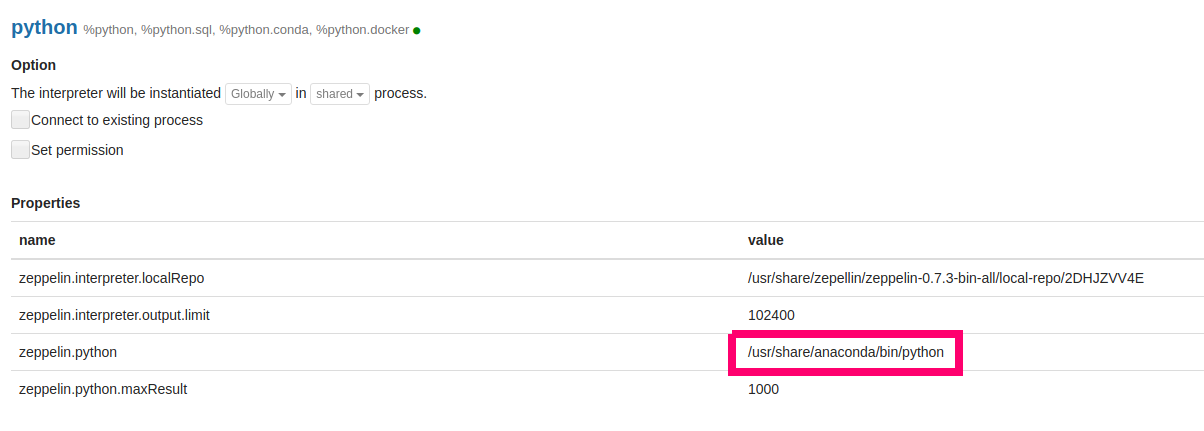
Dann richte in Zeppelin deinen Python-Interpreter auf die Anaconda Python so:
Wir nehmen das einfachste mögliche Beispiel, nämlich die lineare Regression mit 1 unabhängiger Variable und 1 abhängiger Variable. Und wir richten unsere Daten so an, dass die Daten perfekt korreliert sind, das heißt, die Varianz beträgt 1. Mit anderen Worten: Bei LR ist das Ziel, diese Gleichung für eine Gerade zu lösen, indem man den Koeffizienten m und y, den Schnitt b findet.
y = mx + b
Unser Ziel ist es jedoch nur zu zeigen, wie man scikit-learn verwendet. Wir werden unsere Daten also mit y = 2x + 0 = 2x simulieren. (Wenn Sie ein realistischeres Beispiel wollen, könnten Sie die Standardnormalverteilung verwenden, daraus einen Zufallsrauschfaktor ziehen und zu y addieren.)
Der Code aus diesem Beispiel wird hier als Zeppelin-Notizbuch gespeichert. Unten zeigen wir den Code in Abschnitten. Du kannst die Abschnitte in Zeppelin-Absätze in einem Zeppelin-Notizbuch einfügen. Achte darauf, den Python-Interpreter auszuwählen, wenn du das Notizbuch erstellst.
    import matplotlib.pyplot as plt
from sklearn import linear_model
import numpy as np
from sklearn.metrics import mean_squared_error, r2_score
Zuerst instanziieren wir das LinearRegressionsmodell .
reg = linear_model.LinearRegression()
Als Nächstes erstellen wir ein Array. Links sind die unabhängigen Variablen 1, 2, 3. Rechts sind die abhängigen Variablen 2, 4, 6. Wie Sie sehen, ist jede abhängige Variable y gleich jeder abhängigen Variable x mal 2, also y=2x.
Scikit-Learn erwartet, dass du ein Numpy-Array verwendest.
    ar = np.array([[[1],[2],[3]], [[2],[4],[6]]])
ar
Ergebnisse. Das Ausdrucken jedes Ergebnisses hilft, es zu visualisieren und zu verstehen.
    array([[[1],
        [2],
        [3]],
       [[2],
        [4],
        [6]]])
Hier schneiden wir das Array, indem wir nur die y-Variablen nehmen. (Das Slicen und Umformen von Arrays ist ein kompliziertes Thema. Darüber können Sie hier lesen.) Diese Arrayform, ar.shape, ist in diesem Tupel (2,3,1) angegeben. Dies ist ein Array 1 von 2 Arrays. Wir Alternativen nehmen also das erste 1 x 3 Array an der zweiten Position für y:
Ergebnisse:
    y = ar[1,:]
y
Ergebnisse:
    array([[2],
       [4],
       [6]])
Dann nimm das erste für x.
Ergebnisse:
    x = ar[0,:]
x
Ergebnisse:
    array([[1],
       [2],
       [3]])
Nun haben wir die unabhängigen Variablen in einem einfachen Vektor x gespeichert und die abhängigen Variablen in y. Im Bereich des maschinellen Lernens sagen wir, wir haben 1 Merkmal und 1 Label.
Nun führen wir fit() aus, wobei die Methode der kleinsten Quadrate verwendet wird, um die Gerade y=mx zu finden, indem wir die Steigung m bestimmen, was dasselbe ist wie der Koeffizient m für die Gerade y = mx.
reg.fit(x,y)
Jetzt können wir den Koeffizienten aus der linearen Regressions-API ausgeben.
print('Coefficients: \n', reg.coef_)
Das Ergebnis ist 2, was wir erwarten würden, da wir wissen, dass die Gerade y = 2x ist.
    Coefficients:
 [[2.]]
Jetzt machen wir Testdaten gleich, 4,5,6 und dann das Zweifache für y:
Ergebnisse:
    xTest = np.array([[4],[5],[6]])
xTest
Ergebnisse:
    array([[4],
       [5],
       [6]])
Geben Sie nun die x-Testwerte xTest in die Prognosemethode ein. Sie liefert ein Array von y-Vorhersagen.
Ergebnisse:
    ytest =  np.array([[8],[10],[12]])

preds = reg.predict(xTest)
preds
Ergebnisse:
    array([[ 8.],
       [10.],
       [12.]])
Betrachten wir nun den Fehler, der die Differenz zwischen den beobachteten Werten (ytest) und den vorhergesagten (preds) ist. Natürlich ist er null.
Ergebnisse:
print("Mean squared error: %.2f" % mean_squared_error(ytest,preds))
Ergebnisse:
Mean squared error: 0.00
Und die Varianz beträgt 1, da die Daten perfekt korreliert sind.
Ergebnisse
print("Variance score: %.2f" % r2_score(ytest,preds))
Ergebnisse
Variance score: 1.00
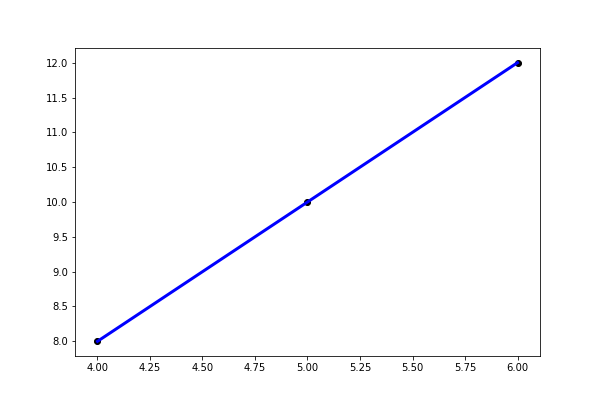
Jetzt können wir mit Matplotlib zeichnen:
    plt.scatter(xTest,preds, color='black')
plt.plot(xTest,preds,color='blue', linewidth=3)

plt.show()
Das ist das einfachste Beispiel dafür, wie man die scikit-learn-ML-Bibliothek zur linearen Regression verwendet.
scikit Lernleitfaden
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.