




Auf einen Blick: Berechnungen der Systemzuverlässigkeit und Verfügbarkeit sind für die Bewertung der IT-Leistung unerlässlich, wobei Zuverlässigkeit die korrekte Betriebswahrscheinlichkeit über die Zeit angibt und die Verfügbarkeit die Leistung in bestimmten Fällen misst. Wichtige Kennzahlen sind die mittlere Zeit bis zum Ausfall (MTTF), die mittlere Zeit zwischen Ausfällen (MTBF) und die mittlere Zeit bis zur Wiederherstellung (MTTR), die für die Bewertung der Systemzuverlässigkeit entscheidend sind.
- Die Zuverlässigkeit nimmt bei Serienkonfigurationen ab; die Verfügbarkeit steigt parallel.
- Effektive Berechnungen hängen von Komponentenkonfigurationen und Redundanzmodellen ab.
Cloud-Computing ist ein geschäftliches Imperativ für Unternehmen jeder Größe: Cloud Computing ermöglicht es Organisationen, IT-Dienste nach einem nutzungsbasierten Abonnementmodell zu nutzen. Um die Zuverlässigkeit eines Systems zu bewerten, hängt das Versprechen von Cloud Computing von zwei viralen Kennzahlen ab:
- Zuverlässigkeit des Dienstes
- Einsatzfähigkeit
Anbieter bieten Service-Level-Agreements (SLAs) an, um spezifische Zuverlässigkeits- und Verfügbarkeitsstandards zu erfüllen. Ein SLA-Verstoß verursacht nicht nur Kostenstrafen für den Anbieter, sondern beeinträchtigt auch das Endnutzererlebnis von Anwendungen und Lösungen, die im Cloud-Netzwerk laufen.
Obwohl Zuverlässigkeit und Verfügbarkeit oft synonym verwendet werden, sind sie im technischen Bereich unterschiedliche Konzepte. Lassen Sie uns die Unterscheidung zwischen Zuverlässigkeit und Verfügbarkeit untersuchen und dann darauf eingehen, wie beides berechnet wird.
Was ist Zuverlässigkeit?
Zuverlässigkeit ist die Wahrscheinlichkeit, dass ein System während einer bestimmten Zeitspanne korrekt funktioniert. Während dieses korrekten Betriebs:
- Keine Reparatur ist erforderlich oder durchgeführt
- Das System folgt den definierten Leistungsspezifikationen angemessen
Die Zuverlässigkeit folgt einem exponentiellen Versagensgesetz, was bedeutet, dass sie mit Ablauf der für Zuverlässigkeitsberechnungen betrachteten Zeitspanne abnimmt. Mit anderen Worten: Die Zuverlässigkeit eines Systems ist im Anfangszustand hoch und reduziert sich im Laufe der Zeit allmählich auf die niedrigste Größe.
[Helix-Video]
Was ist Verfügbarkeit?
Verfügbarkeit bezieht sich auf die Wahrscheinlichkeit, dass ein System zu einer bestimmten Zeitinstanz (nicht zur Dauer) korrekt funktioniert. Unterbrechungen können vor oder nach der Zeitinstanz auftreten, für die die Verfügbarkeit des Systems berechnet wird. Der Dienst muss:
- Seien Sie einsatzbereit
- Die zum Zeitpunkt der Anwendung definierten Spezifikationen ausreichend erfüllen
Die Verfügbarkeit wird im stationären Zustand gemessen und berücksichtigt potenzielle Ausfallzeiten, die einen Dienst während der prognostizierten Nutzungsdauer unverfügbar machen können (und werden). Zum Beispiel bezieht sich eine Verfügbarkeit von 99,999 % (Five-9's) auf 5 Minuten und 15 Sekunden Ausfallzeit pro Jahr.
(Erfahren Sie mehr über Verfügbarkeitsmetriken und die 9er der Verfügbarkeit.)
Einsatz- und Servicekennzahlen
Bevor wir darüber sprechen, wie Zuverlässigkeit und Verfügbarkeit berechnet werden, wollen wir die in diesen Berechnungen verwendeten Incident-Service-Kennzahlen verstehen. Diese Kennzahlen werden durch umfangreiche Experimente, Erfahrung oder industrielle Standards berechnet; sie werden nicht direkt beobachtet. Daher liefern die resultierenden Berechnungen nur ein relativ genaues Verständnis der Systemzuverlässigkeit und Verfügbarkeit.
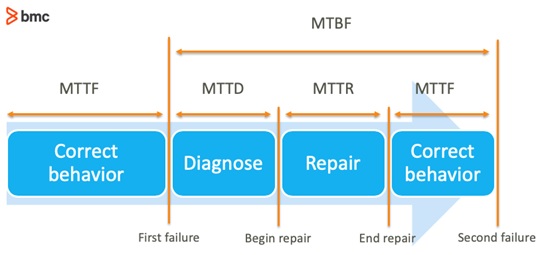
Die folgende Grafik und die folgenden Abschnitte zeigen die relevantesten Kennzahlen zu Vorfällen und Dienstleistungen:
Ausfallrate
Die Häufigkeit des Bauteilausfalls pro Zeiteinheit. Sie wird üblicherweise mit dem griechischen Buchstaben λ (Lambda) bezeichnet und wird verwendet, um die später in diesem Beitrag angegebenen Metriken zu berechnen. In Zuverlässigkeitsberechnungen wird die Ausfallrate als prognostizierte Ausfallintensität betrachtet, vorausgesetzt, das Bauteil ist im Anfangszustand voll funktionsfähig. Die Formel ist für reparierbare und nicht reparierbare Systeme wie folgt angegeben:
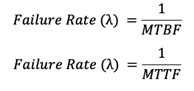
Reparaturrate
Die Häufigkeit erfolgreicher Reparaturoperationen an einem defekten Bauteil pro Zeiteinheit. Sie wird üblicherweise mit dem griechischen Buchstaben μ (Mu) bezeichnet und wird verwendet, um die später in diesem Beitrag angegebenen Metriken zu berechnen. Die Reparaturrate wird mathematisch wie folgt definiert:
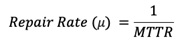
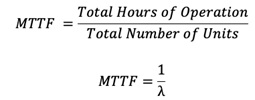
Mittlere Zeit bis zum Scheitern (MTTF)
Die durchschnittliche Zeit, bevor eine nicht reparierbare Systemkomponente ausfällt. Die folgende Formel berechnet MTTF:
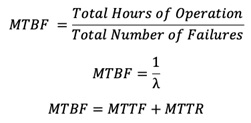
Mittlere Ausfallzeit (MTBF)
Die durchschnittliche Zeitspanne zwischen den inhärenten Ausfällen einer reparierbaren Systemkomponente. Zur Berechnung des MTBF werden folgende Formeln verwendet:
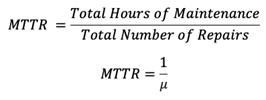
Mittlere Erholungszeit (MTTR)
Die durchschnittliche Zeit, um ein defektes Bauteil zu reparieren und in den Betriebszustand zurückzukehren. Diese Metrik umfasst die während des Alarm- und Diagnoseprozesses verbrachten Zeit, bevor Reparaturaktivitäten eingeleitet werden. (Die durchschnittliche Zeit, die ausschließlich für den Reparaturprozess aufgewendet wird, wird als mittlere Reparaturzeit bezeichnet.)
Mittlere Detektionszeit (MTTD)
Die durchschnittliche Zeit verging zwischen dem Auftreten eines Bauteilausfalls und dessen Erkennung.
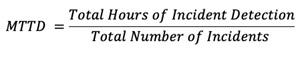
Zuverlässigkeits- und Verfügbarkeitsberechnungen
Die untenstehenden Berechnungen werden auf Zuverlässigkeits- und Verfügbarkeitsattribute einer einzelnen Komponente berechnet. Die Ausfallrate kann wie zuvor beschrieben austauschbar mit MTTF und MTBF verwendet werden.
- Die Zuverlässigkeit wird als exponentiell abnehmende Wahrscheinlichkeitsfunktion berechnet, die von der Ausfallrate abhängt. Da die Ausfallrate über den Betriebszyklus einer Komponente nicht konstant bleiben kann, können auch zeitbasierte durchschnittliche Größen wie MTTF oder MTBF zur Berechnung der Zuverlässigkeit verwendet werden. Die mathematische Funktion wird wie folgt angegeben:
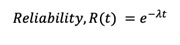
- Die Verfügbarkeit bestimmt die momentane Leistung einer Komponente zu einem bestimmten Zeitpunkt basierend auf der Zeit zwischen ihrem Ausfall und der Wiederherstellung. Die Verfügbarkeit wird mit folgender Formel berechnet:
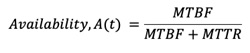
Berechnung von Mehrkomponentensystemen
IT-Systeme bestehen aus mehreren Komponenten, die als komplexe Architektur verbunden sind. Die effektive Zuverlässigkeit und Verfügbarkeit des Systems hängt von den Spezifikationen einzelner Bauteile, Netzwerkkonfigurationen und Redundanzmodellen ab. Die Konfiguration kann Serien-, Parallel- oder eine Hybridverbindung aus Serien- und Parallelverbindungen zwischen Systemkomponenten sein. Redundanzmodelle können Ausfälle interner Systemkomponenten berücksichtigen und somit die effektive Systemzuverlässigkeit und Verfügbarkeitsleistung verändern.
Ein Zuverlässigkeitsblockdiagramm (RBD) kann verwendet werden, um die Verbindung zwischen einzelnen Komponenten zu demonstrieren. Alternativ können analytische Methoden auch verwendet werden, um diese Berechnungen für großflächige und komplexe Netzwerke durchzuführen. RBD, das eine hybride Mischung aus Serien- und Parallelverbindungen zwischen Systemkomponenten demonstriert, wird bereitgestellt:
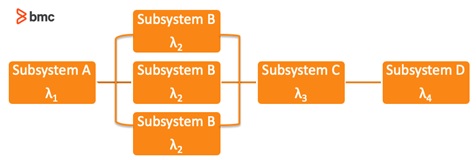
Die Grundlagen einer RBD-Methodik werden im Folgenden hervorgehoben.
Verwendung von Ausfallraten
Die effektiven Ausfallraten werden verwendet, um die Zuverlässigkeit und Verfügbarkeit des Systems anhand folgender Formeln zu berechnen:
- Für seriengeschaltete Bauteile wird die effektive Ausfallrate als Summe der Ausfallraten jeder Komponente bestimmt.
- Für N reihengeschaltete Bauteile:

- Für parallel geschaltete Bauteile wird MTTF als reziproke Summe der Ausfallraten jeder Systemkomponente bestimmt.
- Für N parallelgeschaltete Komponenten:
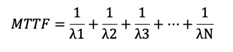
- Bei hybriden Systemen können die Verbindungen zunächst auf Serien- oder Parallelkonfigurationen reduziert werden.
Verwendung von Verfügbarkeits- und Zuverlässigkeitsspezifikationen
Berechnen Sie die Zuverlässigkeit und Verfügbarkeit jeder einzelnen Komponente.
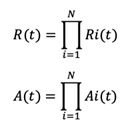
- Für serienzusammenhängende Komponenten wird das Produkt aller Komponentenwerte berechnet.
- Für N serienverbundene Bauteile.
- Für parallel zusammenhängende Komponenten verwenden Sie die Formel:
- Für N parallelgeschaltete Komponenten.
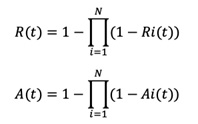
- Für hybride verbundene Bauteile reduzieren Sie die Berechnungen zunächst auf Serien- oder Parallelkonfigurationen.
Es ist zu beobachten, dass die Zuverlässigkeit und Verfügbarkeit eines serienverbundenen Netzwerks von Komponenten niedriger ist als die Spezifikationen einzelner Bauteile. Zum Beispiel werden zwei Komponenten mit 99 % Verfügbarkeit in Reihe geschaltet, was 98,01 % Verfügbarkeit ergibt. Das Gegenteil gilt für das Parallelkombinationsmodell. Wenn eine Komponente 99 % Verfügbarkeitsspezifikationen hat, dann kombinieren sich zwei Komponenten parallel zu 99,99 % Verfügbarkeit; und vier Komponenten in paralleler Verbindung liefern 99,9999 % Verfügbarkeit. Das Hinzufügen redundanter Komponenten zum Netzwerk erhöht die Zuverlässigkeit und Verfügbarkeitsleistung zusätzlich.
Es ist wichtig, einige Vorbehalte bezüglich dieser Incident-Metriken sowie der damit verbundenen Zuverlässigkeits- und Verfügbarkeitsberechnungen zu beachten.
- Diese Kennzahlen können relativ wahrgenommen werden. Ausfall kann für dieselben Komponenten in verschiedenen Anwendungen, Anwendungsfällen und Organisationen unterschiedlich definiert werden.
- Der Wert von Metriken wie MTTF, MTTR, MTBF und MTTD sind Durchschnittswerte, die in Experimenten unter kontrollierten oder spezifischen Umgebungen beobachtet wurden. Diese Messungen halten sich in realen Anwendungen möglicherweise nicht konsistent.
Organisationen sollten daher Systemzuverlässigkeit und Verfügbarkeitsberechnungen dem Geschäftswert und der Endnutzererfahrung zuordnen. Entscheidungen erfordern möglicherweise strategische Abwägungen mit Kosten, Leistung und Sicherheit, und Entscheidungsträger müssen Fragen stellen, die über die von IT-Abteilungen befolgten Systemzuverlässigkeitsmetriken und -spezifikationen hinausgehen.
Zusätzliche Ressourcen
Die folgende Literatur wurde für Systemzuverlässigkeits- und Verfügbarkeitsberechnungen, die in diesem Artikel beschrieben wurden, referenziert:
- Johnson, Barry. (1988). Design und Analyse fehlertoleranter digitaler Systeme. Kapitel 1-4.
- Johnson, Barry. (1996). Eine Einführung in das Design und die Analyse fehlertoleranter Systeme. 1-87.
Verwandte Literatur
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.