




Auf einen Blick: Amazon DynamoDB ist eine skalierbare Key-Value-NoSQL-Datenbank, die für leistungsstarke und transaktionale Unterstützung entwickelt wurde und JSON-ähnliche Datenstrukturen nutzt. Sie ermöglicht effiziente Abfragen und Aktualisierungen und bietet gleichzeitig verschiedene SDKs für eine nahtlose Integration.
- DynamoDB unterstützt Transaktionen und sorgt so für Datenkonsistenz während des Betriebs.
- Integrationsoptionen umfassen Amazon Glue und Apache Hive für die Datenverarbeitung.
DynamoDB ist eine Schlüssel-Value-NoSQL-Datenbank , die von Amazon entwickelt wurde. Sie unterscheidet sich von einigen anderen Produkten von Amazon und anderen Anbietern dadurch, dass es sich nicht nur um ein Open-Source-System wie Spark handelt, das auf der Plattform des Anbieters gehostet wird. Amazon hat dies für ihre eigenen internen Bedürfnisse geschrieben und stellt es nun ihren Kunden zur Verfügung.
Wie funktioniert DynamoDB?
DynamoDB sieht genauso aus wie JSON, mit dem einen Unterschied, dass jeder JSON-Datensatz den Datensatzschlüssel enthalten muss. Das hat den Vorteil, dass man so Updates an einem Datensatz durchführen kann. In einer JSON-Datenbank wie MongoDB kann man Datensätze nicht aktualisieren. Stattdessen muss man sie löschen und dann die geänderte Version wieder hinzufügen, um dieselbe Änderung vorzunehmen.
DynamoDB ermöglicht es auch, mit Transaktionen zu arbeiten, etwas, das MongoDB ebenfalls unterstützt. Nicht alle NoSQL-Datenbanken lassen das zu. Das ist wichtig, da bestimmte Datenbankoperationen logisch zusammengeführt werden müssen. Zum Beispiel muss eine Verkaufstransaktion sowohl den Lagerbestand reduzieren als auch das Cash-on-Depositum erhöhen. Wenn eine dieser beiden Operationen fehlschlägt, wären Verkaufs- und Lagersysteme aus dem Gleichgewicht.
Sie arbeiten mit der Datenbank über den AWS-Befehlszeilen-Client, APIs für verschiedene Programmiersprachen, deren NoSQL-Workbench-Desktop-Tool oder auf der Amazon-AWS-Website. Zum Beispiel zeigt der untenstehende Bildschirm, wie Sie eine Tabelle erstellen.
Beachte, dass du einfach den Schlüssel erstellst. Das liegt daran, dass es JSON ist, das heißt, es gibt keine Struktur, kein Schema. Alle anderen Attribute können also alles sein.
DynamoDB-Definitionen
DynamoDB bietet folgende Konzepte und mehr:
- Tabelle: eine Sammlung von Gegenständen
- Element: eine Sammlung von Attributen. (Andere Datenbanken nennen diese Aufzeichnungen oder Dokumente.)
- Stream: wie ein Cache, der Änderungen im Speicher speichert, bis sie ins Speicher zurückgeführt werden.
- Partitionsschlüssel: der Primärschlüssel. Er muss eindeutig sein.
- Partitionsschlüssel und Sortierschlüssel: ein zusammengesetzter Primärschlüssel, also ein Partitionsschlüssel mit mehr als einem Attribut, wie dem Mitarbeiternamen und der Mitarbeiter-ID (notwendig, da zwei Mitarbeiter denselben Namen haben können).
- Sekundäre Indizes: Du kannst andere Attribute indexieren, die du häufig absuchst, um das Lesen zu beschleunigen.
API und SDK
Wie bei den meisten Cloud-Systemen stellt DynamoDB seine Dienste über Webdienste bereit. Das bedeutet jedoch nicht, dass man seine Daten in JSON formatieren und dann über HTTP posten muss. Stattdessen stellen sie Softwareentwicklungskits (SDKs) bereit. Das SDK nimmt die Anfragen, die Sie senden, und übersetzt sie dann hinter den Kulissen in HTTP-Aufrufe. So bietet das SDK eine natürlichere und deutlich weniger wortreiche Arbeitsweise mit der Datenbank. Das SDK ermöglicht es, mit DynamoDB zu arbeiten, wie man es mit normalen Objekten tun würde.
Das SDK verfügt über folgende Methoden:
- PutItem
- BatchWriteItem
- GetItem
- BatchGetItem
- Abfrage
- Scannen
- UpdateItem
- DeleteItem
- ListStreams
- GetShardIterator
- GetRecords
- TransactWriteItems
- TransactGetItems
AWS CLI
Wie bei anderen Amazon-Produkten kannst du den AWS-Kommandozeilen-Client verwenden. Damit kannst du Datenbankoperationen über die Kommandozeile ausführen, ohne ein Programm schreiben zu müssen. Du nutzt JSON, um mit DynamoDB zu arbeiten.
Zum Beispiel gibt es diese Operationen und einige weitere:
- AWS Dynamodb Create-Table
- AWS Dynamodb Put-Item
SDKs
DynamoDB verfügt über SDKs für diese Programmiersprachen:
- Java
- JavaScript
- .NET
- JS
- PHP
- Python
- Ruby
- C++
- Los,
- Android
- iOS
Für Java und .NET stellen sie Objekte bereit. Diese ermöglichen es, mit Tabellenelementen zu arbeiten, als wären sie Objekte in diesen Programmiersprachen. Und es übersetzt von Datentypen, sodass man zum Beispiel Daten und Bytes verwenden kann, anstatt auf Faksimiles dieser als Zeichenketten oder Zahlen beschränkt zu sein, wie man es bei JSON tun würde.
Zum Beispiel fügt man bei Java das hinzu @annotation kann dann mit der Tabelle arbeiten, als wäre sie ein Java-Objekt. So muss man nichts Wortreicheres machen, wie SQL oder JSON verwenden.
    @DynamoDBTable(tableName = "ProductCatalog")
    public static class CatalogItem {
        private Integer id;
        private String title;
        private String ISBN;
        private Set bookAuthors;
DynamoDB ist herunterladbar
Du kannst DynamoDB auch herunterladen und auf deinem lokalen System laufen lassen. Auf deren Webseite wird nicht erwähnt, ob das kostenlos ist, also ob du es ewig nutzen kannst und nie bezahlen kannst. Die Idee ist, dass du es nutzt, um Code lokal zu testen und so Geld zu sparen, bevor du ihn in die Cloud bindest.
Du kannst es zum Beispiel als Maven-Abhängigkeit in dein Java-Projekt hinzufügen. Das bedeutet, wenn du deinen Java-Code im Code-Editor ausführst, lädt er DynamoDB herunter und startet eine Instanz für dich, ohne dass Konfigurationen nötig sind.
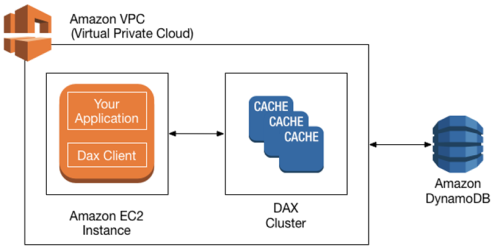
Amazon DynamoDB Beschleuniger (DAX)
DAX ist eine optionale Funktion, die DynamoDB in eine In-Memory-Datenbank verwandelt.
Integration mit anderen Systemen
- Amazon Glue. In diesem Fall ziehst du Daten von DynamoDB in Amazon Glue. Dann ETL und schreibst sie dann in andere Systeme wie das Amazon Redshift Data Warehouse.
- Apache Hive auf Amazon EMR. Dies ist eher eine Hin und Her Schnittstelle. Man kann dies zum Beispiel nutzen, um mit HiveQL (der Hive SQL-Sprache) DynamoDB-Tabellen abzufragen. Und man kann Daten in Hadoop kopieren. (Hive fährt auf Hadoop, um EMR zu unterstützen, was die mapReduce-Operation ist.) Man kann auch DynamoDB-Tabellen in Hive verbinden.
Quoten
DynamoDB-Benutzer unterliegen von Amazon Quoten. Diese werden in Kapazitätseinheiten angegeben. Der Benutzer kann eine zusätzliche Quote anfordern. Zum Beispiel gilt bei einer Schreibtransaktion 1 Kapazitätseinheit = ein Schreiben pro Sekunde bis zu 1 KB.
Transaktionen, Lesungen und Stream-Operationen sind ebenfalls alles Kapazitätseinheiten.
Preisgestaltung
Wie bei EC2 gibt es getrennte Preise für On-Demand- und bereitgestellte (d. h. dedizierte) Ressourcen. Für eine bereitgestellte Instanz kostet eine Schreibkapazitätseinheit 0,00065 $. Lesen kostet 0,00013 $.
Die Speicherpreise variieren je nach Amazon-Rechenzentrum. US-East in Ohio kostet 0,25 $ pro 25 GB.
DAX wird stundenweise bepreist und variiert je nach virtueller CPU und Speichergröße. Zum Beispiel kostet 1 vCPU und 1,5 GB Speicher 0,04 $ pro Stunde.
Zusätzliche Ressourcen
Mehr zu diesem Thema finden Sie im BMC Big Data & Machine Learning Blog oder schauen Sie sich diese Ressourcen an:
- AWS-Leitfaden mit 15+ Artikeln und Tutorials zu AWS
- Verfügbarkeitsregionen und -zonen für AWS, Azure & GCP
- Datenbanken auf AWS: Wie Cloud-Datenbanken in eine Multi-Cloud-Welt passen
- Eine Einführung in die Datenbankzuverlässigkeit
- MongoDB Guide & Apache Cassandra Guide, jeweils mit Artikeln und Tutorials
DynamoDB-Leitfaden
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.