




Auf einen Blick: Mit TensorFlow zeigt dieser Leitfaden, wie man ein neuronales Netzwerk erstellt, um die Bewertungen von Hotelkunden aus dem Las Vegas Strip-Datensatz vorherzusagen. Er enthält notwendige Voraussetzungen, Datenvorbereitung und Implementierungsschritte für das Modelltraining.
- Voraussetzungen umfassen die Installation von TensorFlow und Python-Kenntnisse.
- Das Tutorial nutzt TripAdvisor-Daten für Trainings- und Vorhersageprozesse.
Wenn Menschen versuchen, neuronale Netze mit TensorFlow zu lernen, beginnen sie meist mit der Handschriftdatenbank. Dies erstellt ein Modell, das anhand von Handschriftproben von Tausenden von Personen vorhersagt, welche Ziffer eine Person gezogen hat. Um das in Merkmale-Label-Begriffe zu fassen: Die Pixelkombinationen in einem Graustufenbild (weiß, schwarz, grau) bestimmen, welche Ziffer gezeichnet wird (0, 1, .., 8, 9).
Hier verwenden wir andere Daten.
Voraussetzungen
Bevor Sie dieses TensorFlow Neural Network-Tutorial lesen, sollten Sie zunächst diese drei Blogbeiträge lesen:
Einführung in TensorFlow und logistische Regression
Was ist ein neuronales Netzwerk? Einführung in neuronale Netzwerke Teil I
Dann musst du TensorFlow installieren. Am einfachsten geht das auf Ubuntu, indem du diesen Anweisungen folgst und virtualenv nutzt .
Dann installiere Python Pandas, Numpy, scikit-learn und SciPy-Pakete .
Der Las Vegas Strip Hotel-Datensatz von Trip Advisor
Programmierer, die lernen, TensorFlow zu nutzen, beginnen oft mit der Iris-Datendatenbank. Das angesichts der Kombination von Pixeln, die zeigen, welche Art von Irisblüte gezeichnet wird. Aber wir wollen hier etwas Originelles machen, anstatt den Iris-Datensatz zu verwenden. Deshalb verwenden wir den Las Vegas Strip Data Set, der im Artikel "Moro, S., Rita, P., & Coelho, J. (2017) zitiert wird. Das Feedback der Kunden zu Hotels durch Data Mining: Der Fall Las Vegas Strip. Tourismusmanagement-Perspektiven, 23, 41-52." Und sehen, ob wir ein neuronales Netzwerk darum herum umwickeln können.
In ihrem Artikel schrieben die Autoren ein Modell mit der Programmiersprache R und verwendeten Support Vector Matrices (SVMs) als ihren Algorithmus. Das ist eine Art nichtlineares Regressionsproblem. Es verwendet denselben Ansatz zur Lösung regulärer LR-Probleme, nämlich eine Linie zu finden, die den MSE (mittlerer Quadratfehler) auf den tiefsten Punkt reduziert, um ein prädiktives Modell zu erstellen. Aber SVMs erhöhen diese Komplexität noch etwas, indem sie mit mehreren, nichtlinearen Eingaben arbeiten und eine Ebene im n-dimensionalen Raum und nicht eine Linie auf der XY-kartesischen Ebene finden.
Hier nehmen wir dieselben Daten, verwenden aber ein neuronales Netzwerk anstelle von SVM. Wir werden dies in 3 Blogbeiträgen präsentieren:
- Fügen Sie Daten in numerisches Format ein.
- Trainiere neuronale Netzwerke.
- Mach eine Vorhersage.
Die Daten und der Code für dieses Tutorial finden Sie hier.
Die Daten
Klicken Sie hier, um die Daten im Google Sheets-Format zu sehen. Die Daten sind zu breit, um auf einen Bildschirm zu passen, daher zeigen wir sie unten in zwei Siebdrucken. Wenn Sie den oben zitierten Artikel lesen, können Sie mehr Details zu den Daten erhalten, aber im Grunde handelt es sich um TripAdvisor-Daten für 21 Hotels entlang des Las Vegas Strip. Das Ziel ist es, ein Modell zu erstellen, das vorhersagt, welche Punktzahl eine Person wahrscheinlich an welches Hotel vergeben wird. Die Punktzahl liegt bei 1 bis 5 und die Eingaben sind 20 Variablen, die in der untenstehenden Tabelle beschrieben sind.
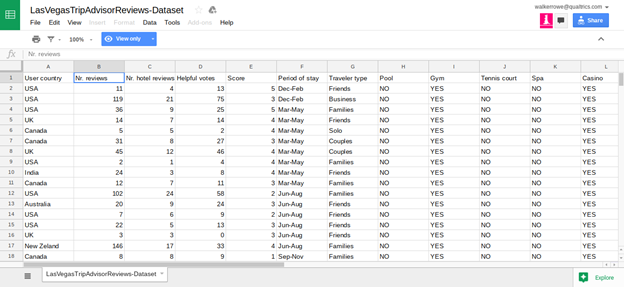
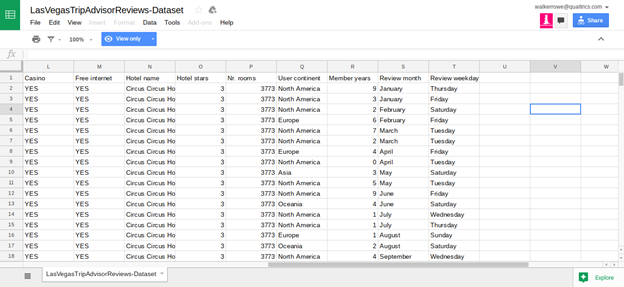
Die Autoren des Artikels sagen, dass bestimmte Daten – wie etwa ob das Hotel ein Casio, einen Pool, die Anzahl der Sterne oder kostenloses Internet hat – wenig Einfluss auf die vom Hotelgast auf Tripadvisor angegebene Bewertung haben. Vielmehr sind die Faktoren, die die Bewertung am stärksten vorhersagen, die Anzahl der Rezensionen, die der Rezensent verfasst hat, und wie lange er bereits Rezensionen schreibt. Weitere Faktoren, die die Bewertung beeinflussen, sind der Wochentag und der Monat des Jahres.
Werte in ganze Zahlen umwandeln
Du kannst den untenstehenden Code aus diesem iPython-Notizbuch herunterladen.
Zuerst müssen wir all diese Werte in ganze Zahlen umwandeln, da maschinelles Lernen Zahlenarrays als Eingabe verwendet. Wir verfolgen drei Ansätze:
- Wenn die Zahl bereits eine ganze Zahl ist, lass sie weg.
- Wenn die Zahl JA oder NEIN ist, ändere sie auf 1 oder 0.
- Wenn das Element in einer Zeichenkette ist, dann verwenden Sie die Ordinalzeichenzeichenfunktion , um jeden Buchstaben in eine ganze Zahl zu verwandeln. Dann summieren Sie diese ganzen Zahlen.
    import pandas as pd

def yesNo(x):
    if x=="YES":
        return 1
    else:
        return 0

def toOrd(str):
    x=0
    for l in str:
        x += ord(l)
    return int(x)

cols = ['User country', 'Nr. reviews','Nr. hotel reviews','Helpful votes',
        'Score','Period of stay','Traveler type','Pool','Gym','Tennis court',
        'Spa','Casino','Free internet','Hotel name','Hotel stars','Nr. rooms',
        'User continent','Member years','Review month','Review weekday']

df = pd.read_csv('/home/walker/TripAdvisor.csv',sep=',',header=0)
Hier ändern wir jede Zeichenkette in eine Ganzzahl. Man müsste die Zeichenkette-Ganzzahl-Kombination in einer Datenstruktur speichern, damit man später sehen kann, welche Ganzzahl welchen Zeichenkettenwert entspricht.
So sehen unsere Daten jetzt aus.
Wir haben bereits das Problem erklärt, das wir lösen wollen, nämlich vorherzusagen, wie jemand eines der Hotels in Las Vegas auf TripAdvisor bewerten könnte, basierend darauf, wie andere das gemacht haben. Als Nächstes schreiben wir den Code, um ein neuronales Netzwerk zu erstellen, das das tun kann. In diesem Teil erstellen wir das Trainingsmodell. Danach können wir unser TensorFlow Neural Network nutzen, um Vorhersagen zu treffen.
Voraussetzungen für den Aufbau unseres neuronalen Netzwerks
- Python 3
- Du musst Tensorflow in Python 3 installieren, also pip3 install – upgrade tensorflow
- Laden Sie diese Daten herunter. Dies sind diese Trip-Advisor-Daten , die mit diesem Programm in ganze Zahlen umgewandelt wurden. Sie haben diese Spaltenüberschriften. All diese Elemente sind Merkmale. Punktzahl ist das Label.
    User country,Nr. reviews,Nr. hotel reviews,Helpful votes,Score,Period of stay,
Traveler type,Pool,Gym,Tennis court,Spa,Casino,Free internet,Hotel name,
Hotel stars,Nr. rooms,User continent,Member years,Review month,Review weekday
Unten ist der Code, den Sie von hier aus kopieren können. Wir erklären jeden Abschnitt.
Unten fügen wir jeden Spaltennamen in ein Array ein. Es gibt 21 Spalten. Die FIELD_DEFAULTS werden als 21 ganze Zahlen angegeben. Wir verwenden ganze Zahlen, um TensorFlow zu zeigen, dass dies ganze Zahlen und keine Gleitzahlen sind.
    import tensorflow as tf

feature_names = ['Usercountry', 'Nrreviews','Nrhotelreviews','Helpfulvotes','Score','Periodofstay',
                 'Travelertype','Pool','Gym','Tenniscourt','Spa','Casino','Freeinternet','Hotelname',
                 'Hotelstars','Nrrooms','Usercontinent','Memberyears','Reviewmonth','Reviewweekday']
FIELD_DEFAULTS = [[0], [0], [0], [0], [0],
                 [0], [0], [0], [0], [0],
                 [0], [0], [0], [0], [0],
                 [0], [0], [0], [0], [0], [0]]
Als Nächstes möchten wir die Daten als .csv-Datei lesen. Tensorflow bietet die tf.decode_csv()- Methode, um jeweils eine Zeile nach der anderen zu lesen. Wir verwenden die Dataset map()- Methode, um parse_line für jede Zeile im Datensatz aufzurufen . Dies erstellt einen TensorFlow-Datensatz, der kein normaler Python-Datensatz ist. Er ist dafür konzipiert, mit Tensoren zu arbeiten. Wenn Sie nicht wissen, was ein Tensor ist, können Sie dies überprüfen.
Diese Routine gibt die Features als Wörterbuch und das Label als Label zurück. Beachten Sie, dass wir den Score (parsed_line[4]) aus den Features löschen, da Score kein Feature ist. Es ist ein Label. Die dict(zip()) -Methoden legen die Schlüsselnamen ins Wörterbuch,
    def parse_line(line):
   parsed_line = tf.decode_csv(line, FIELD_DEFAULTS)
   label = parsed_line[4]
   del parsed_line[4]
   features = parsed_line
   d = dict(zip(feature_names, features))
   print ("dictionary", d, " label = ", label)
   return d, label
Tensorflow stellt die Methode tf.data.TextLineDataset() bereit, um eine .csv Datei in einen TensorFLow-Datensatz einzulesen. tf.estimator.DNNClassifier.train() erfordert, dass wir eine Funktion aufrufen, in diesem Fall csv_input_fn(), die einen Datensatz mit Features und Labels zurückgibt. Wir verwenden dataset.shuffle(), da diese beim Erstellen eines neuronalen Netzwerks verwendet wird.
    def csv_input_fn(csv_path, batch_size):
   dataset = tf.data.TextLineDataset(csv_path)
   dataset = dataset.map(parse_line)
   dataset = dataset.shuffle(1000).repeat().batch(batch_size)
   return dataset
Wir müssen für jede Spalte im Datensatz Tensoren erstellen. Wir haben sowohl kategorische Daten (z. B. 0 und 1) als auch Zahlen, z. B. Anzahl der Überprüfungen.
Der kategoriale Datensatz kodiert z. B. mit, was bedeutet, dass es 47 Kategorien gibt. Mit anderen Worten : Unsere Daten stammen von Personen aus 47 verschiedenen Ländern. Wir können df['User continent'].groupby(df['User continent']).count() zum Beispiel verwenden , um die eindeutigen Elemente zu zählen.
tf.feature_column.indicator_column(tf.feature_column.categorical_column_with_identity("Usercountry",47))
Numerische Daten, mit denen wir kodieren, zum Beispiel:
Nrreviews = tf.feature_column.numeric_column("Nrreviews")
Hier ist der vollständige Abschnitt. Beachten Sie, dass wir in der letzten Zeile das Array der Tensoren in feature_columns erstellen.
    Usercountry = tf.feature_column.indicator_column(tf.feature_column.categorical_
column_with_identity("Usercountry",47))

Nrreviews = tf.feature_column.numeric_column("Nrreviews")

Nrhotelreviews = tf.feature_column.numeric_column("Nrhotelreviews")

Helpfulvotes = tf.feature_column.numeric_column("Helpfulvotes")

Periodofstay = tf.feature_column.numeric_column("Periodofstay")

Travelertype =
tf.feature_column.indicator_column(tf.feature_column.categorical_column_with_identity("Travelertype",5))

Pool =
tf.feature_column.indicator_column(tf.feature_column.categorical
_column_with_identity("Pool",2))

Gym =
tf.feature_column.indicator_column(tf.feature
_column.categorical_column_with_identity("Gym",2))

Tenniscourt =
tf.feature_column.indicator_column(tf.feature_column.categorical
_column_with_identity("Tenniscourt",2))

Spa =
tf.feature_column.indicator_column(tf.feature_column.categorical
_column_with_identity("Spa",2))

Casino =
tf.feature_column.indicator_column(tf.feature_column.categorical
_column_with_identity("Casino",2))

Freeinternet =
tf.feature_column.indicator_column(tf.feature_column.categorical
_column_with_identity("Freeinternet",2))

Hotelname =
tf.feature_column.indicator_column(tf.feature_column.categorical
_column_with_identity("Hotelname",24))

Hotelstars =
tf.feature_column.indicator_column(tf.feature_column.categorical
_column_with_identity("Hotelstars",5))

Nrrooms =
tf.feature_column.numeric_column("Nrrooms")

Usercontinent =
tf.feature_column.indicator_column(tf.feature_column.categorical
_column_with_identity("Usercontinent",6))

Memberyears = tf.feature_column.numeric_column("Memberyears")

Reviewmonth =
tf.feature_column.indicator_column(tf.feature_column.categorical
_column_with_identity("Reviewmonth",12))

Reviewweekday =
tf.feature_column.indicator_column(tf.feature_column.categorical
_column_with_identity("Reviewweekday",7))
feature_columns = [Usercountry, Nrreviews,Nrhotelreviews,Helpfulvotes,Periodofstay,
Travelertype,Pool,Gym,Tenniscourt,Spa,Casino,Freeinternet,Hotelname,Hotelstars,Nrrooms,
Usercontinent,Memberyears,Reviewweekday]
Hier ist der tf.estimator.DNNClassifier, wobei DNN für Deep Neural Network steht . Wir geben ihm die Feature-Spalten und das Verzeichnis, in dem das Modell gespeichert werden soll. Wir sagen auch, dass es 5 Klassen gibt, da Hotel-Scores von 1 bis 5 reichen. Für versteckte Einheiten wählen wir [10, 10]. Das bedeutet, dass die erste Schicht des neuronalen Netzwerks 10 Knoten hat und die nächste Schicht 10. Mehr darüber können Sie lesen, wie man diese Zahl wählt, indem Sie zum Beispiel diesen StackOverflow-Artikel lesen. Ich weiß noch nicht, ob dies der richtige Wert ist. Wir werden sehen, wenn wir im nächsten Beitrag Vorhersagen treffen.
    classifier=tf.estimator.DNNClassifier(
   feature_columns=feature_columns,
   hidden_units=[10, 10],
   n_classes=5,
   model_dir="/tmp")

batch_size = 100
Schließlich rufen wir die train()- Methode auf und geben ihr einen Inplace-(Lambda)-Aufruf an csv_input_fn sowie den Pfad, von dem aus wir die CSV-Datei lesen.
    classifier.train(
steps=1000,
input_fn=lambda : csv_input_fn("/home/walker/tripAdvisorFL.csv", batch_size))
In einem separaten Blogbeitrag zeigen wir, wie man mit diesem Modell Vorhersagen trifft, also schätzt, wie ein Kunde ein Hotel anhand seiner Eigenschaften bewerten könnte. Das Hotel könnte dann entscheiden, wie viel Aufwand es investieren möchte, um diesen Kunden zufriedenzustellen, oder gar keinen Aufwand aufwenden.
ML mit TensorFlow & Keras Guide
- TensorFlow vs. PyTorch: Die Wahl Ihres ML-Frameworks
- Einführung in TensorFlow und logistische Regression
- Verwendung von TensorFlow zur Erstellung eines neuronalen Netzwerks (mit Beispielen)
- Verwendung des TensorFlow-Neuralnetzwerks für maschinelle Lernvorhersagen mit TripAdvisor-Daten
- Wie die Keras-Maschinensprachen-API TensorFlow erleichtert
- Wie man Keras verwendet, um Klassifikationsprobleme mit einem neuronalen Netzwerk zu lösen
- Deep Learning Schritt-für-Schritt-Neuralnetz-Tutorial mit Keras
- Google Cloud TPUs für ML-Beschleunigung
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.