




Auf einen Blick: Ein Tutorial zum Aufbau eines neuronalen Netzwerks mit Keras, um Produktkäufe basierend auf Funktionen wie Einkommen und Bildung vorherzusagen. Es umfasst Datenvorbereitung, Normalisierung, Modellerstellung, Training und Bewertung und erreicht eine Genauigkeit von 93,78 %.
- Konzentrieren Sie sich darauf, die Kaufwahrscheinlichkeit von Kunden vorherzusagen.
- Enthält Quellcode und Schritte zur Datenverarbeitung.
In diesem Artikel zeigen wir, wie man Keras nutzt, um ein neuronales Netzwerk zu erstellen, eine Erweiterung dieses ursprünglichen Blogbeitrags. Das Ziel ist es, vorherzusagen, wie wahrscheinlich es ist, dass jemand ein bestimmtes Produkt kauft, basierend auf seinem Einkommen, ob er ein Haus besitzt, ob er einen Hochschulabschluss hat usw. Der Quellcode dieses Zeppelin-Notizbuchs finden Sie hier. Zuerst laden Sie die Daten aus dem Internet herunter. Die Feature-Daten sind bereits kategorisch (0 und 1), daher ist keine Umrechnung erforderlich. Die Label-Spalte ist data['Kaufen']. data.iloc[:,2:16] bedeutet, dass die Spalten 2 bis 16 und alle Zeilen verwendet werden, wobei iloc der Indexsuchoperator ist. Der Dickdarm (:) bedeutet alles.
    import tensorflow as tf
from keras.models import Sequential
import pandas as pd
from keras.layers import Dense

url = 'https://raw.githubusercontent.com/werowe/logisticRegressionBestModel/master/KidCreative.csv'

data = pd.read_csv(url, delimiter=',')

labels=data['Buy']
features = data.iloc[:,2:16]
Jetzt teilen wir die Daten in 33%- und 66%-Trainings- und Testdatensätze auf, was die übliche Konvention für maschinelles Lernen ist: Die Eingabedaten nehmen, sie aufteilen und ein Set zum Trainieren des Modells verwenden. Dann verwendet man das andere Set, um dessen Genauigkeit zu überprüfen. np.ravel(labels) erstellt ein Array aus den Labels der Pandas-Serie.
    import numpy as np
from sklearn.model_selection import train_test_split

X=features

y=np.ravel(labels)

X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.33, random_state=42)
Hier normalisieren wir die Daten, was bedeutet, sie auf eine gemeinsame Skala (Wert – Mittelwert / Standardabweichung) zu setzen, eine Machine-Learning-Datenkonvention.
    from sklearn.preprocessing import StandardScaler

scaler = StandardScaler().fit(X_train)

X_train = scaler.transform(X_train)

X_test = scaler.transform(X_test)
Jetzt erstellen wir ein neuronales Netzwerk mit drei Schichten. Die Eingabeform ist (14,1), da es 14 Feature-Spalten im Data Pandas-Datenrahmen gibt. Wir verwenden binary_crossentropy für die Verlustfunktion und Stochastic Gradient Descent für den Optimierer sowie verschiedene Aktivierungsfunktionen. Die Wahl ist willkürlich. Wähle eine, probiere eine andere, wähle eine weitere und sieh, welche das genaueste Modell erzeugt hat. Die Anzahl der Schichten und die Anzahl der Epochen sind völlig willkürlich. Du kannst diese erhöhen, um vielleicht die Genauigkeit des Modells zu erhöhen, aber jede Variation wird nur gering sein, da dieses Modell in nur wenigen Schritten konvergiert.
    model = Sequential()

model.add(Dense(8, activation='relu', input_shape=(14,)))

model.add(Dense(8, activation='relu'))

model.add(Dense(1, activation='sigmoid'))


model.compile(loss='binary_crossentropy',
              optimizer='sgd',
              metrics=['accuracy'])

model.fit(X_train, y_train,epochs=8, batch_size=1, verbose=1)
    Epoch 1/8
450/450 [==============================] - 2s 5ms/step - loss: 0.4760 - acc: 0.7844
Epoch 2/8
450/450 [==============================] - 1s 1ms/step - loss: 0.3338 - acc: 0.8511
Epoch 3/8
450/450 [==============================] - 1s 1ms/step - loss: 0.2521 - acc: 0.9000
Epoch 4/8
450/450 [==============================] - 1s 1ms/step - loss: 0.2058 - acc: 0.9156
Epoch 5/8
450/450 [==============================] - 1s 2ms/step - loss: 0.1829 - acc: 0.9311
Epoch 6/8
450/450 [==============================] - 1s 1ms/step - loss: 0.1740 - acc: 0.9311
Epoch 7/8
450/450 [==============================] - 1s 2ms/step - loss: 0.1630 - acc: 0.9311
Epoch 8/8
450/450 [==============================] - 1s 1ms/step - loss: 0.1583 - acc: 0.9378
Hier verwenden wir die Evaluate()- Methode, um die Genauigkeit des Modells zu zeigen, also das Verhältnis (Anzahl der korrekten Vorhersagen)/(Anzahl der Vorhersagen). Man kann y_pred und y_test nebeneinander ausdrucken und sehen, dass die meisten Vorhersagen mit den Testwerten übereinstimmen. Das ist zu erwarten, da die Genauigkeit dieses Modells 93,78 % beträgt.
    y_pred = model.predict(X_test)

score = model.evaluate(X_test, y_test,verbose=1)

print(score)
    223/223 [==============================] - 1s 3ms/step
[0.18696444257759728, 0.9372197314762748]
Korrelation der Daten
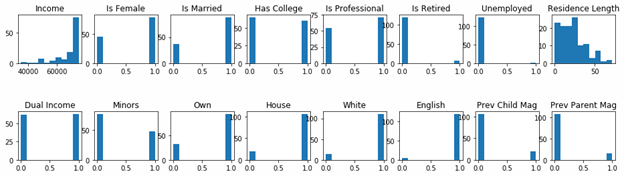
Ein notwendiger Schritt im maschinellen Lernen ist das Plotten, um zu sehen, ob das deine Hypothese stützt, dass die Daten korreliert sind. ETs trennen die Daten in Käufer und Nicht-Käufer und zeichnen die Merkmale in einem Histogramm auf. Wir stapeln ein Histogramm übereinander, sodass alle passen.
Käufer
Wir glauben natürlich, dass Menschen mit einem bestimmten Einkommen, Bildungsniveau, aktuellem oder vorherigem Hausbesitz usw. vorhersagen werden, ob sie kaufen werden oder nicht. df ist ein neuer Dataframe mit allen Spalten des ursprünglichen Data Frame data.columns. Wir erstellen diesen und wählen dann Personen aus, die gekauft haben, mit dem Operator df.loc[(df. Buy == 1)]. df.loc wählt Spalten basierend auf einem Zeilenwert aus. fig.ax = plt.subplots(2,8,figsize=(16, 4) ) bedeutet, eine Abbildung aus zwei Zeilen mit 8 Diagrammen zu erstellen. Jedes Diagramm wird dann von ax[Zeile,Spalte] referenziert. fig.subplots_adjust(hspace=1, wspace=0,2) gibt uns einen horizontalen Abstand zwischen und Breite an. Buyers.columns[2:] bedeutet, die dritte Spalte zur letzten im Dataframe zu bringen. Wir müssen keine Historie der Beobachtungsnummer, Buy-or-Not- und Income-Spalten aufzeichnen, da diese sich nicht als Histogramm aufzeichnen würden.
    df = pd.DataFrame(data, columns= np.array(data.columns))

buyers = df.loc[(df.Buy == 1)]

import matplotlib.pyplot as plt


fig, ax = plt.subplots(2,8,figsize=(16, 4) )

i = 0
j = 0

for c in buyers.columns[2:]:
    ax[j,i].hist(buyers[c])
    ax[j,i].set_title(c)
    i = i + 1
    if i == 8:
        j = 1
        i = 0

fig.subplots_adjust(hspace=1, wspace=0.2)
plt.show()
Wie Sie sehen, sind Menschen mit höherem Einkommen, Berufstätige, haben Jobs, Doppeleinkommen und Besitzer ihres Hauses am ehesten gekauft.
Nichtkäufer
Jetzt machen wir das Gegenteil und wählen Leute heraus, die nichts gekauft haben.
    df = pd.DataFrame(data, columns = data.columns )

notbuyers = df.loc[(df.Buy == 0)]

import matplotlib.pyplot as plt


fig, ax = plt.subplots(2,8,figsize=(16, 4) )

i = 0
j = 0

for c in np.array(data.columns)[2:]:
    ax[j,i].hist(notbuyers[c])
    ax[j,i].set_title(c)
    i = i + 1
    if i == 8:
        j = 1
        i = 0

fig.subplots_adjust(hspace=1, wspace=0.2)
plt.show()
Vergleich von Histogrammen
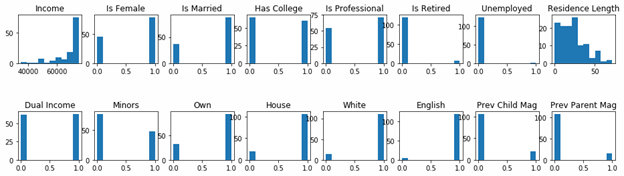
Um die Unterschiede zwischen Käufer- und Nicht-Käufern leicht zu erkennen, haben wir beide unten unten aufgeführten Diagramme zusammen gezeigt.
Käufer-Histogramm
Nicht-Käufer-Histogramm

ML mit TensorFlow & Keras Guide
- TensorFlow vs. PyTorch: Die Wahl Ihres ML-Frameworks
- Einführung in TensorFlow und logistische Regression
- Verwendung von TensorFlow zur Erstellung eines neuronalen Netzwerks (mit Beispielen)
- Verwendung des TensorFlow-Neuralnetzwerks für maschinelle Lernvorhersagen mit TripAdvisor-Daten
- Wie die Keras-Maschinensprachen-API TensorFlow erleichtert
- Wie man Keras verwendet, um Klassifikationsprobleme mit einem neuronalen Netzwerk zu lösen
- Deep Learning Schritt-für-Schritt-Neuralnetz-Tutorial mit Keras
- Google Cloud TPUs für ML-Beschleunigung
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.