




Auf einen Blick: Google Cloud TPUs verbessern das maschinelle Lernen, indem sie spezialisierte Tensor-Verarbeitungseinheiten für effiziente Tensor-Operationen in TensorFlow nutzen. Zum Preis von 4,50 US-Dollar pro Stunde bieten sie ein einzigartiges Kommandozeilen-Tool für die Bereitstellung und erleichtern die Skalierung über mehrere Rechner mit optimierter ASIC-Hardware.
- TPUs nutzen ASIC-Hardware zur Leistungssteigerung.
- Sie unterstützen nahtlose Skalierung über verschiedene Maschinen hinweg.
Wir haben bereits beschrieben , wie maschinelle Lernframeworks NVIDIA-GPUs (grafische Verarbeitungseinheiten) nutzen, um das maschinelle Lernen zu beschleunigen. Jetzt nimmt Google diese Idee und nutzt sie, um maschinelles Lernen mit ihrer eigenen ASIC-Hardware, genannt TPUs, Tensor Processing Units, zu beschleunigen. Was Google wirklich getan hat, ist, Technologie, die von NVIDIA (GPUs) erfunden wurde, in die Cloud zu bringen.
Ein Tensor ist eine n-dimensionale Matrix. Dies ist die grundlegende Funktionseinheit von TensorFlow, dem Open-Source-Machine-Learning-Framework, das von Google Brain gestartet wurde.
Ein Tensor ist analog zu einem Numpy-Array und verwendet tatsächlich Numpy. Laut deren Dokumentation ist es: "NumPy ist das grundlegende Paket für wissenschaftliches Rechnen mit Python. Es enthält unter anderem ein leistungsstarkes n-dimensionales Array-Objekt ... "
Arrays sind die grundlegenden Datenstrukturen, die von Machine-Learning-Algorithmen verwendet werden. Das Multiplizieren und Nehmen von Slices aus Arrays erfordert viele CPU-Taktzyklen und Speicher. Deshalb wurde Numpy geschrieben, um das Schreiben von Code dafür zu erleichtern. GPUs machen diese Operationen jetzt schneller.
[Helix-Video]
Insbesondere umfasst die Mathematik für die Ausführung von ML das Addieren und Multiplizieren dieser Objekte:
GPUs wurden ursprünglich gebaut, um die intensiven mathematischen Berechnungen zu entlasten, die nötig sind, um Grafiken auf einem Bildschirm zu drehen und anderweitig grafische Operationen zu beschleunigen, wie zum Beispiel das Malen von Bildschirmen in Spielanwendungen. Das Ziel war, die CPU nicht zu überlasten. Dann schrieb NVIDIA das CUDA SDK , das es Programmierern, die Dinge wie Tensorflow schreiben, ermöglicht, GPUs für jegliche Art von skalaren, vektor- oder Matrixaddion oder -multiplikation zu verwenden.
Eine CPU hat 1 bis 8 Kerne oder mehr. Eine GPU hat Hunderte. GPU und TPU sind dieselbe Technologie. Der einzige Unterschied ist, dass sie jetzt als Cloud-Dienst mit proprietären GPU-Chips verkauft werden, die sie sonst niemandem verkaufen.
Hardware
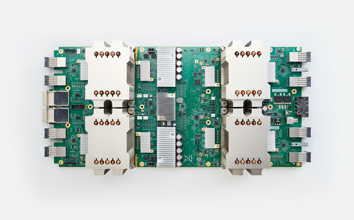
Googles Ansatz zur Bereitstellung einer TPU unterscheidet sich von Amazons. Bei Amazon wählt man eine GPU-fähige Vorlage und startet damit eine virtuelle Maschine. Diese Vorlagen beginnen alle mit den Buchstaben P3 und sind hier aufgeführt.
Bei Google nutzt du deren Kommandozeilen-Tool cptu , um Maschinen TPUs bereitzustellen. (Und du kannst auch weiterhin NVIDIA-GPUs verwenden.)
Laut Googles Preisangaben kostet jede TPU 4,50 US-Dollar. Anscheinend verlangen sie für verschiedene TPU-Modelle keine unterschiedlichen Tarife, obwohl sie auf ihrer Website drei Modelle anzeigen. Das wirkt verwirrend, da TPUs unterschiedliche Speichergrößen und Taktraten haben. Eines sollte also teurer sein als das andere.
Die TPU-Arbeitslast wird auf den sogenannten TPU Cloud Server verteilt, wie unten gezeigt.
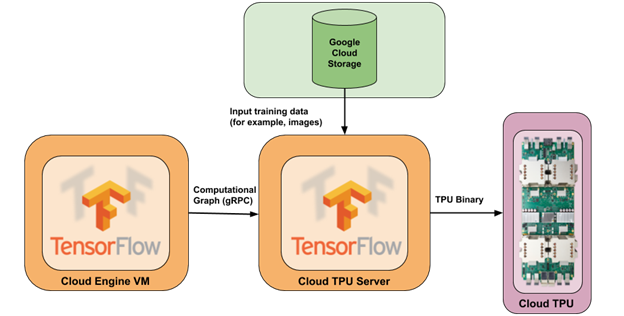
Laut ihren Architekturdokumenten sind ihre TPUs über eine PCI-Schnittstelle mit ihren Cloud-Rechnern verbunden. Das ist genauso wie NVIDIA Gamern erlaubte, grafische Erweiterungskarten hinzuzufügen, um die Leistung der Grafik am Computer zu steigern. Es handelt sich also nicht nur um Onboard-Chips, sondern um Erweiterungskarten.
Google sagt: "Jeder Chip besteht aus zwei Rechenkernen, die Tensorkerne genannt werden. Ein Tensorkern besteht aus skalaren, vektor- und Matrixeinheiten (MXU). Zusätzlich sind 16 GB On-Chip-Speicher (HBM) mit jedem Tensorkern verbunden."
Software
Ein Schätzer ist die tf.estimator.Estimator-Klasse . Diese sind die Implementierung von neuronalen Netzen, linearer Regression und anderen Objekten mit Python-Code, die die Erstellung solcher Objekte einfacher machen, da sie Numpy, Pandas und andere Python-Datenstrukturen und -Utilities nutzen.
Jetzt sagt Google, dass sie einen TPU-Estimator haben. Man kann die GPU-fähige Version von Tensorflow nicht herunterladen und nutzen, da sie sich vom normalen TensorFlow dadurch unterscheidet, dass das CUDA SDK für den Teil des Codes, der in C und C++ geschrieben ist, verwendet wird. Es gibt keine separate, TPU-fähige Version von TensorFlow. Und im Gegensatz zur GPU scheint es keine Möglichkeit zu geben, dem Code explizit zu sagen, dass er das TPU-Gerät verwenden soll, wie in diesem Codeausschnitt, der zwei Matrizen mit GPU-Gerät /device:GPU:n multipliziert. (Um die CPU zu verwenden, schreibt man /device:CPU:n, wobei n jede der n CPUs auf dem Computer sein kann.)
    with tf.device('/device:GPU:0'):
   c = tf.matmul(x, y)
Skalierungsvorteil?
Ein Vorteil des TPU-Designs ist, dass man Operationen auf verschiedenen Rechnern mit ihren TPU-Servern skalieren kann. Der Nutzer muss dafür natürlich keinen Code schreiben. Dieser Forscher hat noch nicht untersucht, wie das mit GPUs geht. Mit anderen Worten: Was macht man, wenn die Berechnung keinen Speicher mehr hat? Man kann PCI-Erweiterungskarten '/device:GPU:1, 2, ..., n hinzufügen oder im Grunde dasselbe tun, indem man Amazon für eine größere Vorlage bezahlt. Aber wie implementiert man etwas wie ein Mesos-Äquivalent, das es ermöglicht, über einen Servercluster zu skalieren, ohne Geräte und Servernamen fest programmieren zu müssen? Wir werden uns das ansehen und Ihnen zurückschreiben.
ML mit TensorFlow & Keras Guide
- TensorFlow vs. PyTorch: Die Wahl Ihres ML-Frameworks
- Einführung in TensorFlow und logistische Regression
- Verwendung von TensorFlow zur Erstellung eines neuronalen Netzwerks (mit Beispielen)
- Verwendung des TensorFlow-Neuralnetzwerks für maschinelle Lernvorhersagen mit TripAdvisor-Daten
- Wie die Keras-Maschinensprachen-API TensorFlow erleichtert
- Wie man Keras verwendet, um Klassifikationsprobleme mit einem neuronalen Netzwerk zu lösen
- Deep Learning Schritt-für-Schritt-Neuralnetz-Tutorial mit Keras
- Google Cloud TPUs für ML-Beschleunigung
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.