




Auf einen Blick: Dark Data, die unstrukturierte und ungenutzte Informationen umfassen, können über 90 % der Gesamtdaten in Organisationen ausmachen und Risiken wie Sicherheitslücken und Compliance-Herausforderungen darstellen. Ein effektives Management von Dark Data kann die operative Effizienz steigern, Kosten senken und wertvolle Erkenntnisse gewinnen.
- Dark Data umfasst Logdateien, Geolokalisierungsdaten und Kundeninteraktionen.
- Das Management von Dark-Daten kann die operative Effizienz verbessern und Kosten senken.
Dark Data und unstrukturierte Daten sind ungefähr dasselbe. Der Unterschied liegt darin , an wen sich der Begriff richtet. Unstrukturierte Daten sind meist ein Begriff, der sich an Ingenieure richtet. Es bezieht sich auf die strukturellen Eigenschaften der Daten und signalisiert dem Ingenieur, wie er die Daten verfeinern muss, um sie überhaupt nutzen zu können.
Unstrukturierte Daten sind unverfeinerte Daten, die mehr Arbeit erfordern, um nutzbar zu sein; strukturierte Daten sind bereits verfeinerte Daten, bei denen der Zweck der Daten bereits bestimmt ist. Unstrukturierte Daten sind das Yin zum Yang strukturierter Daten, aber meistens stammen unstrukturierte Daten aus einer ingenieursorientierten Perspektive.
Was sind dunkle Daten?
Dunkle Daten hingegen entstehen aus der nutzerzentrierten Perspektive. Während strukturierte Daten die strukturellen Eigenschaften der Daten bezeichnen, beziehen sich Dunkle Daten auf die sichtbaren Eigenschaften der Daten. Es gibt Daten, die der Nutzer sehen kann, wie Instagram-Fotos, Profilnamen, Hashtags, aber dann gibt es auch Daten, die der Nutzer nicht sehen kann. Die dunklen Daten.
Auf einer Social-Media-Plattform wie Instagram wären die Dark-Daten:
- Wie viele Login-Instanzen hat der Nutzer?
- Konzentriert sich ihre Nutzeraktivität auf bestimmte Tageszeiten?
- Wie viele Leute haben den Beitrag geliked, die große Netzwerke von Nutzern haben? (Um den Einfluss eines Nutzers zu messen.)
- Von wo wurde das Foto aufgenommen?
- Wo war die Person, als das Foto gepostet wurde?
Menschen können von so vielen Daten überfordert sein. Die übliche Designpraxis lautet Keep It Simple Stupid (KISS) und betrachtet Weißraum als zentrale Tugend. Instagram hat sogar die Menge an Daten reduziert , indem es die Anzahl der Likes, die ein Foto bekommt, von sehr spezifischen 134.392 auf einfach "Tausende" verallgemeinert hat.
Wenn die Nutzer die Ingenieure sind, beziehen sich Dark Data auf unstrukturierte Daten, die nicht analysiert werden. Es sind die Daten, die über verschiedene Netzwerkprozesse auf Servern und in Data Lakes gespeichert werden und letztlich die Verjährungsfrist der Branche erfüllen oder behalten werden, weil die Datenspeicherung so günstig sein kann.
Beispiele für dunkle Daten
Die Arten von dunklen Daten, die existieren, sind branchenspezifisch. Hintergrundwetterdaten können in einer laufenden App gesammelt werden, und der Browserverlauf kann in einer Einkaufs-App erfasst werden.
Im Grunde kann alles, was über das Internet gesendet wird, Dark Data erzeugen und diese erzeugen. Pakete werden von Punkt A nach Punkt B verschickt. Während diese Pakete verschlüsselt sein können und Einkäufer Schwierigkeiten haben zu sehen, was sich im Paket befindet, gibt es im Prozess noch andere bekannte Entitäten.
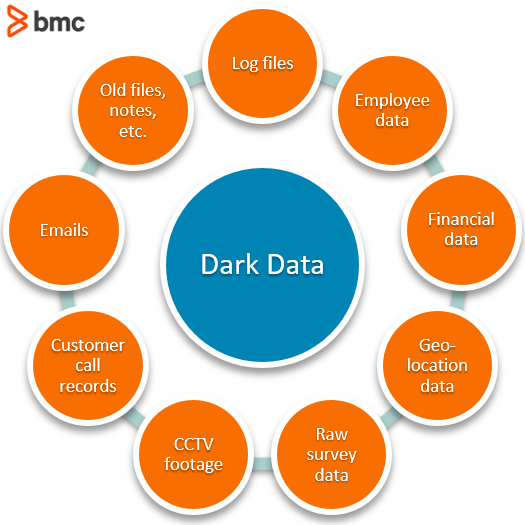
Arten von Dunkeldaten umfassen:
- Logdateien (Server, Systeme, Architektur usw.)
- Frühere Mitarbeiterdaten
- Finanzberichte
- Geolokalisierungsdaten
- Rohvermessungsdaten
- Überwachungsvideos
- Kundenanrufaufzeichnungen
- E-Mail-Korrespondenz
- Notizen, Präsentationen oder alte Dokumente
Wie viel Daten sind Dark Data?
Damit Softwaredienste funktionieren, müssen einige Daten gesammelt werden. Eine IP-Adresse muss bekannt sein, um Daten von irgendwo anders im Netzwerk zu beziehen und an einen Nutzer an einen anderen Ort im Netzwerk zurückzugeben. Künstliche Intelligenz-gestützte Dienste zeigen, dass je mehr Daten ein Unternehmen über einen Nutzer hat, desto besser der Dienst bieten kann.
Das IDC schätzt , dass 90 % der Daten unstrukturierte Daten sind. KI hilft dabei, diese unstrukturierten Daten stärker zu nutzen, was die Zahlen verringern sollte, aber es ist viel einfacher, unstrukturierte Daten zu sammeln, als Machine-Learning-Modelle zu entwickeln, die tatsächlich etwas damit tun, dass dieser Prozentsatz wahrscheinlich stark steigen wird. In nur wenigen Jahren könnten Dark Data 95–97 % des Gesamtanteils der Daten ausmachen. Wenn sich der Trend fortsetzt, könnte Dark Data vernünftigerweise 99 %+ aller Daten ausmachen.
Die Zahl ist weder gut noch schlecht. Dass 99,9999 % aller Daten weltweit Dark Data sind, bedeutet wenig. Es bedeutet nur, dass viele ungenutzte Daten liegen. Wenn überhaupt, sollte diese Zahl signalisieren, dass es eine großartige Chance geben könnte, Daten in etwas umzuwandeln, das sonst niemand hat.
Was sind die Risiken von Dark Data?
Das Sammeln und Speichern großer Datenmengen, die Sie nicht benötigen und nicht verwenden, ist nicht harmlos. Dark Data setzt Ihr Unternehmen Risiken und Kosten aus.
- Risiken der Datensicherheit: Da Dark Data nicht verwendet wird, kann die Mentalität "Aus den Augen und aus dem Sinn" übernehmen. Viel zu oft wird wenig darüber nachgedacht, sie zu speichern und zu handhaben. Dark Data können sensible Informationen enthalten, die durch diese laxe Datensicherheit gefährdet sind.
- Compliance- und regulatorische Risiken: Das Sammeln von Daten, die Sie nicht benötigen, insbesondere wenn sie persönliche oder identifizierbare Informationen enthalten, und diese nicht unter angemessenen Schutz stellen, kann zu Nichteinhaltung von Datenschutzbestimmungen wie DSGVO oder CCPA führen.
- Betriebskosten: Das Sammeln, Speichern und Verwalten von Daten ist nicht billig. Berücksichtigen Sie die Auswirkungen auf Ihre IT-Infrastruktur. Was Dark Data betrifft, erhalten Sie keinen Wert, der die Kosten ausgleicht.
- Verpasste Chancen: Dunkle Daten können wertvolle Erkenntnisse enthalten. Wenn Sie sie nie analysieren, könnten Sie die Chance verpassen, Trends aufzudecken, die Effizienz zu steigern oder Wege zu finden, zusätzliche Einnahmen zu generieren.
Wie man mit dunklen Daten umgeht
Privatsphäre mit dunklen Daten
Die Menschen hinterlassen ihren technologischen Fußabdruck mit Daten. Das ist in Ordnung, wenn es den Menschen egal ist, wenn andere wissen, wohin sie gegangen sind, aber manchmal gibt es auch andere Dinge – medizinische Anfragen, Google-Suchen, weniger angenehme Seiten und sogar Informationen, die man vor einem Partner oder Verwandten verbergen muss –, die Individuen nicht wollen, dass andere sehen.
Wenn es um Daten geht, ist Sicherheit sehr herausfordernd.
Herausforderung 1: Anonyme Daten
Oft denken viele, der erste Schritt zur Sicherung der Daten sei die Anonymisierung der Daten. Das bedeutet, dass alle Datenpunkte existieren können, aber sie entfernen alle Kontonummern, Namen, E-Mail-Adressen usw. aus den Daten der Person, sodass sie nicht direkt identifiziert werden kann. Diese Methode funktionierte in der Grundschule, wenn ein Name von einer Aufgabe entfernt wurde, die jemand abgegeben hatte, und sie konnte für jemanden wie Frank Abagnale funktionieren, der neue Namen auf Schecks und Diplome setzte, um als Linienpilot, Arzt und Anwalt durchs Land zu zeigen.
Aber Daten funktionieren in der technologischen Welt anders. Jeder Datensatz ist ein Identifikator. Fünf Datenpunkte, die mit einer Person verknüpft sind, unabhängig vom angegebenen Namen, sind ein Identifikator. Wenn bekannt ist, dass jemand morgens aufwacht, spazieren geht, niest, gähnt, mit einem Stein tritt und wieder einschläft, dann ist das der Eindruck einer einzigen Identität, die auf die Welt gestempelt ist.
Herausforderung 2: Datenschnittstellen
Es gibt so viele Daten, dass der Name einer Person unter einem anderen Datensatz existieren kann. Wenn sich diese Datensätze dann mit überschneidenden Datenpunkten überschneiden, werden die beiden Sätze abgeglichen, und es ist möglich, den anonymisierten Daten eine Identität zuzuordnen. Ein Venn-Diagramm verschiedener Datenquellen zu erstellen und herauszufinden, welche sich überschneiden, ist eine einfache Option, und Statistik lädt zu komplexeren Methoden zur Deanonymisierung von Daten ein.
Es gibt die Geschichte eines Rechtsfalls, in dem eine alte Dame von einem Auto angefahren wurde und das Auto davonfuhr. Die Frau konnte sagen, das Auto sei gelb (sie wusste die Marke nicht), und der Fahrer war ein brauner Mann mit dunklen Haaren. Das ist nicht viel, aber einige weitere dunkle Datenpunkte fügen die Tageszeit des Unfalls und den Unfallort hinzu. Aus diesen vier Datenpunkten konnten die Ermittler in einer Stadt mit etwa 120.000 Einwohnern ihre Suche von scheinbar unmöglichen Quoten auf nur wenige Verdächtige eingrenzen, die die Frau hätten treffen können.
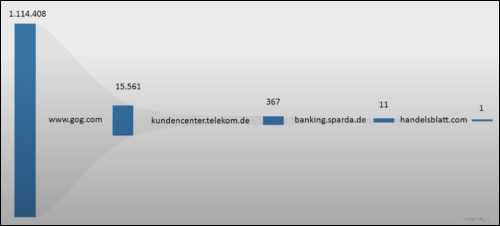
Ähnlich präsentierte das 7scients-Forschungsteam aus der Technologiebranche einen ähnlichen Fall auf Defcon (siehe unten für den Videoclip). Sie kauften anonyme Browsing-Daten, die leicht zu erwerben sind, und zeigten, dass sie den Nutzer anhand nur von fünf Datenpunkten identifizieren konnten.
Open-Source-Datenschutz
Open Mined ist eine Open-Source-Forschungsgruppe , die daran arbeitet, Daten datenschutzfähiger zu gestalten. In einer Welt mit immer mehr Dark Data profitiert ihre Arbeit der Allgemeinbevölkerung, um Daten anonymer zu machen und sicherzustellen, dass Identitäten auch bei der zunehmenden verfügbaren Datenmenge privat gemacht werden.
Konkret werden maschinelle Lernmodelle auf Daten trainiert. Maschinelle Lernmodelle können sowohl einen hohen Wert bieten als auch mit sensiblen Daten arbeiten. Während alle Daten als sensibel gelten und gleich behandelt werden können, zählen rechtliche Bedingungen medizinische Unterlagen zu den sensibelsten.
Daher ist das Training von Machine-Learning-Modellen an der medizinischen Vorgeschichte von Menschen sehr schwierig, da die Branche die Unterlagen in der Vergangenheit so sensibel behandelt hat. Herausforderungen sind: zu wenige Daten, die Daten, die aus Sicherheitsgründen auf verschiedene Orte isoliert werden, und viele zusätzliche Hürden, um die von Regulierungsbehörden festgelegten "Best Safety Practices" zu erfüllen.
Das Ziel von Open Mined ist zweigeteilt: ein Framework zu schaffen, in dem Menschen für ihre Daten bezahlt werden, und Daten wirklich anonymisiert zu werden, wenn sie durch ML-Modelle übermittelt werden. Zu diesem Zweck bietet die Open-Source-Gruppe derzeit drei große Softwarelösungen an:
- Verschlüsseltes maschinelles Lernen als Service
- Datenschutzbewahrende Datenwissenschaftsplattform
- Föderiertes Lernen
Sicherheit ist nicht Privatsphäre
Es gibt viele dunkle Daten, und es wird wahrscheinlich noch mehr geben. Sicherheitspraktiken bewahren zwar nicht die Privatsphäre bei allen Dark-Data-Punkten, aber Forschungsgruppen verbessern erfolgreich die Datenlandschaft und setzen sich dafür ein, dass Menschen für die von ihnen erstellten Daten bezahlt werden.
Verwaltung von dunklen Daten
Angesichts der Probleme und Chancen mit verwendeten und möglicherweise vergessenen Dark Data ist es sinnvoll, einen formalen Prozess zur Verwaltung zu entwickeln. Sie können Haftungen und Risiken eliminieren und gleichzeitig Vorteile freischalten.
Das Management von Dark Data kann Erkenntnisse liefern, die Ihre Abläufe verbessern, das Kundenerlebnis und die Loyalität stärken und zu Innovationen und neuen Einnahmequellen führen.
Das Management von Dark Data kann ebenfalls Kosten und Risiken senken. Sie können die Auswirkungen auf Ihre IT-Infrastruktur sowie die Kosten für deren Sammlung und Speicherung verringern. Sie können auch Datenschutz- und Datenschutz-Compliance-Probleme mindern.
Einige bewährte Verfahren für das Management von dunklen Daten sind:
- Beginnen wir mit einem Datenaudit , das das Volumen der ungenutzten Daten in Ihren Systemen bewertet.
- Implementierung eines Datenklassifikationssystems , das wertvolle, sensible, veraltete und nicht benötigte Daten identifiziert.
- Schaffung eines Systems zur Löschung und Aufbewahrung sowie zur Spezifikation des ordnungsgemäßen Umgangs mit gespeicherten Daten.
- Sicherheitsprotokolle wie Verschlüsselung, Zugriffskontrolle und Datenlebenszyklusrichtlinien gelten sowohl für Dark Data als auch für Daten im regelmäßigen Gebrauch.
Erfahren Sie mehr über die Enterprise-BMC AMI-Lösung für Datenmanagement
Dark Analytics
Die Verarbeitung und Nutzung von Dark Data, um Erkenntnisse darin zu entdecken, und diese dann zu nutzen, um Entscheidungen zu treffen, ist der Kern der Dark-Data-Analyse. Die große Menge an unstrukturierten, unanalysierten und vergessenen Daten kann eine Goldgrube für Ihre Organisation sein.
Typische Dark-Daten umfassen Logdateien, Sensordaten, archivierte E-Mails, Interaktionen in sozialen Medien, Kundenaufzeichnungen, Serviceaufzeichnungen, Kundenfeedback und mehr. Sie können Muster finden, wie wiederkehrende Kundenbeschwerden, die auf ein Produktproblem hinweisen oder einen Trend aufdecken, der auf einen neuen Kundenbedarf oder einen Cybersicherheitsverstoß hinweist.
Die Analyse von dunklen Daten kann zu einem Wettbewerbsvorteil, einer Wachstumschance und zur Minderung eines bisher unsichtbaren Risikos führen, bevor es zu einem ernsthaften Problem wird.
Vorteile von Dark Analytics
Die Nutzung von Dark Analytics ist eine verborgene Superkraft für Ihre Organisation. Sie können Risiken mindern, Kosten senken, sich einen Wettbewerbsvorteil verschaffen und mit guter Dark-Data-Analyse schneller klügere Entscheidungen treffen. Hier sind einige wichtige Möglichkeiten, davon zu profitieren:
- Decken Hindernisse, Ineffizienzen und Verlangsamungen in Prozessen und Abläufen auf
- Finden Sie wiederkehrende Serviceprobleme
- Verbesserung der Ressourcenallokation und Trendanalyse
- Entdecken Sie Kundenprobleme, die Sie mit Produktinnovationen lösen können
- Verfolgen Sie die Kundenstimmung in den sozialen Medien gegenüber Ihrer Marke und Ihren Wettbewerbern
- Identifizieren Sie Verhaltensmuster, die zu individuellen Interaktionen mit Nutzern führen können
- Verfeinere Markenbotschaften und Markeninteraktionen
- Erfahren Sie mehr über Möglichkeiten zum Upsell, Cross-Selling oder zur erneuten Kontaktaufnahme mit Kunden
- Licht auf Unknown Sicherheitsrisiken werfen
- Erfassung von Daten zur Verbesserung der Einhaltung der Vorschriften
Zusätzliche Ressourcen
Mehr zu diesem Thema finden Sie im BMC Machine Learning & Big Data Blog oder stöbern Sie in diesen Artikeln:
- Daten sind die neue Elektrizität
- Was ist eine Datenpipeline?
- Datenmanagement vs. Data Governance: Hauptunterschiede
- Wie man eine Machine-Learning-Pipeline erstellt
- Wie man maschinelles Lernen auf die Cybersicherheit anwendet
- Die Rolle des maschinellen Lernens in der Netzwerksicherheit von Rechenzentren

Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.