




Auf einen Blick: Gängige ElasticSearch-Curl-Befehle vereinfachen die Datenverwaltung wie Indexierung, Abfrage und Aktualisierung von Dokumenten. Diese Befehle ermöglichen es den Nutzern, effizient mit der ElasticSearch RESTful API zu interagieren.
- ElasticSearch unterstützt dynamische Feldkartierung und ermöglicht so flexible Datenexploration.
- Befehle umfassen das Erstellen, Löschen und Auflisten von Indizes sowie das Abfragen von Dokumenten mit URL-Parametern oder JSON.
Hier zeigen wir einige der häufigsten ElasticSearch-Curl-Befehle. ElasticSearch ist manchmal kompliziert. Hier machen wir es einfach.
Hintergrundinformationen
Was ist "Curl"?
Das Akronym cURL, heute häufig als curl geschrieben, steht für Client URL. Es ist ein Kommandozeilentool, das es ermöglicht, Daten zu oder von Webservern, APIs und anderen vernetzten Geräten zu oder von ihnen zu übertragen. Entwickler finden es als unverzichtbares Werkzeug für Webentwicklungsprojekte, für Automatisierungs- und Skriptarbeiten sowie für die Verwaltung von IT-Systemen.
Verwendung von ElasticSearch-Curl-Befehlen
Für großflächige Datenindexierung und Abfragen ist curl ElasticSearch eine leistungsstarke verteilte Such- und Analyse-Engine. Sie können direkt auf die ElasticSearch RESTful API zugreifen, um Indexe zu erstellen, Dokumente zu durchsuchen, Daten zu aktualisieren und Cluster-Computing zu verwalten. Hier ist ein Curl-Spickzettel für ElasticSearch-Befehle:
ElasticSearch-Indexbefehle mit Curl
Ein ElasticSearch-Index ist eine Reihe von Zeichen, die Dokumente identifizieren und auf sie verweisen, die eine Sammlung von Feldern sind, die alle Daten enthalten. Was ihn elastisch im Gegensatz zu einem festen Schema macht, ist, dass man nichts im Voraus kartieren muss. Er ermöglicht es Ihnen, Ihre Daten zu erkunden, ohne dass Sie Ihre Felder definieren müssen. Er erkennt und kartiert Ihre Felder automatisch dynamisch.
Index erstellen in ElasticSearch
Der untenstehende Befehl ElasticSearch erstellt einen Index namens index_name mit Standardeinstellungen.
curl -X PUT 'http://localhost:9200/index_name'
Einen ElasticSearch-Index löschen
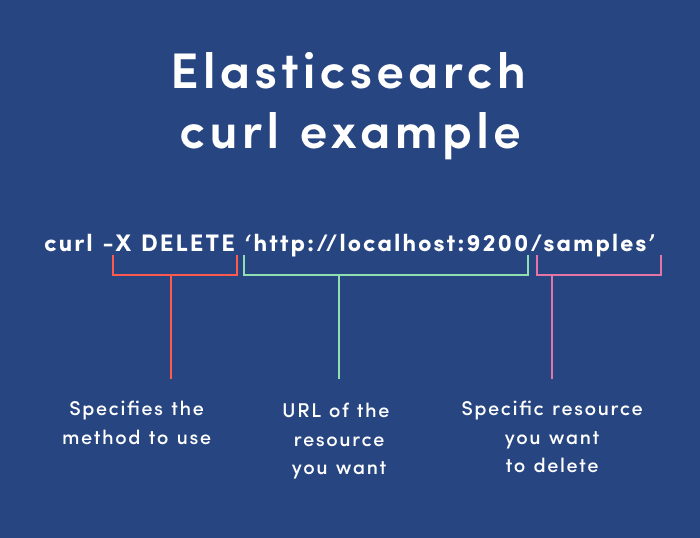
Um einen ElasticSearch-Index (in diesem Fall benannte Samples) zu löschen, verwenden Sie folgenden Curl-Befehl:
curl -X DELETE 'http://localhost:9200/samples'
Liste alle Indizes auf
Um alle Indizes in ElasticSearch aufzulisten, verwenden Sie:
curl -X GET 'http://localhost:9200/_cat/indices?v'
Liste alle Dokumente im Index auf
Unten befindet sich eine Curl-Abfrage von ElasticSearch, um alle Dokumente aus einem Index zurückzugeben:
curl -X GET 'http://localhost:9200/sample/_search'
Listenindex-Mapping
Alle ElasticSearch-Felder sind Indexe. Dieser ElasticSearch-Curl-Befehl listet alle Felder und ihre Typen in einem Index auf.
curl -X GET http://localhost:9200/samples
Sichern Sie einen ElasticSearch-Index
    curl -XPOST --header 'Content-Type: application/json' http://localhost:9200/_reindex -d '{
"source": {
"index": "samples"
},
"dest": {
"index": "samples_backup"
}
}'
Wie man ElasticSearch mit Curl abfragt
Wenn Sie ElasticSearch mit Curl abfragen, können Sie URL-Parameter verwenden oder eine HTTP-GET-Anfrage mit einem JSON-Körper senden, der die Abfrage enthält. Hier sind Beispiele für beide Ansätze:
ElasticSearch Curl-Abfrage mit URL-Parametern
Unten ist ein einfacher Curl zu erhalten, um ein Beispiel für ElasticSearch-Curl-Befehle zu erhalten, das für grundlegende Abfragen und Operationen nützlich ist. Hier verwenden wir das Lucene-Abfrageformat, um q=school:Harvard zu schreiben.
curl -X GET http://localhost:9200/samples/_search?q=school:Harvard
Abfrage mit JSON, auch bekannt als ElasticSearch Abfrage DSL,
Man kann mit Parametern auf der URL Abfragen verwenden. Aber man kann JSON auch verwenden, um ElasticSearch mit Curl abzufragen, wie im nächsten Beispiel gezeigt. JSON wäre leichter zu lesen und zu debuggen, wenn man eine komplexe Abfrage hat, als eine riesige String von URL-Parametern.
    curl -XGET --header 'Content-Type: application/json' http://localhost:9200/samples/_search -d '{
"query" : {
"match" : { "school": "Harvard" }
}
}'
ElasticSearch-Abfrage liefert nur bestimmte Felder zurück
Um beim Abfragen von ElasticSearch mit Curl nur bestimmte Felder zurückzugeben, fügen Sie diese in das _source-Array ein:
    GET filebeat-7.6.2-2020.05.05-000001/_search
{
"_source": ["suricata.eve.timestamp","source.geo.region_name","event.created"],
"query": {
"match" : { "source.geo.country_iso_code": "GR" }
}
}
ElasticSearch-Abfrage nach Datum
Wenn das Feld vom Typ "Datum" ist, können Sie Datumsrechnung verwenden, wie folgt:
    GET filebeat-7.6.2-2020.05.05-000001/_search
{
"query": {
"range" : {
"event.created": {
"gte" : "now-7d/d"
}
}
}
}
Curl Put ElasticSearch-Befehle
Daten hinzufügen
Der folgende Curl-Befehl fügt Daten zu einem ElasticSearch-Dokument hinzu:
    curl -XPUT --header 'Content-Type: application/json' http://localhost:9200/samples/_doc/1 -d '{
"school" : "Harvard"
}'
Update Dokument
So fügt man Felder zu einem bestehenden ElasticSearch-Dokument hinzu. Zuerst erstellen wir ein neues Dokument, dann aktualisieren wir es.
    curl -XPUT --header 'Content-Type: application/json' http://localhost:9200/samples/_doc/2 -d '
{
"school": "Clemson"
}'
curl -XPOST --header 'Content-Type: application/json' http://localhost:9200/samples/_doc/2/_update -d '{
"doc" : {
"students": 50000}
}'
Weitere nützliche Beispiele für ElasticSearch-Curl-Befehle
Bulk-Load-Daten im JSON-Format
So laden Sie Daten im JSON-Format in einem ElasticSearch-Cluster in Bulk:
    export pwd="elastic:"
curl --user $pwd -H 'Content-Type: application/x-ndjson' -XPOST 'https://58571402f5464923883e7be42a037917.eu-central-1.aws.cloud.es.io:9243/0/_bulk?pretty' --data-binary @
Zeigen Sie die Gesundheit des ElasticSearch-Clusters
Der folgende Befehl curl xget ElasticSearch verwendet das JSON-Format, um die Gesundheit des ElasticSearch-Clusters zu überprüfen:
curl --user $pwd -H 'Content-Type: application/json' -XGET https://58571402f5464923883e7be42a037917.eu-central-1.aws.cloud.es.io:9243/_cluster/health?pretty
Aggregation und Eimeraggregation
Für einen nginx-Webserver erzeugt dieser ElasticSearch-Aggregationsbefehl Web-Trefferzahlen nach Nutzerstadt:
    curl -XGET --user $pwd --header 'Content-Type: application/json' https://58571402f5464923883e7be42a037917.eu-central-1.aws.cloud.es.io:9243/logstash/_search?pretty -d '{
"aggs": {
"cityName": {
"terms": {
"field": "geoip.city_name.keyword",
"size": 50
}
}
}
}
'
Dies erweitert das auf eine Produktantwort-Code-Anzahl nach Stadt in einem nginx-Webserver-Log:
    curl -XGET --user $pwd --header 'Content-Type: application/json' https://58571402f5464923883e7be42a037917.eu-central-1.aws.cloud.es.io:9243/logstash/_search?pretty -d '{
"aggs": {
"city": {
"terms": {
"field": "geoip.city_name.keyword"
},
"aggs": {
"responses": {
"terms": {
"field": "response"
}
}
}
},
"responses": {
"terms": {
"field": "response"
}
}
}
}'
Verwendung von ElasticSearch mit einfacher Authentifizierung
Wenn Sie die Sicherheit mit ElasticSearch aktiviert haben, müssen Sie für jeden Curl-Befehl Benutzer und Passwort wie unten gezeigt angeben:
curl -X GET 'http://localhost:9200/_cat/indices?v' -u elastic:(password)
Pretty print ElasticSearch
Fügen Sie ?pretty=true zu jeder Suche hinzu, um das JSON schön auszudrucken, so:
curl -X GET 'http://localhost:9200/(index)/_search'?pretty=true
ElasticSearch-Leitfaden
- ElasticSearch Tutorial für Anfänger: ElasticSearch Grundlagen
- Verwendung von Apache Hive mit ElasticSearch
- Verwendung von ElasticSearch mit Apache Spark
- Curl ElasticSearch Befehle Spickzettel
- Spark ElasticSearch Hadoop-Update und Upsert Beispiel und Erklärung
- Wie man Apache Spark-Daten mit Python in ElasticSearch schreibt
- ElasticSearch-Suchsyntax sowie boolesche und Aggregationssuchen
- ElasticSearch verschachtelte Abfragen: Wie man nach eingebetteten Dokumenten sucht
- ElasticSearch Joins: Has_Child, Has_parent Abfrage
- Wie man einen elastischen Cluster der Version 7 einrichtet
- Wie man Filebeat für nginx und ElasticSearch konfiguriert
- Beats und Logstash verwenden, um Logs an ElasticSearch zu senden
- Wie man eine CSV-Datei mit Logstash in ElasticSearch lädt
- ElasticSearch-Aggregationen erklärt
- Was ist der ELK-Stack?
- Logstash 101: Verwendung von Logstash in einer Datenverarbeitungspipeline
- Verwendung von Kibana zur Ausführung von Abfragen in ElasticSearch mit Lucene und Kibana Query Language
- ElasticSearch Maschinelles Lernen
- Wie man Elastic Enterprise Search installiert
- Wie man Elastic Enterprise Search mit GitHub verwendet
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.