




Auf einen Blick: ElasticSearch Machine Learning ist ein Add-on für unüberwachtes Lernen in der Zeitreihenanalyse, bei dem Anomalien ohne vorheriges Modelltraining erkannt werden. Es verbessert die Überwachung der Anwendungsleistung und die Cybersicherheit, indem es Datenmuster identifiziert, anstatt feste statistische Schwellenwerte zu verwenden.
- ElasticSearch ML kann eigenständig oder über Elastic Cloud installiert werden.
- Es verwendet verschiedene Algorithmen zur effektiven Anomalieerkennung in Zeitreihendaten.
Hier besprechen wir ElasticSearch Machine Learning. ML ist ein Add-on zu ElasticSearch, das Sie mit einer eigenständigen Installation kaufen oder als Teil des monatlichen Elastic Cloud-Abonnements bezahlen können.
ElasticSearch Maschinelles Lernen
Der Begriff maschinelles Lernen hat eine breite Bedeutung. Es ist ein generischer Begriff, der Laien übergeben wird, um die Diskussion der Einzelheiten der verschiedenen Modelle zu vermeiden.
Genauer gesagt bewirkt ElasticSearch ML die Zeitreihenanalyse unüberwachtes Lernens. Das bedeutet, es zieht Schlussfolgerungen aus einem Datensatz, anstatt ein Modell zu trainieren (also überwachtes Lernen), um Vorhersagen zu treffen, wie man es bei der Regressionsanalyse mit verschiedenen Techniken tun würde, einschließlich neuronaler Netze, kleinste Quadrate oder unterstützende Vektormaschinen.
Wie ist das nützlich?
Um den Wert der unüberwachten Lernzeitreihenanalyse zu erkennen, betrachten Sie den typischen Ansatz für Cybersicherheit oder Anwendungsleistungsüberwachung. Das heißt, die Daten folgen einer normalen (gaussschen) Verteilung und wählen dann einen Schwellenwert, den man beim Markieren von Ausreißern als signifikant betrachtet.
Das ist der bekannte Glockenkurven-Ansatz . Auch wenn man es nicht so sieht, ist es genau das, was man tut. Diese Kurve wird durch Begriffe beschrieben, die der Mathematikschüler an der Oberstufe kennen sollte: Mittelwert, Varianz und Standardabweichung. Aber das ist kein maschinelles Lernen.
Nicht besser als zu raten
Typischerweise markiert jemand, der Anwendungsüberwachung oder Cybersicherheit durchführt, ein Ereignis, wenn es an einem der beiden Enden der Kurve liegt, was die Wahrscheinlichkeit eines solchen Ereignisses niedrig ist. Das wird üblicherweise als ein Vielfaches von σ (Sigma) bezeichnet, wobei Sigma ein Vielfaches von Standardabweichungen ist und die Wahrscheinlichkeit, dass ein Ereignis dort liegt, sehr gering ist.
Man könnte diesen Ansatz auch mit Spott als Raten bezeichnen.
Der Schwellenwert ist fehlerhaft, da er zu Fehlalarmen führt. Das führt dazu, dass Analysten Zeit darauf verwenden, Ereignisse zu verfolgen, die statistisch nicht wirklich signifikant sind.
Zum Beispiel bedeutet es bei Cybersicherheit nicht, dass das Ereignis außerhalb der Grenzen ist, nur weil jemand Daten jetzt öfter an eine bestimmte IP-Adresse sendet als zuvor. Sie müssen die zyklische Natur der Ereignisse berücksichtigen und aktuelle Ereignisse im Lichte dessen betrachten, was vorher passiert ist. Es könnte sein, dass dies jeden Monat passiert und normal ist. Ein cleverer Algorithmus kann das zum Beispiel erreichen, indem er eine Kleinste-Quadrat-Methode anwendet und versucht, den Fehler (also den Unterschied zwischen Beobachteten und Erwarteten) gegen eine sich verschiebende Teilmenge von Daten zu minimieren. So macht ElasticSearch das. Und sie wenden mehrere Algorithmen an, nicht nur Kleinste-Quadrate.
Wie man ElasticSearch für maschinelles Lernen verwendet
Hier zeigen wir, wie man das Werkzeug benutzt. In einem weiteren Blogbeitrag werden wir einige der Logiken und Algorithmen dahinter erklären. Aber das Werkzeug soll es nicht notwendig machen, all das zu verstehen. Dennoch solltest du es tun, damit du dem vertrauen kannst, was es dir sagt.
Wir werden aus diesem Video von ElasticSearch zurückgreifen und es auf einzelne Schritte verlangsamen, um es leichter verständlich zu machen.
Für die Daten verwenden wir den New Yorker Taxi-Datensatz, den Sie hier bei Kaggle herunterladen können. Die Daten geben uns Abhol- und Abholzeiten sowie Orte von Taxis in New York City über einen Zeitraum von einigen Jahren an. Wir wollen sehen, wann der Verkehr zurückgeht oder auf eine Weise zunimmt, die eine Auffälligkeit ist, wie ein Taxistreik oder Schneesturm.
Es gibt einige Einschränkungen beim Laden dieser Daten im Kibana-ML-Bildschirm, was eine Funktion von ES ML ist. Man kann jeweils nur 100 MB Daten laden. Die Taxi-Daten sind viel größer als das. Sie enthalten einen Test - und Zugdatensatz . Da wir kein Modell mit unüberwachtem Lernen trainieren, wählen wir einfach eines davon aus. Da wir es auf 100 MB begrenzen müssen, teilen wir die 200-MB-Datendatei so auf und wählen einfach einen 90-MB-Datensatz aus.
    unzip train.zip
split -b 90000000 train.csv
Beachte auch, dass ElasticSearch beim Laden solcher Daten oft einfriert, es sei denn, du hast einen großen Cluster. Aber es lädt die Daten trotzdem. Sobald es so aussieht, als wäre das Laden abgeschlossen, also der Bildschirm wird nicht mehr aktualisiert, klicke einfach raus und gehe zum Indexmanagement, um zu sehen, wie viele Datensätze im neuen Index sind. Es sollten etwa 100.000 pro 90 MB Daten sein.
Laden Sie die Daten in die Machine-Learning-Bildschirme hoch
Öffne Kibana und klicke auf das Machine-Learning-Symbol . Du wirst dieses Symbol auch haben, wenn du keine Testversion oder bezahlte Lizenz hast. Was jedoch fehlen wird, sind Anomalie Detection, Job-Erstellung und andere Bildschirme. ElasticSearch führt dich also bei der Anmeldung für eine Testphase.
Anomalieerkennung
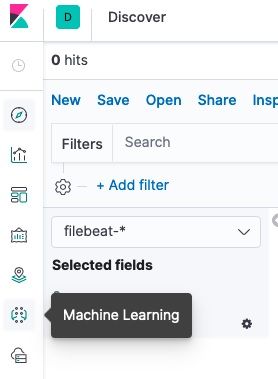
Im Data Visualizer wählst du eine Datei importieren und eine der Dateien importieren, die du von train.csv getrennt hast. Oder wenn du die Daten anders geladen hast, kannst du die Option "Select an Index Pattern" verwenden.
ElasticSearch zeigt dir die ersten 1.000 Zeilen an und macht dann schnelle Datensatzzählungen.
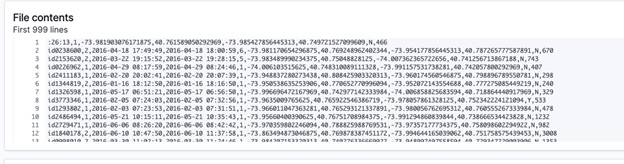
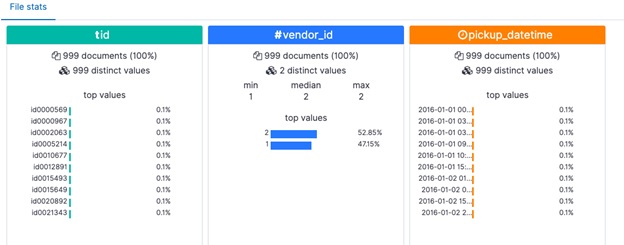
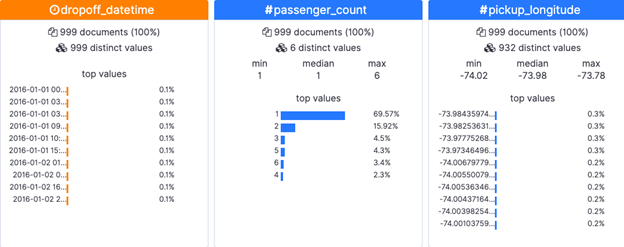
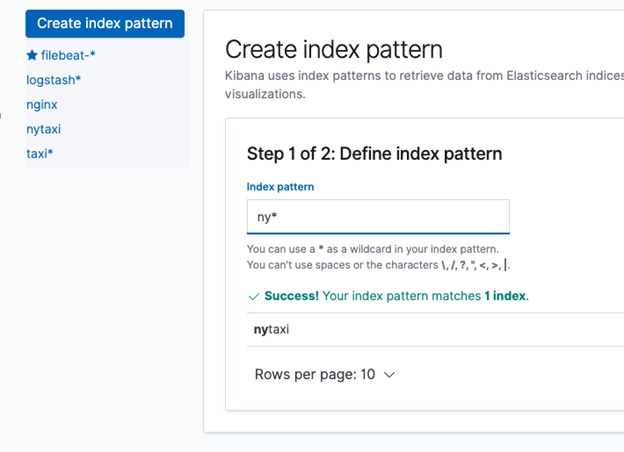
Dann klicke unten auf dem Bildschirm auf Importieren . Gib dem Index Pattern einen Namen wie ny*.
Jetzt kommen wir zum interessanten Teil. Wir wollen, dass ElasticSearch diese Zeitreihendaten betrachtet. Wählen Sie die Option Single Metrik.
Dann müssen wir einen Job erstellen. ElasticSearch führt im Hintergrund eine Aggregationsanfrage aus. Wir sagen ihm, dass passenger_count im Laufe der Zeit summiert werden soll. (Wenn das Dropdown-Menü nicht funktioniert, kopieren und fügen Sie einfach den Feldnamen ein.)
Wir nutzen diese Aggregation, um zu beobachten, wann es einen Rückgang oder Anstieg der Passagierzahlen gibt, der außerhalb des normalen Bereichs liegt, und das berücksichtigt den normalen Anstieg und Rückgang der Passagierzahl im Zeitverlauf.
Klicken Sie auf den Button "Vollständige Datenreichweite verwenden", damit alle verfügbaren Daten ausgewählt werden und nicht das manuell eingegebene Datumsintervall. Sie können die Eimer-Option auf 10 m ändern.
Dann füllt sich der Bildschirm so aus:
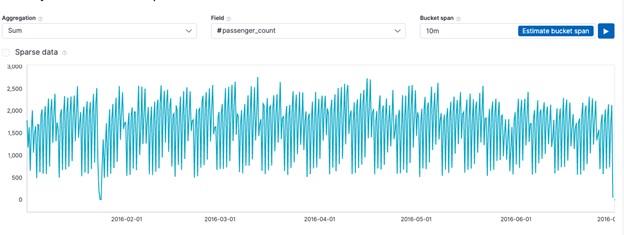
Dann klickt man auf Job erstellen. Es beginnt, seine Algorithmen auszuführen und aktualisiert das Display mit vertikalen farbigen Linien, sobald die Logik abgeschlossen ist.
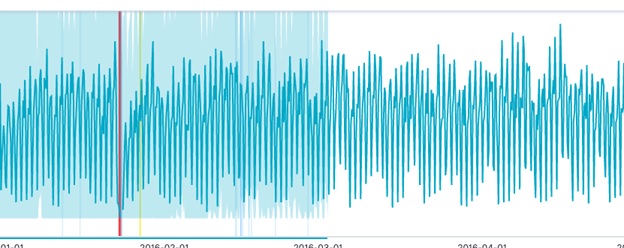
Sehen Sie sich die Anomalie-Erkennungsergebnisse an
Wenn es fertig ist, klicke auf Ergebnisse anzeigen.
Wir werden in einem anderen Beitrag genau erklären, welche Berechnungen es gemacht hat – schließlich sollte man einem ML-Modell nicht vertrauen, ohne ein gewisses Verständnis dafür zu haben, wie es zu seinen Schlussfolgerungen gekommen ist.
Aber man kann es sich so vorstellen. Taxifahrten gehen unter der Woche auf und ab im Vergleich zum Wochenende und während der Hauptverkehrszeit im Vergleich zu Nicht. Wenn man mit Verkaufsdaten arbeiten würde, würde man das als Trends oder Saisonalität bezeichnen. Wenn man also eine gaussische (Normalverteilung) darauf verwenden würde, wäre das falsch, da Mittelwert und Varianz über das gesamte Set einschließlich der Höhen- und Tiefpunkte liegen würden. Der verbesserte Algorithmus gleitet also weiter und erstellt mehrere Normalkurven (und andere Frequenzverteilungen) gegen Teilmengen der Daten, um dieses Auf- und Ab-Muster zu eliminieren.
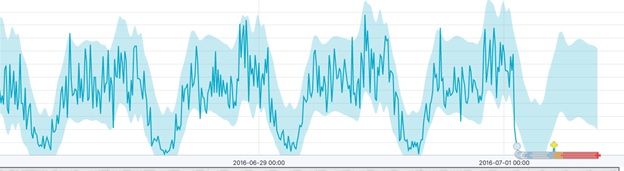
Dies liefert die folgenden Ergebnisse. Der hellblaue Bereich ist die verschiebende Wahrscheinlichkeitsverteilungsfunktion. Der rote Bereich ist der Ort, an dem man die Anomalie sehen kann, also den Punkt, an dem das Diagramm die Kurve verlassen hat. Es ist auch der Punkt, an dem uns die Daten ausgehen. Es hat das als Ausreißer markiert, indem es einen Anomaliewert berechnet hat, einen Punkt, den wir im nächsten Beitrag behandeln werden.
ElasticSearch-Leitfaden
- ElasticSearch Tutorial für Anfänger: ElasticSearch Grundlagen
- Verwendung von Apache Hive mit ElasticSearch
- Verwendung von ElasticSearch mit Apache Spark
- Curl ElasticSearch Befehle Spickzettel
- Spark ElasticSearch Hadoop-Update und Upsert Beispiel und Erklärung
- Wie man Apache Spark-Daten mit Python in ElasticSearch schreibt
- ElasticSearch-Suchsyntax sowie boolesche und Aggregationssuchen
- ElasticSearch verschachtelte Abfragen: Wie man nach eingebetteten Dokumenten sucht
- ElasticSearch Joins: Has_Child, Has_parent Abfrage
- Wie man einen elastischen Cluster der Version 7 einrichtet
- Wie man Filebeat für nginx und ElasticSearch konfiguriert
- Beats und Logstash verwenden, um Logs an ElasticSearch zu senden
- Wie man eine CSV-Datei mit Logstash in ElasticSearch lädt
- ElasticSearch-Aggregationen erklärt
- Was ist der ELK-Stack?
- Logstash 101: Verwendung von Logstash in einer Datenverarbeitungspipeline
- Verwendung von Kibana zur Ausführung von Abfragen in ElasticSearch mit Lucene und Kibana Query Language
- ElasticSearch Maschinelles Lernen
- Wie man Elastic Enterprise Search installiert
- Wie man Elastic Enterprise Search mit GitHub verwendet
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.