





Auf einen Blick: Die Nutzung von Kibana ermöglicht es Nutzern, Abfragen in ElasticSearch mit Lucene und Kibana Query Language (KQL) auszuführen. Der Leitfaden erklärt, wie man JSON-Abfragen eingibt, und hebt Unterschiede zwischen der KQL- und Lucene-Syntax hervor.
- JSON DSL-Abfragen können in Kibana verwendet werden.
- Kibana unterstützt sowohl KQL als auch Lucene, mit Unterschieden in der Schlüsselsyntax.
Wir haben ausführlich besprochen, wie man ElasticSearch mit CURL abfragt. Jetzt zeigen wir, wie das mit Kibana geht.
Sie können diesem Blogbeitrag folgen, um Ihren ES-Server mit einigen Daten zu füllen.
JSON-Abfragen (auch JSON DSL genannt) sind das, was wir mit Curl verwenden. Aber du kannst diese auch mit Kibana verwenden. Es funktioniert nicht mit Aggregations, verschachtelten und anderen Abfragen.
Bei der Verwendung von JSON besteht der Unterschied darin, dass man nur das Abfrageobjekt übergibt. Also für diese Curl-Abfrage:
{"query":{"match":{"geoip.country_name":"Luxembourg"}}}
Man würde nur diesen Teil in Kibana einfügen.
{"match":{"geoip.country_name":"Luxembourg"}}
Eingabe von Anfragen in Kibana
Im Discovery-Tab in Kibana fügen Sie den oben genannten Text ein, wobei Sie zunächst die Abfragesprache von KQL auf Lucene ändern und darauf achten, das logstash*-Indexmuster auszuwählen. Wir besprechen unten die Kibana Query Language (KBL).
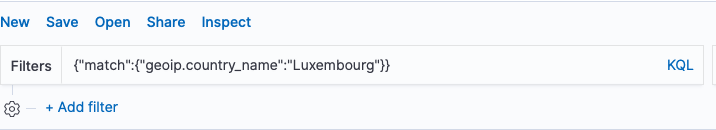
Wenn du vergisst, die Abfragesprache von KQL auf Lucene zu ändern, erhältst du den Fehler:
Discover: input.charAt is not a function. (In 'input.charAt(peg$currPos)', 'input.charAt' is undefined)
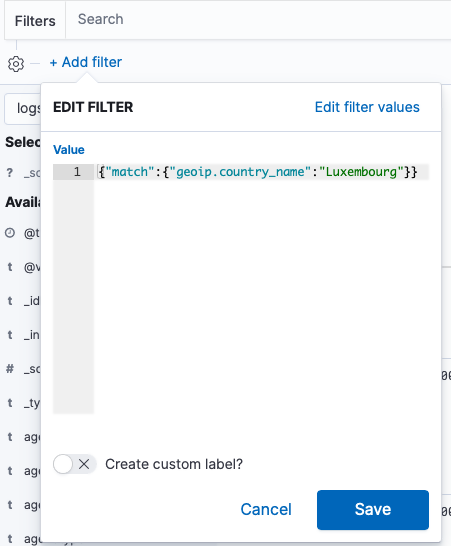
Der einfachste Weg, die JSON-DSL-Abfrage einzugeben, ist die Verwendung des Abfrageeditors, da er das Abfrageobjekt für Sie erstellt:
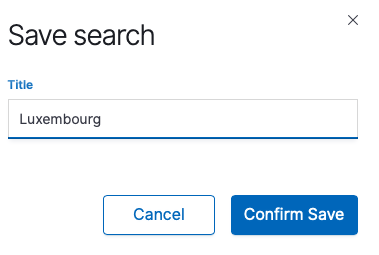
Speichern Sie die Abfrage und geben Sie ihr einen Namen:
Kibana Query Language (KBL) versus Lucene
Du kannst KBL oder Lucene in Kibana verwenden. Sie sind im Grunde gleich, nur dass KBL etwas vereinfacht und Scripting unterstützt.
Hier sind einige gängige Abfragen und wie Sie sie in jeder Abfragesprache ausführen.
| KBL | Lucene | Erklärung |
|---|---|---|
| Anfrage:"/wordpress/" | Anfrage:"/wordpress/" | Der Doppelpunkt (:) bedeutet gleich . Anführungszeichen bedeuten eine Sammlung von Wörtern, also eine Phrase. |
| Anfrage:/wordpress/ | Anfrage:/wordpress/ | Du brauchst keine Anführungszeichen für ein Wort. |
| Anfrage:/wordpress/ | Anfrage:/wordpress/ | Du brauchst keine Anführungszeichen für ein Wort. |
| Anfrage:/wordpress/ und Antwort:404 | Anfrage:/WordPress/ und Antwort:200 | für KBL muss man explizit den booleschen Operator angeben. Für Lucene wird der Operator nicht als Operator, sondern als Textstring erkannt, es sei denn, man verwendet "write it" in Großbuchstaben. |
| wordpress | wordpress | Treffer basieren auf jedem Text (in diesem Beispiel WordPress ) im Dokument und nicht auf ein bestimmtes Feld. |
| 200 oder 404 | 200 404 | Das Hinzufügen des Wortes oder zu Lucene würde auch Text mit der Zeichenkette "or" enthalten. Also lass es weg oder benutze großes OR. |
| 200 und 404 | 200 UND 404 | Verwenden Sie Großbuchstaben mit Lucene für logische Operatoren. |
| geoip.country_name: "Luxemburg" | {"match":{"geoip.country_name": "Luxemburg"}} | Lucene unterstützt JSON DSL-Abfragesprache, wie oben dargestellt |
| Antwort:>=200 und Antwort:< =404 | Antwort:[200 BIS 404] | Bereichsanfrage |
| Kilobytes > 1 | Nicht unterstützt | Geskriptetes Feld, wobei Kilobytes ist: wenn (doc['bytes'].size()==0) { return 0; } return doc['bytes'].value / 1024; |
ElasticSearch-Leitfaden
- ElasticSearch Tutorial für Anfänger: ElasticSearch Grundlagen
- Verwendung von Apache Hive mit ElasticSearch
- Verwendung von ElasticSearch mit Apache Spark
- Curl ElasticSearch Befehle Spickzettel
- Spark ElasticSearch Hadoop-Update und Upsert Beispiel und Erklärung
- Wie man Apache Spark-Daten mit Python in ElasticSearch schreibt
- ElasticSearch-Suchsyntax sowie boolesche und Aggregationssuchen
- ElasticSearch verschachtelte Abfragen: Wie man nach eingebetteten Dokumenten sucht
- ElasticSearch Joins: Has_Child, Has_parent Abfrage
- Wie man einen elastischen Cluster der Version 7 einrichtet
- Wie man Filebeat für nginx und ElasticSearch konfiguriert
- Beats und Logstash verwenden, um Logs an ElasticSearch zu senden
- Wie man eine CSV-Datei mit Logstash in ElasticSearch lädt
- ElasticSearch-Aggregationen erklärt
- Was ist der ELK-Stack?
- Logstash 101: Verwendung von Logstash in einer Datenverarbeitungspipeline
- Verwendung von Kibana zur Ausführung von Abfragen in ElasticSearch mit Lucene und Kibana Query Language
- ElasticSearch Maschinelles Lernen
- Wie man Elastic Enterprise Search installiert
- Wie man Elastic Enterprise Search mit GitHub verwendet
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.