




Auf einen Blick: Feature Stores verbessern MLOps, indem sie Daten verwalten, die für Modelltraining und -inferenz entscheidend sind, und so die Zusammenarbeit und die Datenqualität verbessern. Sie optimieren Arbeitsabläufe und unterstützen den Datenzugang und -austausch.
- Feature Stores erleichtern die Datentransformation, Speicherung und das Bereitstellen von Features an Modelle.
- Sie helfen, Doppelarbeit zu reduzieren, die Einhaltung gesetzlicher Vorschriften sicherzustellen und die Entwicklung zu beschleunigen.
Feature Stores sind ein Teil des maschinellen Lernprozesses und der ML-Tools. Feature Stores fügen sich zwischen die Daten und die Machine-Learning-Modelle ein.
Was ist ein Feature Store?
Feature Stores sind eine Möglichkeit, Daten zu verwalten, insbesondere für maschinelles Lernen (MLOps).
Eine einfache Erklärung von MLOps sind alle technischen Teile, die man zusammenbringen muss, um KI-Modelle bereitzustellen, ausführen und trainieren. Daher verwebt MLOps wesentliche Komponenten von:
- Maschinelles Lernen
- DevOps
- Datentechnik
Mit Feature Stores kann die Handwerkskunst von ML-Teams steigen, weil ihre Daten – das Lebenselixier jedes ML-Modells – leichter sichtbar sind.
(Lesen Sie unseren Vergleich von maschinellem Lernen und KI .)
Wie Feature Stores funktionieren
Früher lagen Daten bequem irgendwo auf einem Server. Data Scientists griffen auf die Daten zu, wenn sie für die Analyse benötigt wurden. Oder Nutzer fragten den Server ab, um Daten anzuzeigen.
Aber im Zeitalter der Big Data ist diese Art der Datenspeicherung und -abruf nicht mehr machbar.
Maschinelles Lernen und der Aufbau von KI-Systemen stellen einen anderen Anwendungsfall dar: Verschiedene Daten müssen aus ihren Quellen gezogen, dann transformiert und kombiniert werden, um einen Standardfunktionssatz für ein Modell zu schaffen.
Teams stehen vor Herausforderungen bei der Produktion von ML-Modellen. Mike Del Basco, Mitbegründer von Tecton.ai und Mitentwickler der Michelangelo-ML-Plattform von Uber, sagt, dass Teams vor diesen Herausforderungen stehen:
- Zugriff auf die richtigen Rohdaten
- Funktionen aus Rohdaten erstellen
- Funktionen in Trainingsdaten kombinieren
- Berechnung und Bereitstellung von Funktionen in der Produktion
- Überwachungsfunktionen in der Produktion
Feature Stores lösen ein Problem der zunehmenden Komplexität der Datenanforderungen durch den ML-Workflow. Data Scientists wollen – müssen – in der Lage sein, einfach:
- Überprüfung der Gültigkeit der Daten
- Überprüfe die Qualität
- Wisse, dass es frisch ist
- Die Daten erstellen und mit anderen teilen
Feature Stores sind zwischen den ML-Modellen und den Datenquellen positioniert, um die Art von Zugänglichkeit zu gewährleisten, die Machine-Learning-Teams benötigen.
Datenspeicherung
Überwachung

Feature Stores helfen Teams:
- Besser zusammenarbeiten
- Reduzierung der Doppelung
- Bessere Einhaltung gesetzlicher Vorschriften
- Schnellere Entwicklung
Wenn Daten die grundlegende Komponente eines ML-Modells sind, erhöhen Feature Stores die Fähigkeit eines Teams:
- Kommunizieren Sie über ihre Daten
- Erstelle mehr einzigartige ML-Modelle.
Wichtige Funktionen von Feature Stores
Feast ist ein Open-Source-Feature-Store-Projekt, das in Zusammenarbeit mit Google und Gojek entwickelt wurde. Die Google-Bereitstellung erfolgt über eine API. Feast basiert auf Redis und verwendet dann Big Query für die Speicherung.
Heute ist Feast auf allen wichtigen Plattformen aktiv. Dennoch ist die Designpraxis ein gutes Modell dafür, worauf man in einem Feature Store achten sollte. Lassen Sie uns also die wichtigsten Funktionen und Komponenten von Feature Stores erkunden.
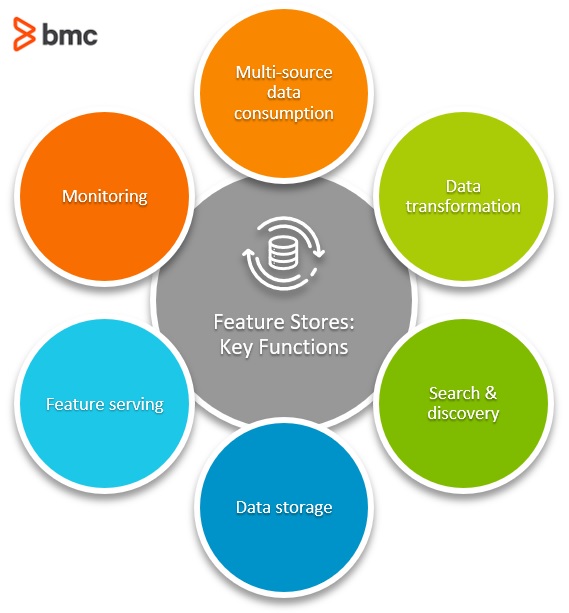
Datenverbrauch mit mehreren Quellen
Features Stores laden Daten aus vorgelagerten Quellen. Daten stammen aus vielen Quellen. Features müssen aus diesen Quellen extrahiert und zu Funktionssätzen kombiniert werden.
Der Feature-Store muss in der Lage sein, aus vielen Quellen zu lesen. Ein Feature-Store kann Daten über Folgendes laden:
- Verschiedene Bäche
- Lagerhäuser
- Datendateien
Datentransformation
Ein wesentlicher Vorteil des Feature Store ist, dass er es einfach macht, verschiedene Arten von Funktionen gemeinsam in denselben Modellen zu verwenden.
Data Scientists ziehen Daten aus verschiedenen Quellen ab, und der Feature Store ermöglicht es dem Modell, Daten auf konsistente Weise zu verknüpfen oder zu transformieren, während die Überwachung der Aktion abgeschlossen und erfolgreich abgeschlossen wurde.
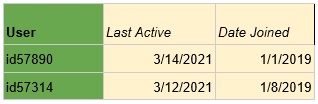
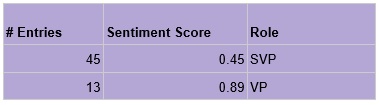
Neben der Erstellung von Funktionssätzen aus verschiedenen Quellen werden Daten auf verschiedene Weise transformiert, um ein Modell zu unterstützen. Eine Möglichkeit ist One-Hot-Kodierung oder Labeling von Daten oder die Kodierung von Textdaten , die von einem Modell verarbeitet werden.
Der Feature-Store überprüft mit geeigneter Analyse und Überwachung eine Konsistenz zwischen diesen Transformationen, um sicherzustellen, dass die Daten den Schritt vor der Bereitstellung an ein Modell erfolgreich abgeschlossen haben.
Ohne den Verifikationsschritt ist es möglich, Modelle zu trainieren und in die Produktion zu bringen – alles auf veralteten und unvollständigen Daten.
Suche & Entdeckung
Ein wichtiger Designaspekt beim Feature Store ist es, die Zusammenarbeit zwischen Teams zu fördern. Wenn ein Feature-Set erstellt wird und gut mit einem Modell zusammenarbeitet, ist das Ziel, dass dieses Set von anderen Modellen geteilt und genutzt wird oder von anderen Teams erstellt wird.
Ein guter Feature Store hat Möglichkeiten, Sets zu teilen, mit Registerinformationen, um sicherzustellen, dass die Features standardisiert und konsistent über alle Teams-Modelle hinweg sind.
Feature Stores müssen Daten irgendwo speichern, entweder online oder offline, da Daten aus den Quellen hindurchlaufen.
Aus Tecton.ai:
- "Offline-Speicherschichten werden typischerweise verwendet, um Monate oder Jahre an Feature-Daten für Trainingszwecke zu speichern. Offline-Feature-Store-Daten werden oft in Data Warehouses oder Data Lakes wie S3, BigQuery, Snowflake, Redshift gespeichert. Die Erweiterung eines bestehenden Data Lake oder Data Warehouse für die Offline-Speicherung von Features ist in der Regel bevorzugt, um Datensilos zu vermeiden.
- Online-Speicherschichten werden verwendet, um Feature-Werte für eine Suche mit niedriger Latenz während der Inferenz zu speichern. Sie speichern typischerweise nur die neuesten Feature-Werte für jede Entität und modellieren im Wesentlichen den aktuellen Zustand der Welt. Online-Stores sind in der Regel letztlich konsistent und haben für die meisten ML-Anwendungsfälle keine strikten Konsistenzanforderungen. Sie werden üblicherweise mit Key-Value-Stores wie DynamoDB, Redis oder Cassandra implementiert."
Feature-Serving
Der Feature Store muss in der Lage sein, Funktionen für verschiedene Modelle bereitzustellen, und die Tools dafür erfolgen in der Regel über eine API.
Modelle erfordern außerdem Konsistenz über die ihnen bereitgestellten Features, sodass bei der Bereitstellung der Features eine Überprüfung bestätigen kann, dass die bereitgestellten Daten den Anforderungen des Modells entsprechen.
Schließlich ist die stets präsente Sorge bei Codeblöcken die Integration der Möglichkeit, den Feature Store zu überwachen. Der Feature Store sollte viele Metriken zu den Daten liefern und die Vollständigkeit, Korrektheit und Qualität der darin durchlaufenden Datensätze erkennen.
Die Überwachung hilft dabei, das System zu aktualisieren, bei Fehlerfällen zu debuggen und in der Komplexität zu steigern.
Einstieg mit Feature Stores
Wenn ML-Teams groß werden, wird es notwendig, einen Weg zur Datenpflege zu finden. Die meisten großen Unternehmen, die KI nutzen, haben bereits interne Feature Stores aufgebaut: Google, Uber, Facebook, Amazon, Salesforce usw.
Jetzt werden diese Tools zu einem MLaaS für neue Unternehmen, die ihre KI-Reise weiterentwickeln.
Hier sind die Werkzeuge, um Ihren eigenen Feature Store zu entwickeln:
- Tecton.ai
- Feast.ai (Open-Source-Feature-Store)
- Amazon Sagemaker
- Molecula
- Feast/Kubeflow-Integration
Das wachsende MLOps hat mehr Bedürfnisse
Feature Stores sind nur eine der aufkommenden Notwendigkeiten großer ML-Ops-Teams. Die MLOps-Disziplin stellt hohe Anforderungen auf höheren operativen Ebenen. Für echtes MLOps müssen Sie in der Lage sein:
- Machen Sie den Datenzugriff und die Datenqualität einfach.
- Verfolgen Sie die Entwicklung eines Modells von Anfang an über die Ausbildung bis hin zum Dienst.
- Überwachen Sie den Erfolg des Modells, wenn es in die Produktion gebracht wird.
Im Allgemeinen gruppiert sich die ML-Industrie um drei Schlüsselbereiche:
- Datenmanagement, einschließlich Datenannotation und -verifikation, Qualitätskontrolle und Datenzugänglichkeit für Modelle und Data Scientists
- Datenpipelines , die den ML-Workflow automatisieren
- Bedienung oder Produktion des Modells
Wie wir sehen, passen Feature-Shops gut in diese Gruppen.
Verwandte Literatur
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.