




Auf einen Blick: Graphendatenbanken verbessern das Datenmanagement, indem sie komplexe Beziehungen effizient darstellen und so für Anwendungen wie Betrugserkennung und Empfehlungs-Engines geeignet sind. Ihre Struktur erleichtert eine fortgeschrittene Analyse komplexer Verbindungen.
- Wichtige Anwendungsfälle sind Betrugserkennung, Echtzeit-Empfehlungen und Identitätsmanagement.
- Graphdatenbanken sind hervorragend darin, komplexe Datenbeziehungen zu visualisieren und zu analysieren.
Wenn man anfängt, über Graphdatenbanken zu lesen, könnte der erste Eindruck sein, dass dies ein cleveres Produkt ist, aber dennoch nach Anwendungsfällen sucht, wie in den frühen Tagen des IoT (Internet der Dinge). Das liegt daran, dass es so esoterisch ist, dass reguläre RDBMS- und sogar NoSQL-Architekten, CIOs und Programmierer Schwierigkeiten haben werden, das zu begreifen.
Leichte Verlängerung
Erstens ist die Graphdatenbank trotz ihres seltsamen Aussehens flexibler als eine normale Beziehungsdatenbank, weil man die Beziehung zwischen den Elementen mit einfachen Pfeilen anzeigen kann, was eine natürliche Methode dafür ist. Das bekannteste Beispiel dafür ist das Facebook-Modell. Die Pfeile zeigen, wer Freunde sind und wer was mag. Dafür müsste man in einem relationalen Modell teure Joins machen. Außerdem müsste man das Schema erweitern, um zusätzliche Felder einzuschließen, die Eigenschaften jeder Entität darstellen, und viele Arrays erstellen. Während man das mit den meisten NoSQL-Datenbanken leicht machen kann, geht das auch mit einer Graphdatenbank, allerdings mit dem zusätzlichen Vorteil des multidimensionalen Graphen.
Kurz gesagt, wenn man alle Daten in einem Modell nimmt und Pfeile zeichnen würde, die zeigen, welche Elemente mit anderen zusammenhängen und wie, würde das Bild sehr dicht werden, das man nicht leicht sehen oder im Kopf erfassen kann, wenn die Daten groß sind.
Eine Graphendatenbank verfügt über Algorithmen, die das Sortieren all dessen erleichtern. Das berüchtigtste Beispiel dafür ist, dass Analysten Finanzdaten in eine Graphendatenbank einreichten und zufällig den berüchtigten Panama Papers-Skandal aufdeckten, bei dem Kriminelle, Filmstars und sogar die Königin von England dabei entdeckt wurden, Vermögenswerte auf Offshore-Bankkonten zu verstecken.
Anwendungsfälle
Die wichtigsten Anwendungsfälle sind einfach zu erklären. Es sind die Fälle darüber hinaus, in denen man sich vielleicht als Pionier wiederfindet, ohne viele technische Details darüber, wie andere Unternehmen so etwas umgesetzt haben.
Die häufigsten Anwendungsfälle sind:
Betrugserkennung
Betrugserkennung bei Banken und sogar bei Login-Mechanismen wie Facebook scheint ziemlich gut zu funktionieren. Sie schicken Ihnen eine Benachrichtigung, wenn verdächtige Aktivitäten auf Ihrem Konto vorliegen, und lehnen dann beispielsweise Ihre Kreditkarte ab. Dann müssten Sie Ihre Bank kontaktieren und bestätigen, dass Sie sich wirklich in etwa Kathmandu befinden und dass Sie einen Online-Kauf tätigen und nicht ein Hacker. Das geschieht mit verschiedenen Algorithmen, die dazu entwickelt wurden, die Knoten und Ränder eines Graphenmodells zu durchsuchen, um verdächtige Aktivitäten zu markieren.
Mit anderen Worten: Sie kann Tausende oder Millionen von Knoten wie unten gezeigt betrachten, um Ihre Transaktion in einen Risikobehälter zu ordnen und diejenigen als Hochrisiko-Punkte zu markieren:
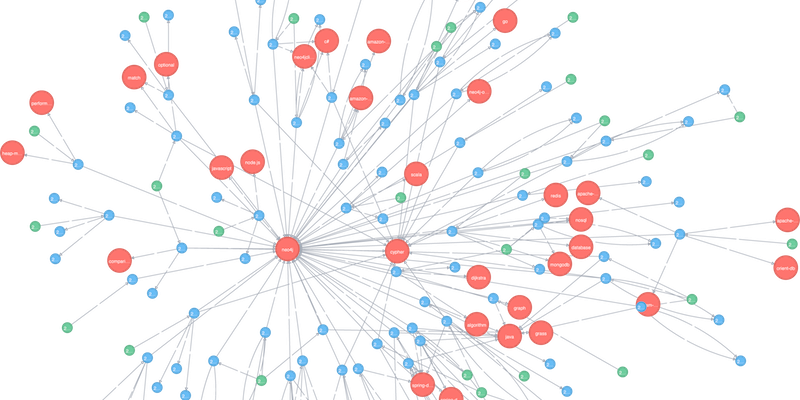
Grafische Quelle: NEO4J
Der Anwendungsfall der Betrugsanalyse könnte auch auf die Erkennung von Cybersecurity-Eindringlingen angewendet werden. Sie hat den Vorteil, dass Analysten nur wirklich signifikante Ereignisse betrachten und Ressourcen nicht für Ausreißer verschwendet werden, die statistische Zufälle sind, da sie Intelligenz und nicht fest kodierte Schwellenwerte verwendet.
Echtzeit-Empfehlungs-Engines
Wenn du auf Amazon einkaufst oder Serien auf Netflix ansiehst, durchsuchen diese Plattformen deine Wiedergabe- und Kaufhistorie und Personen, die als ähnlich angesehen werden, um dir Dinge zu empfehlen, die du als Nächstes ansehen oder kaufen möchtest. Netflix schaut auf IMDB. Amazon schaut sich an, welche Leute den gerade gekauften Artikel gekauft haben. Wenn du zum Beispiel ein iPhone kaufst, könnte es eine iPhone-Hülle vorschlagen.
Masterdatenmanagement und Identitätsmanagement
Dies ist ein Anwendungsfall, der von Neo4J, DataStax und anderen Anbietern erwähnt wurde. Es wird oft als eine Möglichkeit bezeichnet, "Datensilos" zu verwalten. Es ähnelt dem Anwendungsfall Identity Management, da es dokumentiert, welche Daten man über wen hat und welche Datenbank sie speichert. Das sind also Metadaten. Die tatsächlichen Daten würden in SQL oder LDAP (für Identity Management) gespeichert – also nicht in einer Graphdatenbank.
Wie bei einem IDM-System besteht die Komplexität bei diesem Systemtyp darin, die Metadaten korrekt zu halten. Ich habe mit mehreren IDM-Produkten gearbeitet und kann Ihnen sagen, dass es oft Probleme gibt, das zentrale IDM-Repository zu aktualisieren, wenn Benutzerzugangsdaten und Berechtigungen von einem System zum anderen synchronisiert werden.
Ein genannter Anwendungsfall ist die Möglichkeit, die DSGVO und andere Datenschutzanforderungen einzuhalten, da es einem Unternehmen ermöglicht, zu zeigen, welche Daten es über welche Personen hat.
Netzwerk- und IT-Betrieb
Das ist ein natürlicher Anwendungsfall, weil eine Netzwerktopologie wie ein Graph aussieht. Es macht also Sinn, sie so zu modellieren.
Weitere Anwendungsfälle für Graphdatenbanken
Hier sind einige weitere Anwendungsfälle, die von DataStax und anderen vorgeschlagen werden:
- Customer 360. Man verbindet diesen Begriff meist mit SalesForce, aber er kann als Graphdatenbank für jeden implementiert werden. Es würde einen breiten Überblick über Kunden geben, basierend darauf, zu welchen Entitäten (Knoten) sie gehören, welche Eigenschaften sie haben und welche Beziehungen (Kanten) zwischen ihnen liegen.
- Asset-Management. Dies ist ein praktikabler Kandidat für eine Graphdatenbank, da sie leicht erweiterbar ist. Sie hat keine starre Struktur wie ein RDBMS, die es ermöglicht, Knoten, Eigenschaften und Kanten nach Belieben hinzuzufügen. Sie können also alle möglichen verschiedenen Assets hinzufügen und sie mit Labels (Knoten) taggen, sodass Sie deren Kostenstelle, deren Zwecke, Wartungspläne, Besitzer usw. verfolgen können, ohne Ansichten, Arrays usw. aktualisieren oder neu berechnen oder Schemata ändern zu müssen.
- Knowledge Graph. Google ist eines davon. Es sammelt Dokumente aus verschiedenen Quellen und präsentiert sie dann so, dass sie durchsuchbar sind.
Leitfaden zur Datenvisualisierung
- Der Datenvisualisierungs-Anfängerleitfaden
- Einführung in Graphdatenbanken
- Anwendungsfälle für Graphdatenbanken
- Einführung in die Neo4j-Graphdatenbank
- Neo4j-Graphdatenbank-Abfragen
- Matplotlib-Streu- und Liniendiagramme erklärt
- Wie man Nebenhandlungen in Matplotlib hinzufügt
- Matplotlib-Logarithmische Skala
- Verwendung von Matplotlib zum Zeichnen von Diagrammen und Graphen
- Wie man 3D-Diagramme mit Matplotlib zeichnet
- Plotly Python Tutorial
- Ermöglichung der Bürgerdatenwissenschaftler
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.