




Auf einen Blick: Neo4j ist eine führende Graphdatenbank, die Daten als Knoten, Kanten und Eigenschaften organisiert und damit ideal für Big-Data-Analysen macht. Sie bietet eine kostenlose Community Edition und eine Testversion für die Enterprise-Version, die es Nutzern ermöglicht, komplexe Beziehungen mit der Cypher-Abfragesprache zu verwalten.
- Graphdatenbanken wie Neo4j sind hervorragend darin, Beziehungen wie soziale Verbindungen zu illustrieren.
- Seine robusten Fähigkeiten und die Unterstützung von Graphenalgorithmen tragen zu seiner Beliebtheit bei.
Neo4j ist eine Graphdatenbank. Eine Graphdatenbank hat statt Zeilen und Spalten Knotenkanten, Kanten und Eigenschaften. Sie eignet sich für bestimmte Big-Data- und Analyseanwendungen besser als Zeilen- und Spaltendatenbanken oder freie JSON-Dokumentdatenbanken für viele Anwendungsfälle.
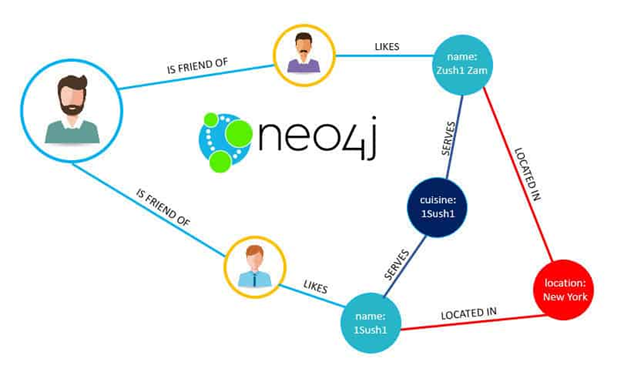
Eine Graphdatenbank wird verwendet, um Beziehungen darzustellen. Das häufigste Beispiel dafür ist die Facebook-Freundschaftsbeziehung sowie die Like-Beziehung . Einige davon können Sie in der untenstehenden Grafik von Neo4j sehen.
Die Kreise sind Knoten. Die Linien, sogenannte Kanten, zeigen Beziehungen an. Und alle Kommentare innerhalb der Kreise sind Eigenschaften dieses Knotens.
Wir schreiben hier über Neo4j, weil es den größten Marktanteil hat. Es gibt noch andere Akteure in diesem Markt. Und laut Neo4J wird Apache Spark 3.0 die Neo4j Cypher Query Language hinzufügen, um "Eigenschaftsgraphen basierend auf DataFrames für Spark" zu ermöglichen und zu erleichtern. Spark unterstützt bereits GraphX, das eine Erweiterung des RDD ist, um Graphen zu unterstützen. Darüber werden wir in einem weiteren Blogbeitrag sprechen.
In einem weiteren Beitrag werden wir auch Graphenalgorithmen besprechen. Der bekannteste davon ist der Google Page Rank Index. Algorithmen sind der Weg, um sich an den Knoten und Kanten zu orientieren.
Kosten?
Ist Neo4J kostenlos? Das ist ziemlich kompliziert. Die Community Edition ist es. Ebenso die Desktop-Version, die zum Lernen geeignet ist. Die Enterprise Edition ist es nicht. Das ist mit anderen Open-Source-Produkten vereinbar. Als ich Neo4J um eine Lizenz bat, um über einen längeren Zeitraum mit ihrem Produkt zu arbeiten, empfahlen sie mir, die Desktop-Version zu verwenden. Die Enterprise-Version hat eine 30-tägige Testphase.
Es gibt noch andere Alternativen auf dem Markt. Der Schlüssel wäre, eine zu wählen, die genug Nutzer hat, damit sie nicht pleitegehen. Welche solltest du wählen? Du musst dich dafür informieren.
Installieren Sie Neo4J
Du kannst die Desktop- oder Tar-Version verwenden. Hier benutze ich die Tar-Version auf Mac. Lade sie einfach herunter und starte dann die Shell wie unten gezeigt. Du brauchst dann ein Java-JDK.
export JAVA_HOME='/Library/Java/JavaVirtualMachines/jdk1.8.0_201.jdk/Contents/Home'
Starte den Server und setze das Anfangspasswort und öffne dann cypher-shell. Die Standard-URL ist ein ziemlich seltsam aussehendes bolt://localhost:7687.
    cd neo4j bin folder

neo4j-admin set-initial-password xxxxxx

./cypher-shell   -a bolt://localhost:7687  -u neo4j  -p xxxxx
Einen einzelnen Knoten erstellen
Etwas mit einem Knoten als Kreis oder Objekt, auf dem obigen Bild. Er kann optional Eigenschaften oder ein Label oder beides haben.
Nachfolgend ist die einfachste Möglichkeit, einen Knoten zu erstellen. (Beachten Sie, dass Sie jeden Befehl mit einem Semikolon beenden müssen.) Dieser Knoten hat nichts daran, also keine Eigenschaften oder Bezeichnungen. Er hat nur eine Variable, n, die Sie in anderen Operationen verwenden können. Was all das bedeutet, wird in den folgenden Schritten klar werden.
    create (n);

0 rows available after 13 ms, consumed after another 0 ms
Added 1 nodes
Cyper SQL nennt Neo4j ihre Befehlssprache. Wenn man einen Befehl ausführt, gibt er keinen Wert zurück, es sei denn, man fügt das Return-Schlüsselwort hinzu. In diesem Beispiel erstellen wir wie zuvor einen Knoten ohne Inhalt. Neo4j erstellt eine Variable, die wir x genannt haben, um dieses Objekt darzustellen, das wir dann mit der return-Anweisung zurückgeben können, damit wir sie sehen oder in nachfolgenden Operationen verwenden können.
    create(x) return x ;

+----+
| x  |
+----+
| () |
+----+
Mehrere Knoten erstellen
Man kann mehr als einen Knoten gleichzeitig erstellen:
    create (o),(p);
0 rows available after 13 ms, consumed after another 0 ms
Added 2 nodes
Erstelle einen Node mit einem Label
Ein Label ist wie der Name des Knotens, oder man kann es sich als Typ vorstellen. Darunter ist der Knoten mit dem Label Student. Labels haben Doppelkollone (:) davor. Wie zuvor ist s einfach eine Variable. Ihr Umfang ist die Lebensdauer der Schale. Schließt man die Schale, verschwindet die Variable.
    create (s:Student);
0 rows available after 16 ms, consumed after another 0 ms
Added 1 nodes, Added 1 labels
Du kannst Knoten mit mehr als einem Label erstellen:
create (s:Student:Biology) return s;
Zusätzlich zu einem Label kann ein Knoten Eigenschaften besitzen, die als JSON angegeben sind:
    CREATE (x:Employees { name: 'Walker', title: 'Tech Writer' })
CREATE (y:Employees { name: 'Stephen', title: 'Manager' })
return x,y;
Eine Beziehung aufbauen
Die Syntax zur Erstellung einer Relation sieht seltsam aus. Unten heißt diese Beispielbeziehung BOSS. Das r davor ist einfach eine Variable. Und der Pfeil zeigt die Richtung an. Du kannst ->, <- oder - verwenden, um die Richtung anzuzeigen. Da es kompliziert ist, sich die Richtung zu merken, solltest du vielleicht das - (Strich) verwenden, was beide Richtungen bedeutet, in wirklich komplexen Modellen, wenn die Richtung keine Rolle spielt. Das ist eine Designentscheidung.
Im Folgenden wird gezeigt, wie man eine Beziehung erstellt. In diesem Beispiel sagen wir, dass Stephen der BOSS von Walker ist. Die MATCH-Anweisung ähnelt der SQL-Select. Sie gibt die Auswahlkriterien an, die zeigen, welche zwei Elemente miteinander verbunden werden sollten.
Und hier verwenden wir x und y als temporäre Variablen. Wie Sie sehen, erlauben sie es, in nachfolgenden Anweisungen eine Kurzschrift zu verwenden, wobei der Variablenname statt des :label verwendet wird.
    MATCH (x:Employees),(y:Employees)
WHERE y.name = "Stephen" AND x.name = "Walker"
CREATE (x)-[r:BOSS]->(y)
RETURN type(r);
Jetzt führen wir die Logik in die entgegengesetzte Richtung. Wenn Stephen Walkers Chef ist, dann arbeitet Walker für Stephen. Also können wir Walker zum MITARBEITER von Stephen machen. Wir können jeden beschreibenden Namen verwenden, wie EMPLOYEEOF.
    MATCH (x:Employees),(y:Employees)
WHERE y.name = "Stephen" AND x.name = "Walker"
CREATE (y)-[r:EMPLOYEEOF]->(x)
RETURN type(r);
Mehrere Beziehungen schaffen
Hier geben wir ein weiteres Beispiel: Hier haben wir ein Modell von Medikamenten, wofür sie verwendet werden und wer sie herstellt.
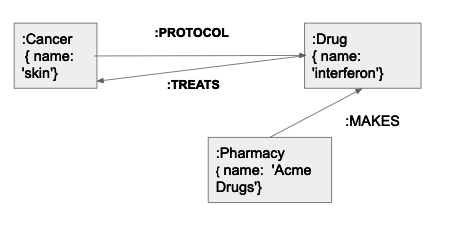
Erstelle einige Daten und dann die Beziehungen. Achte auf die Ausgabe, denn wenn du einen Fehler machst und die MATCH-Anweisung keine Daten findet, dann hat auch die Beziehung keine Daten. Mit anderen Worten: Erstelle n Knoten oder Created n Relations, wobei n > 0 ist.
    CREATE (x:Cancers { name: 'skin'});
CREATE (x:Drugs { name: 'interferon'});
CREATE (x:Pharmacy { name:  'Acme Drugs'});

MATCH (a:Cancers),(b:Drugs)
WHERE a.name = 'skin' AND b.name = 'interferon'
CREATE (a)-[rp:PROTOCOL]->(b), (b)-[rt:TREATS]->(a);

MATCH (a:Pharmacy),(b:Drugs)
WHERE a.name = 'Acme Drugs' AND b.name = 'interferon'
CREATE (a)-[r:MAKES]->(b);
Hier stellen wir Beziehungen in beide Richtungen her und bilden zwei Beziehungen gleichzeitig. Beachte, dass b und a die Positionen tauschen, um zu zeigen, was zu welchem gehört. Wir hätten den Pfeil auch in die entgegengesetzte Richtung zeigen können.
    MATCH (a:Cancers),(b:Drugs)
       WHERE a.name = 'skin' AND b.name = 'interferon'
       CREATE (a)-[rp:PROTOCOL]->(b), (b)-[rt:TREATS]->(a);
Abfragen
Hier zeigen wir weiter, wie MATCH funktioniert. Zuerst listen wir alle Knoten mit Etikett Pharmacy auf.
    MATCH (p:Pharmacy) return p;
+----------------------------------+
| p                                |
+----------------------------------+
| (:Pharmacy {name: "Acme Drugs"}) |
+----------------------------------+
Jetzt zeigen wir alle Beziehungen von Apotheken, die Medikamente herstellen.
    MATCH (p:Pharmacy)-[r:MAKES]->(b:Drugs) return p,b;
+------------------------------------------------------------------+
| p                                | b                             |
+------------------------------------------------------------------+
| (:Pharmacy {name: "Acme Drugs"}) | (:Drugs {name: "interferon"}) |
+------------------------------------------------------------------+
Leitfaden zur Datenvisualisierung
- Der Datenvisualisierungs-Anfängerleitfaden
- Einführung in Graphdatenbanken
- Anwendungsfälle für Graphdatenbanken
- Einführung in die Neo4j-Graphdatenbank
- Neo4j-Graphdatenbank-Abfragen
- Matplotlib-Streu- und Liniendiagramme erklärt
- Wie man Nebenhandlungen in Matplotlib hinzufügt
- Matplotlib-Logarithmische Skala
- Verwendung von Matplotlib zum Zeichnen von Diagrammen und Graphen
- Wie man 3D-Diagramme mit Matplotlib zeichnet
- Plotly Python Tutorial
- Ermöglichung der Bürgerdatenwissenschaftler
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.