




Auf einen Blick: Keras erleichtert den Aufbau neuronaler Netze für Klassifikationsprobleme, veranschaulicht durch die Vorhersage von Diabetes anhand eines Datensatzes. Der Leitfaden behandelt die Grundlagen von Keras, einschließlich des Einsatzes von Perzeptronen und Modellgenauigkeit, sodass Nutzer etwa 72 % Genauigkeit erreichen können.
- Keras bietet eine einfachere API im Vergleich zu TensorFlow.
- Enthält praktische Codeschnipsel zum Aufbau eines neuronalen Netzwerkmodells.
Keras können verwendet werden, um ein neuronales Netzwerk zu bauen, um ein Klassifikationsproblem zu lösen. In diesem Artikel werden wir:
- Beschreibe Keras und warum du es statt TensorFlow verwenden solltest
- Erkläre Perzeptrone in einem neuronalen Netzwerk
- Zeigen Sie, wie Keras verwendet wird, um ein binäres Klassifikationsproblem zu lösen
Für einen Teil dieses Codes greifen wir auf Erkenntnisse aus einem Blogbeitrag von Karlijn Willems bei DataCamp zurück.
Was ist Keras?
Keras ist eine API, die auf Googles TensorFlow, Microsoft Cognitive Toolkit (CNTK) und anderen Machine-Learning-Frameworks basiert. Das Ziel ist es, eine einzige API zu haben, die mit all diesen Systemen arbeitet und diese Arbeit erleichtert.
Meiner Meinung nach sollte man immer Keras statt TensorFlow verwenden, da Keras viel einfacher ist und man daher weniger dazu neigt, Modelle mit falschen Schlussfolgerungen zu machen. Zu viele Leute stürzen sich und fangen an, TensorFlow zu benutzen, und haben Schwierigkeiten, es zum Laufen zu bringen. Keras fügt Einfachheit hinzu. Aber man kann TensorFlow-Funktionen direkt mit Keras verwenden und Keras erweitern, indem man eigene Funktionen schreibt.
Keras-Voraussetzungen
Um das untenstehende Beispiel durchzugehen, musst du Zeppelin sowie diese Python-Pakete installiert haben:
- TensorFlow
- Keras
- Theano
- Seaborn
- Matplotlib
- NumPy
- pydot
- scikit-learn
Sie benötigen auch dieses Paket:
- sudo apt install install graphviz
Zuerst verwenden wir diesen Datensatz von Kaggle, der Diabetes bei Pima-Ureinwohnern verfolgt. Wir verwenden ihn, um ein prädiktives Modell zu erstellen, wie wahrscheinlich es ist, dass jemand Diabetes bekommt oder hat, basierend auf Alter, Body-Mass-Index, Glukose- und Insulinwerten, Hautdicke usw.
Der untenstehende Code fügt diese Features (Glucode, BMI usw.) und Beschriftungen (der einzelne Wert ja [1] oder nein [0]) in ein Keras-neuronales Netzwerk ein, um ein Modell zu erstellen, das mit etwa 80 % Genauigkeit vorhersagen kann, ob jemand Typ-II-Diabetes hat oder erleiden wird.
Neuronales Netzwerk
Hier werden wir ein mehrschichtiges Perzeptron bauen. Dies ist auch als Feed-forward-neuronales Netzwerk bekannt. Das steht im Gegensatz zu ausgefeilteren Netzwerken, die mehr als einen Durchgang durch das Netzwerk führen können, um die Genauigkeit des Modells zu erhöhen.
Wenn das neuronale Netzwerk nur eine Schicht hätte, wäre es einfach ein logistisches Regressionsmodell.
Man kann sich das immer noch als logistisches Regressionsmodell vorstellen, das jedoch durch mehrfache logistische Regressionsberechnungen eine höhere Genauigkeit aufweist. Das ist die Grundidee hinter dem neuronalen Netzwerk: Berechnen, testen, erneut berechnen, erneut testen und wiederholen, bis eine optimale Lösung gefunden wird. Dieser Ansatz funktioniert für Handschrift, Gesichtserkennung und die Vorhersage von Diabetes.
Neuronale Netze erklärt
Du solltest ein grundlegendes Verständnis der Logik hinter neuronalen Netzen haben, bevor du den untenstehenden Code studierst. Hier ist eine kurze Zusammenfassung; du brauchst ein grundlegendes Verständnis der linearen Algebra, um der Diskussion folgen zu können.
Im Grunde ist ein neuronales Netzwerk ein zusammenhängender Graph von Perzeptronen. Jedes Perzeptron ist einfach eine Funktion. Bei einem Klassifikationsproblem ist sein Ergebnis dasselbe wie die Labels im Klassifikationsproblem. Für dieses Modell ist es 0 oder 1. Für die Handschrifterkennung wären die Buchstaben im Alphabet das Ergebnis.
Jedes Perzeptron führt eine Berechnung durch und übergibt diese an das nächste Perzeptron. Diese Berechnung ist eigentlich eine Wahrscheinlichkeit. Im Fall eines Klassifikationsproblems wird ein Schwellenwert t beliebig so gesetzt, dass, wenn die Wahrscheinlichkeit für das Ereignis x > t ist, das Ergebnis 1 (wahr) ist, ansonsten falsch (0). Für die logistische Regression beträgt diese Schwelle 50 %.
Die verwendeten Funktionen sind eine Sigmoid-Funktion , also eine Kurve wie eine Sinuswelle, die zwischen zwei bekannten Werten variiert. Die logistische Sigmoid-Funktion funktioniert in diesem Beispiel gut, da wir vorhersagen wollen, ob jemand Diabetes (1) hat oder bekommt (0).
Ein neuronales Netz ist einfach ein großes lineares oder logistisches Regressionsproblem
Die logistische Regression steht in engem Zusammenhang mit der linearen Regression. Der einzige Unterschied ist, dass die logistische Regression ein diskretes Ergebnis liefert und die lineare Regression eine reelle Zahl. Tatsächlich gilt: Wenn wir ein lineares Modell y = wx + b haben und t = y haben, dann ist die logistische Funktion .
Der Code
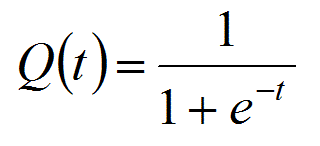
Es ist eine Zahl, die so konzipiert ist, dass sie zwischen 1 und 0 liegt, weshalb sie gut für Wahrscheinlichkeitsberechnungen geeignet ist.
In der einfachen linearen Gleichung y = mx + b arbeiten wir nur mit der Variablen x. Dieses Problem kann man mit Microsoft Excel oder Google Sheets lösen. Dafür braucht man kein neuronales Netz.
In den meisten Problemen, denen wir in der realen Welt begegnen, haben wir es mit vielen Variablen zu tun. In diesem Fall sind m und x Matrizen. Aber die Mathematik ist ähnlich, weil wir immer noch das Konzept von Gewichten und Verzerrungen in mx + b haben.
In der untenstehenden Formel ist die Matrix die Größe m x 1 darunter. Es handelt sich also um einen Vektor, also eine eindimensionale Matrix. Jedes von i= 1, 2, 3, ..., m Gewichten ist wi. Und es gibt m Merkmale (x) x1, x2, x3, ..., xm. x ist BMI; Glukose usw. in den Diabetesdaten. Die Gewichte w1, w2, ..., wm und die Verzerrung ist die Zahl, die die Beziehung zwischen diesen Indikatoren und der Wahrscheinlichkeit, dass die Person diabetisch ist, am genauesten vorhersagt.
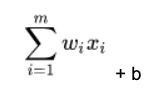
Für jeden Knoten im neuronalen Netz berechnen wir das Skalarprodukt von w • x, was bedeutet, jedes Gewicht w mit jedem Merkmal x aus unserem Trainingsset multiplizieren, und fügen dann eine Verzerrung b hinzu, um die Berechnung nach oben oder unten zu verschieben.
Die erweiterte Berechnung sieht so aus: Man nimmt jedes Element aus dem Vektor w und multipliziert es mit seinem entsprechenden Element im Vektor x.
f(x) = (w1* x1 + w2 * x2 + … + wm * xm) + b.
Das ergibt uns eine reelle Zahl. Im Fall der logistischen Funktion, wie oben gesagt, > f(x) %50, dann gibt das Perzeptron 1 aus. Ansonsten 0.
Lösung des neuronalen Netzwerkproblems
Der Algorithmus stoppt, wenn das Modell konvergiert, das heißt, wenn der Fehler den minimal möglichen Wert erreicht. In klarem Deutsch bedeutet das, dass wir ein Modell mit einer bestimmten Genauigkeit erstellt haben. Der Fehler ist der Wertfehler = 1 - (Anzahl der Fehler, die das Modell korrekt ist) / (Anzahl der Beobachtungen).
Ein Mathematiker würde sagen, das Modell konvergiert, wenn wir eine Hyperebene gefunden haben, die jeden Punkt in diesem m-dimensionalen Raum (da es m Eingabevariablen gibt) mit maximalem Abstand zwischen Ebene und Punkten im Raum trennt. Jedes der positiven Ergebnisse befindet sich auf einer Seite der Hyperebene und jedes der negativen Ergebnisse auf der anderen. Mit anderen Worten, es ist wie die Berechnung des LSE (Kleinste-Quadrat-Fehler) in einem einfachen linearen Regressionsproblem, nur dass dies in mehr als einer Dimension arbeitet.
Wenn eine solche Hyperebene nicht existiert, gibt es keine Lösung für das Problem. Dann schließen wir, dass kein Modell gebaut werden kann, weil zwischen den Variablen nicht genügend Korrelation besteht.
Neuronale Netzwerkschichten
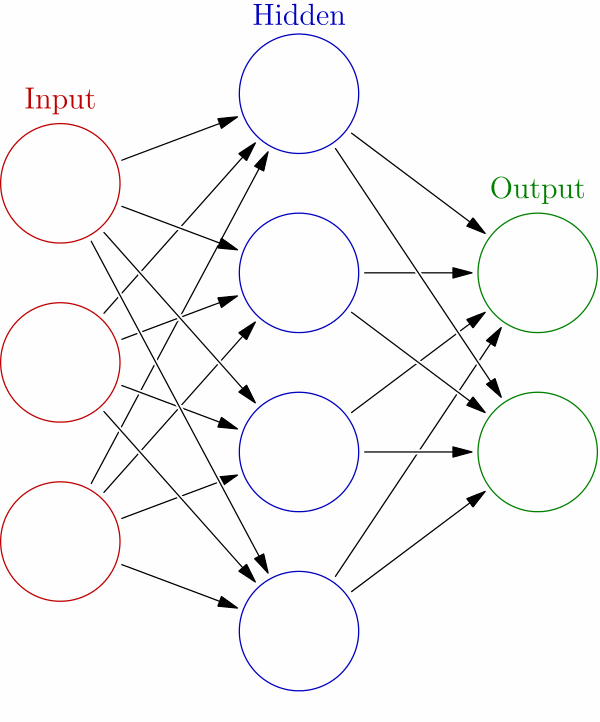
Denken Sie daran, dass der Ansatz zur Lösung eines solchen Problems iterativ ist. Im Hinblick auf ein neuronales Netzwerk können Sie dies in dieser untenstehenden Grafik sehen.
Quelle: Wikipedia
Die Daten
Wir haben eine Eingabeschicht, auf der wir unsere Matrix von Features und Labels einspeisen. Diese Perzeptronfunktionen berechnen dann eine anfängliche Menge von Gewichten und übergeben sie an beliebig viele versteckte Schichten. Wie oft dies geschieht, wird durch die Parameter bestimmt, die Sie an die Algorithmen weitergeben, den Algorithmus, den Sie für die Verlust- und Aktivierungsfunktion auswählen, sowie die Anzahl der Knoten, die das Netzwerk verwenden darf.
Die endgültige Lösung erscheint später in der Ausgabe. Es gibt nur eine Eingabe- und Ausgabeschicht. Es gibt keine wissenschaftliche Möglichkeit zu bestimmen, wie viele versteckte Schichten man verwenden sollte. Der Data Scientist variiert diese und die verwendeten Algorithmen auf jeder Schicht, bis die genaueste Lösung gefunden wird. Es ist also Versuch und Irrtum.
Wir haben den Code für dieses Beispiel hier in einem Jupyter-Notizbuch gespeichert.
Korrelationsdiagramm für die Seegeburten
Ein erster Schritt in der Datenanalyse sollte das Plotten sein, da es leichter ist zu sehen, ob wir ein Muster erkennen können.
Wir könnten damit beginnen, zu prüfen, ob es eine Korrelation zwischen den Variablen gibt. Deshalb verwenden wir das mächtige Seaborn-Korrelationsdiagramm. Seaborn ist eine Erweiterung von Matplotlib.
Laden Sie zuerst die Daten in ein Dataframe:
Aktivierungsfunktion
    import tensorflow as tf
from keras.models import Sequential
import pandas as pd
from keras.layers import Dense

data = pd.read_csv('/home/ubuntu/Downloads/diabetes.csv', delimiter=',')
Dann begutachte es visuell:
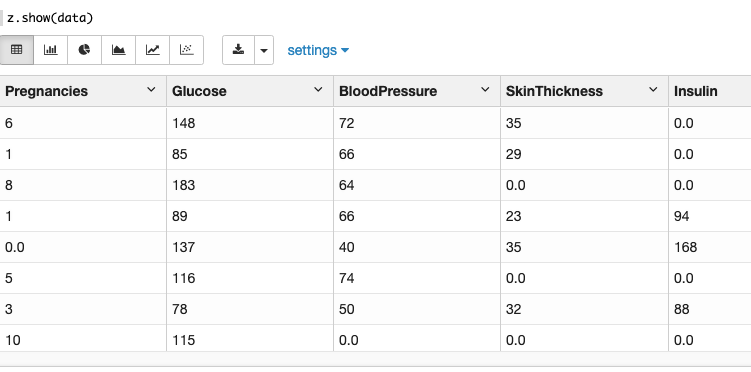
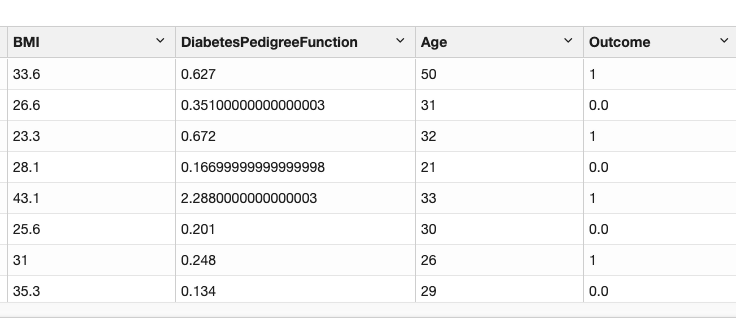
Zuerst wollen wir die Daten durchstöbern und Maximum-, Minimal- und Durchschnittswerte auflisten
data.describe()
    Pregnancies Glucose BloodPressure SkinThickness Insulin \
count 768.000000 768.000000 768.000000 768.000000 768.000000
mean 3.845052 120.894531 69.105469 20.536458 79.799479
std 3.369578 31.972618 19.355807 15.952218 115.244002
min 0.000000 0.000000 0.000000 0.000000 0.000000
25% 1.000000 99.000000 62.000000 0.000000 0.000000
50% 3.000000 117.000000 72.000000 23.000000 30.500000
75% 6.000000 140.250000 80.000000 32.000000 127.250000
max 17.000000 199.000000 122.000000 99.000000 846.000000

BMI DiabetesPedigreeFunction Age Outcome \
count 768.000000 768.000000 768.000000 768.000000
mean 31.992578 0.471876 33.240885 0.348958
std 7.884160 0.331329 11.760232 0.476951
min 0.000000 0.078000 21.000000 0.000000
25% 27.300000 0.243750 24.000000 0.000000
50% 32.000000 0.372500 29.000000 0.000000
75% 36.600000 0.626250 41.000000 1.000000
max 67.100000 2.420000 81.000000 1.000000

prediction
count 768.000000
mean 0.317708
std 0.465889
min 0.000000
25% 0.000000
50% 0.000000
75% 1.000000
max 1.000000
FINISHED
Man kann die Werte im Dataframe auch so inspizieren:
data.info()
    RangeIndex: 768 entries, 0 to 767
Data columns (total 9 columns):
Pregnancies                 768 non-null int64
Glucose                     768 non-null int64
BloodPressure               768 non-null int64
SkinThickness               768 non-null int64
Insulin                     768 non-null int64
BMI                         768 non-null float64
DiabetesPedigreeFunction    768 non-null float64
Age                         768 non-null int64
Outcome                     768 non-null int64
dtypes: float64(2), int64(7)
memory usage: 54.1 KB
Überprüfen Sie die Korrelation mit dem Heatmap-Graphen
Als Nächstes führen Sie diesen Code aus, um eine mögliche Korrelation zwischen den Variablen zu sehen. Das ist für das endgültige Modell nicht wichtig, aber nützlich, um weitere Einblicke in die Daten zu gewinnen.
Seaborn erstellt eine Heatmap-ähnliche Grafik, in der jeder Wert aus dem Datensatz gegen sich selbst und alle anderen Werte ausgebildet wird. Dann wird festgestellt, ob diese beiden Werte in irgendeiner Weise miteinander korrelieren.
    import seaborn as sns
import matplotlib as plt
corr = data.corr()
sns.heatmap(corr,
            xticklabels=corr.columns.values,
            yticklabels=corr.columns.values)
Punkte, die perfekt korreliert sind, haben den Korrelationswert 1. Offensichtlich ist jede Metrik perfekt mit sich selbst korreliert, was durch die Tan-Linie illustriert wird, die diagonal durch die Mitte des Diagramms verläuft.
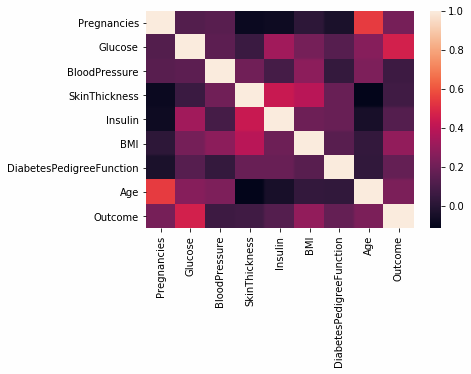
Im Diagramm gibt es nicht viele orangefarbene Quadrate. Man kann also sagen, dass kein einzelner Wert zu 80 % Diabetes verursacht (Ergebnis). Es scheint kaum eine Korrelation zwischen diesen einzelnen Variablen zu geben. Aber wir werden sehen, dass wir zusammen mit fast 75 % Genauigkeit vorhersagen können, wer unter allen diesen Faktoren Diabetes entwickeln wird.
Du kannst die Korrelation zwischen zwei Variablen in einem Datenrahmen wie unten gezeigt überprüfen. Hier gibt es nicht viel Korrelation, da 0,28 und 0,54 weit von 1,00 entfernt sind.
    data['BloodPressure'].corr( data["BMI"])

0.2818052888499106

data["Pregnancies"].corr(data["Age"])

0.5443412284023394
Bereite die Test- und Trainingsdatensätze vor
- Das Ergebnis ist die Spalte mit dem Label (0 oder 1).
- Die übrigen Säulen sind die Merkmale.
- Wir verwenden die scikit-learn-Funktion train_test_split(X, y, test_size=0,33, random_state=42), um die Daten in Trainings- und Testdatensätze aufzuteilen, wobei 33 % der Datensätze dem Testdatensatz zugewiesen werden. Der Trainingsdatensatz wird verwendet, um den Modus zu trainieren, also die Gewichte und Verzerrungen zu bestimmen. Der Testdatensatz wird verwendet, um seine Genauigkeit zu überprüfen.
- labels ist kein Array. Es ist eine Spalte in einem Datensatz. Deshalb verwenden wir die NumPy np. Ravel()-Funktion, um das in ein Array umzuwandeln.
    import numpy as np

labels=data['Outcome']
features = data.iloc[:,0:8]

from sklearn.model_selection import train_test_split

X=features

y=np.ravel(labels)

X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.33, random_state=42)
Jetzt normalisieren wir die Werte, das heißt, nehmen wir jedes x im Trainings- und Testdatensatz und berechnen (x - μ) / δ, also den Abstand vom Mittelwert (μ) geteilt durch die Standardabweichung (δ). Das setzt die Daten auf eine Standardskala, was beim maschinellen Lernen Standardpraxis ist.
StandardScaler macht dies in zwei Schritten: fit() und transform().
    from sklearn.preprocessing import StandardScaler

scaler = StandardScaler().fit(X_train)

X_train = scaler.transform(X_train)

X_test = scaler.transform(X_test)
Das Keras-sequentielle Modell
Der untenstehende Code erstellte ein Keras-sequentielles Modell, was bedeutet, dass die Schichten im neuronalen Netzwerk einzeln hinzugefügt werden, im Gegensatz zu anderen Techniken und neuronalen Netzwerktypen.
Wähle für jede Schicht eine Aktivierungsfunktion . Sie nimmt ((w • x) + b) und berechnet eine Wahrscheinlichkeit. Dann setzt sie eine Schwelle, um zu bestimmen, ob das Neuron ((w • x) + b) 1 (wahr) oder (0) negativ sein sollte. (Das ist nicht dasselbe wie Diabetiker 1 oder nicht, 0, da neuronale Netze Probleme mit mehr als nur zwei diskreten Ergebnissen lösen können.)
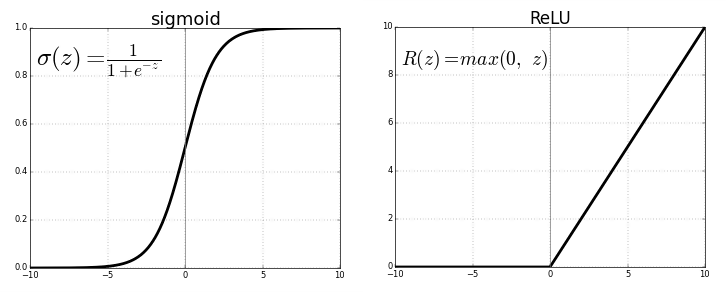
Für die ersten beiden Schichten verwenden wir eine Relu-Aktivierungsfunktion (rektifizierte lineare Einheit). Diese Wahl bedeutet nichts, da du Sigmoid wählen könntest. reluI ist 1 für alle positiven Werte und 0 für alle negativen. Also:
f(x) = 0 if x <=0
f(x) = 1 if x > 0
Das ist dasselbe wie zu sagen f(x) = max (0, x). F(-1) gilt zum Beispiel = max(0, -1) = 0. Mit anderen Worten: Wenn unsere Wahrscheinlichkeitsfunktion negativ ist, dann wählen Sie 0 (falsch). Ansonsten wählen Sie 1 (wahr).
Die Regel, welche Aktivierungsfunktion gewählt wird, ist Versuch und Irrtum. Wählen Sie verschiedene aus und sehen Sie, welche die genauesten Vorhersagen liefert. Es gibt weitere: Sigmoid, Tanh, Softmax, ReLU und Leaky ReLU. Einige sind eher für mehrere als binäre Ausgaben geeignet.
Sigmoid verwendet die logistische Funktion 1 / (1 + e**z), wobei z = f(x) = ((w • x) + b) gilt.
Dieses Diagramm von Beyond Data Science zeigt jede Funktion als Kurve dargestellt.
Einige Anmerkungen zum Code:
- input_shape – wir müssen ihm nur die Form (Dimensionen) der Eingabe auf der ersten Ebene angeben. Es ist (8,), da es ein Vektor aus 8 Merkmalen ist. Mit anderen Worten: 8 x 1.
- Dicht – um die Aktivierungsfunktion über ((w • x) + b anzuwenden). Das erste Argument in der dichten Funktion ist die Anzahl der versteckten Einheiten, ein Parameter, den man anpassen kann, um die Genauigkeit des Modells zu verbessern. Versteckte Einheiten sind, wie die Anzahl der versteckten Schichten, ein komplexes Thema, das nicht leicht zu verstehen oder zu erklären ist, aber eines, das wir getrost übergehen können. (Die Komplexität dieser beiden Themen ist der Grund, warum die meisten Leute sagen, dass die Arbeit mit neuronalen Netzen Kunst ist. Ein Mathematiker würde diesen Mangel an Strenge verspotten.)
    from keras.models import Sequential
from keras.layers import Dense

model = Sequential()

model.add(Dense(8, activation='relu', input_shape=(8,)))

model.add(Dense(8, activation='relu'))

model.add(Dense(1, activation='sigmoid'))
- Verlust – Das Ziel des neuronalen Netzwerks ist es, die Verlustfunktion zu minimieren, also die Differenz zwischen vorhergesagten und beobachteten Werten. Es gibt viele Funktionen, die wir verwenden können. Wir wählen binary_crossentropy , weil unsere Label-Daten binär sind: (1) diabetisch und (0) nicht diabetisch.
- Optimierer – Wir verwenden die Optimiererfunktion SGD, Stochastic Gradient Descent. Es ist ein Algorithmus, der entwickelt wurde, um die Verlustfunktion so schnell wie möglich zu minimieren. Es gibt noch andere.
- Epoche – bedeutet, wie oft das Modell ausgeführt werden soll. Denken Sie daran, dass es ein iterativer Prozess ist. Sie könnten zusätzliche Epochen hinzufügen, aber die Genauigkeit ändert sich möglicherweise nicht viel. Sie müssen es einfach versuchen und sehen.
- Metriken – bedeutet, welche Kennzahlen während der Ausführung angezeigt werden. Genauigkeit bedeutet, wie genau das sich entwickelnde Modell das Ergebnis vorhersagt.
- Batchgröße—n bedeutet, die Eingabedaten in n Chargen aufzuteilen und jede parallel zu verarbeiten.
- fit()—trainiert das Modell, das heißt, berechnet die Gewichte, Verzerrungen, Anzahl der Schichten usw.
    model.compile(loss='binary_crossentropy',
              optimizer='sgd',
              metrics=['accuracy'])

model.fit(X_train, y_train,epochs=4, batch_size=1, verbose=1)
Oben haben wir über den iterativen Prozess gesprochen, ein neuronales Netzwerk für Gewichte und Verzerrungen zu lösen. Das geschieht mit Epochen. Hier ist die Ausgabe, während diese ausgeführt werden. Wie Sie sehen, steigt die Genauigkeit schnell an und stabilisiert sich dann.
    Epoch 1/4
514/514 [==============================] - 2s 3ms/step - loss: 0.6016 - acc: 0.6790
Epoch 2/4
514/514 [==============================] - 1s 1ms/step - loss: 0.5118 - acc: 0.7588
Epoch 3/4
514/514 [==============================] - 1s 1ms/step - loss: 0.4755 - acc: 0.7782
Epoch 4/4
514/514 [==============================] - 1s 1ms/step - loss: 0.4597 - acc: 0.7802
Du kannst model.summary() verwenden, um einige Informationen auszudrucken.
Hier sind die Gewichte für jede von uns erwähnte Schicht.
Es sieht so aus:
    for layer in model.layers:
    weights = layer.get_weights()
Es sieht so aus:
    [array([[ 0.11246287,  0.64353085,  0.00519296, -0.3992814 ,  0.29071185,
         0.3010074 ,  0.21385622,  0.31609035],
       [ 0.6338699 ,  0.5349119 ,  0.11174025,
…
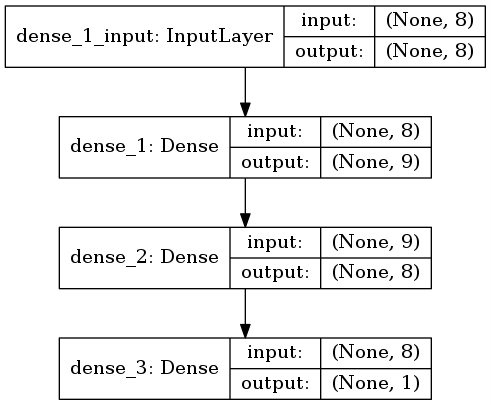
Wir können auch ein Bild der Schichten und ihrer Formen zeichnen. Das ist nicht sehr nützlich, aber schön zu sehen.
    from keras.utils import plot_model
plot_model(model, to_file='/tmp/model.png', show_shapes=True,)
Wie zu erwarten, ist die Form des Ausgangs 1, denn hier haben wir unsere Vorhersage:
Dann können wir Konfigurationsinformationen für jede Schicht mit layer.get_config und das Modell mit model.get_config() erhalten:
Jetzt können wir Vorhersagen auf Testdaten durchführen.
y_pred = model.predict_classes(X_test)
Das gibt die Partitur oder die Genauigkeit ab.
    score = model.evaluate(X_test, y_test,verbose=1)

print(score)
    254/254 [==============================] - 0s 46us/step
[0.5745944582571195, 0.7204724428221936]
Unser Vorhersagemodell ist also zu 72 % genau.
Wenn Sie die Diskussionen auf Data Camp lesen, sehen Sie, dass andere Analysten mit anderen Techniken etwas bessere Ergebnisse erzielt haben. Aber denken Sie an die Gefahr von Overfitting.
ML mit TensorFlow & Keras Guide
- TensorFlow vs. PyTorch: Die Wahl Ihres ML-Frameworks
- Einführung in TensorFlow und logistische Regression
- Verwendung von TensorFlow zur Erstellung eines neuronalen Netzwerks (mit Beispielen)
- Verwendung des TensorFlow-Neuralnetzwerks für maschinelle Lernvorhersagen mit TripAdvisor-Daten
- Wie die Keras-Maschinensprachen-API TensorFlow erleichtert
- Wie man Keras verwendet, um Klassifikationsprobleme mit einem neuronalen Netzwerk zu lösen
- Deep Learning Schritt-für-Schritt-Neuralnetz-Tutorial mit Keras
- Google Cloud TPUs für ML-Beschleunigung
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.