




Auf einen Blick: Die logarithmische Skala von Matplotlib verbessert die Datenvisualisierung, indem sie Werte über große Bereiche effektiv darstellt und kleine und große Zahlen interpretierbar macht. Durch die Verwendung von 10-Potenzen vermeidet sie die Kompression kleinerer Werte.
- Logarithmische Skalen sind unerlässlich, um umfangreiche Datenbereiche zu visualisieren.
- Codebeispiele zeigen, wie man logarithmische Skalen in Matplotlib-Diagrammen implementiert.
In diesem Artikel erklären wir, wie man die logarithmische Skala in Matplotlib verwendet.
Die logarithmische Skala ist nützlich, um Daten zu zeichnen, die sehr kleine und sehr große Zahlen enthalten, weil die Skala die Daten so darstellt, dass man alle Zahlen leicht sehen kann, ohne dass die kleinen Zahlen zu eng zusammengedrückt werden.
Logarithmen
Zuerst gehen wir ein wenig Mathematik aus der Oberstufe durch. Ein Logarithmus ist eine Möglichkeit, eine große Zahl klein erscheinen zu lassen, indem man sie als Zehnerpotenz betrachtet. Es gibt noch andere Logarithmusbasen außer 10, wie den natürlichen Logarithmus, der in der Mathematik verwendet wird und durch die Konstante e=2,718 gegeben wird.... Aber für unsere Zwecke verwenden wir Logarithmen mit Basis 10.
Kurz gesagt:
log10x = y bedeutet 10 erhöht auf Potenz y gleich x, d.h. 10 ** y = x. Log10100=2, weil 10**2 = 100 gilt.
Die logarithmische Skala in Matplotlib
Ein zweidimensionales Diagramm in Matplotlib hat eine y-Skala und eine x-Skala. Die Skala bezeichnet die Abstufungen oder Häkchen entlang einer Achse. Sie können eines von den folgenden Punkten sein:
- matplotlib.scale.LinearScale—Das sind einfach Zahlen wie 1, 2, 3.
- matplotlib.scale.LogScale – Das sind Potenzen von 10. Man könnte jede Basis verwenden, wie 2 oder den natürlichen Logarithmuswert, der durch die Zahl e gegeben wird. Die Verwendung verschiedener Basen würde den Abstand der geplotteten Elemente verengen oder erweitern, was die Sichtbarkeit erleichtert.
- matplotlib.scale.SymmetricalLogScale und matplotlib.scale.LogitScale—Diese werden für Zahlen kleiner als 1 verwendet, insbesondere für sehr kleine Zahlen, deren Logarithmen sehr große negative Zahlen sind.
Verwendung der logarithmischen Skala
Schauen wir uns die Einnahmen einiger großer und einiger kleiner Unternehmen an.
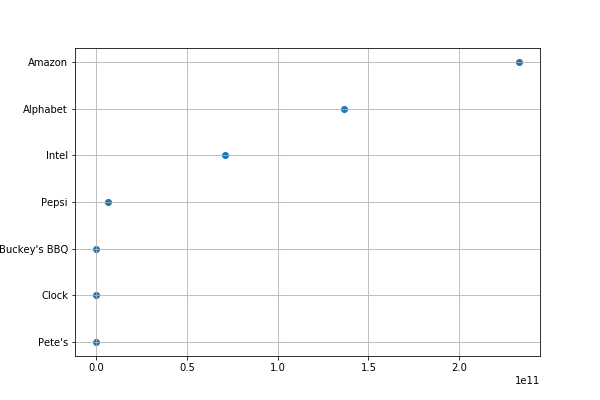
Amazon, Alphabet (Google) und Intel sind um ein Vielfaches größer als die kleinen Firmen Pete's, Clock und Buckey's BBQ (die wir uns ausgedacht haben). Der Unterschied zwischen ihnen im Vergleich zu Amazon ist enorm, sodass die Handlung jedes kleineren Unternehmens auf derselben vertikalen Linie 0 auf der linearen Skala liegt.
Matplotlib wählt die Skala für die Achsen, wenn man sie nicht explizit einstellt. Hier haben wir das nicht getan. Die kleine le11-Notation unten bedeutet, dass die Xachse in wissenschaftlicher Notation ist, was in diesem Fall bedeutet, dass der Umsatz ein Vielfaches von 10**11 (100 Milliarden US-Dollar) dargestellt wird. Amazons Umsatz von 232.887.000.000 US-Dollar beträgt 2,325*(10**11). Während Pete 600.000 Dollar als Potenz von 11 0,000006* (10**11) beträgt. Das erklärt, warum selbst Pepsi, ein großes Unternehmen, auf der untenstehenden Grafik nahe bei 0 liegt.
Deshalb beheben wir dieses Problem im nächsten Graphen mit der logarithmischen Skala. Siehe unten für eine Erklärung des Codes.
    import matplotlib.pyplot as plt
import numpy as np
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd

data = {
        "Pete's":           600000,
        "Clock":           1600000,
        "Buckey's BBQ":    2600000,
        "Pepsi":        6466000000,
        "Intel" :      70848000000,
        "Alphabet":    136819000000,
        "Amazon":      232887000000
        }

df = pd.DataFrame.from_dict(data,orient='index',columns=['Revenue'])
dg =pd.to_numeric(df['Revenue'])
dc = pd.Series(dg.index.values.tolist()).to_frame('Company')
dat = df.assign(Company=dc.values)

data = dat.sort_values(by=['Revenue'])

plt.scatter(data['Revenue'],data['Company'])
plt.grid()
plt.show()
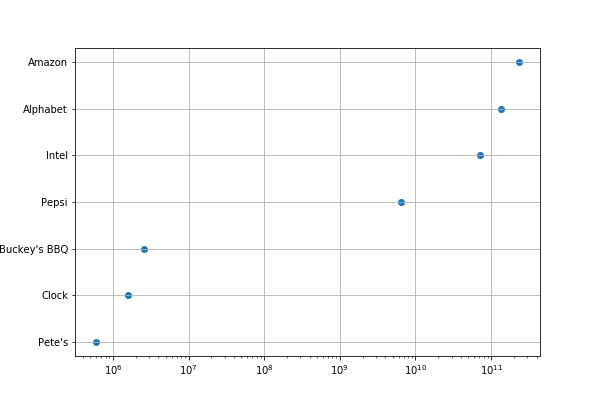
Hier ist alles gleich, außer dass wir plt.xscale("log") einbezogen haben. Jetzt können wir die Werte leichter erkennen, da sie Zehnerpotenzen sind. Petes kleiner Umsatz von 600.000 Dollar ist also leicht zu erkennen, da er 6*(10**6) ist. Und Amazons Einnahmen sind ungefähr 100.000 (10**5) mal so groß.
    import matplotlib.pyplot as plt
import numpy as np
import pandas as pd

data = {
        "Pete's":           600000,
        "Clock":           1600000,
        "Buckey's BBQ":    2600000,
        "Pepsi":        6466000000,
        "Intel" :      70848000000,
        "Alphabet":    136819000000,
        "Amazon":      232887000000
        }

df = pd.DataFrame.from_dict(data,orient='index',columns=['Revenue'])
dg =pd.to_numeric(df['Revenue'])
dc = pd.Series(dg.index.values.tolist()).to_frame('Company')
dat = df.assign(Company=dc.values)

data = dat.sort_values(by=['Revenue'])

plt.scatter(data['Revenue'],data['Company'])
plt.grid()
plt.xscale("log")
plt.show()
Jetzt kann man die Größe jedes Unternehmens anhand seines Umsatzes klarer erkennen
Erklärung des Codes
Ein Teil dieses Codes ist ohne Kenntnisse der Datenwissenschaft schwer verständlich, da er Pandas und NumPy verwendet. Das ist ironisch, da Pandas speziell entwickelt wurde, um die Arbeit mit Tabellendaten zu erleichtern.
Der erste Schritt nimmt die von uns erstellten Daten als Wörterbuch und wandelt sie in einen Pandas-Datenrahmen um. Der Index für diese Daten ist der Firmenname. Wir sagten orient='index' , das heißt, der erste Eintrag als Indexwert zu nehmen. Dann geben wir ihm einen Spaltennamen mit Spalten=['Umsatz']. Der Firmenname hat keinen Spaltennamen, weil es keine Spalte ist; es ist ein Zeilenindex.
df = pd.DataFrame.from_dict(data,orient='index',columns=['Revenue'])
Als Nächstes müssen wir die Erlössstränge in Zahlen umwandeln. Andernfalls werden sie nach Matplotlib als Buchstaben sortiert.
dg =pd.to_numeric(df['Revenue'])
Jetzt wollen wir eine Serie erstellen, das ist ein Dataframe mit nur einer Spalte. Die Werte sind der Index des vorherigen Dataframes. So werden die Unternehmen als Datenspalte, genannt Company, aufgeführt.
dc = pd.Series(dg.index.values.tolist()).to_frame('Company')
Als Nächstes fügen wir die Werte der gerade erstellten Reihen als eine weitere Spalte im dat-Dataframe hinzu.
dat = df.assign(Company=dc.values)
Dann zeichnen wir das Streudiagramm und geben ihm Datenrahmen für die x- und y-Werte. Jeder hat die gleiche Form, (7,), die man mit data['Revenue'].shape überprüfen kann. Form ist ein manchmal schwieriges NumPy-Konzept. Im Grunde bedeutet es die Dimension des Arrays. In einem xy-Plot müssen sie gleich sein.
plt.scatter(data['Revenue'],data['Company'])
Der Rest erklärt sich von selbst:
    plt.grid()
plt.xscale("log")
plt.show()
Leitfaden zur Datenvisualisierung
- Der Datenvisualisierungs-Anfängerleitfaden
- Einführung in Graphdatenbanken
- Anwendungsfälle für Graphdatenbanken
- Einführung in die Neo4j-Graphdatenbank
- Neo4j-Graphdatenbank-Abfragen
- Matplotlib-Streu- und Liniendiagramme erklärt
- Wie man Nebenhandlungen in Matplotlib hinzufügt
- Matplotlib-Logarithmische Skala
- Verwendung von Matplotlib zum Zeichnen von Diagrammen und Graphen
- Wie man 3D-Diagramme mit Matplotlib zeichnet
- Plotly Python Tutorial
- Ermöglichung der Bürgerdatenwissenschaftler
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.