




Auf einen Blick: Dieses Tutorial behandelt, wie man Pandas DataFrames gruppiert, verkettet und zusammenführt, wobei Parallelen zu SQL-Operationen gezogen werden. Zu den wichtigsten Funktionen gehören für die Konkatenation und merge() für das Verbinden von DataFrames durch bestimmte Spalten.
- Die Verkettung ähnelt einer äußeren Verbindung.
- Inner Joins identifizieren den Schnittpunkt von zwei DataFrames.
In diesem Tutorial zeigen wir, wie man Pandas DataFrames gruppiert, verkettet und zusammenführt. (Neu bei Pandas? Beginnen Sie mit unserer Pandas-Einführung oder erstellen Sie einen Pandas-Dataframe aus einem Wörterbuch.)
Diese Operationen ähneln sehr den SQL-Operationen in einer Zeilen- und Spaltendatenbank. Pandas ist schließlich eine Zeilen- und Spalten-In-Memory-Datenstruktur. Wenn Sie SQL-Programmierer sind, sind Sie mit all dem bereits vertraut. Die einzige Komplexität besteht darin, dass Sie zusätzlich zu Zeilen nach Spalten verbinden können.
Pandas verwendet die Funktion Verkettung – concat(), auch concat genannt. Aber es ist leichter zu verstehen, wenn man daran denkt, dass dies innere Joins (Schnittpunkte ) und äußere Joins (Union) von Mengen sind, so wie ich es unten bezeichne.
Verkettung (äußere Verbindung)
Man kann sich die Verkettung wie eine äußere Verbindung vorstellen. Das Ergebnis ist dasselbe.
Angenommen, wir haben die Datenrahmen A und B mit gemeinsamen Elementen unter den Indizes und Spalten.
Äußere Verbindung
Zusammenführung
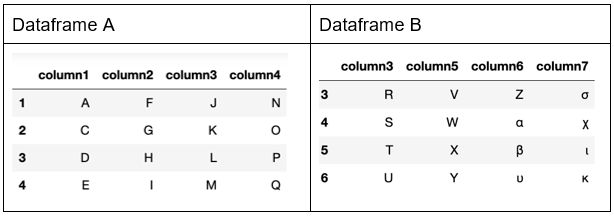
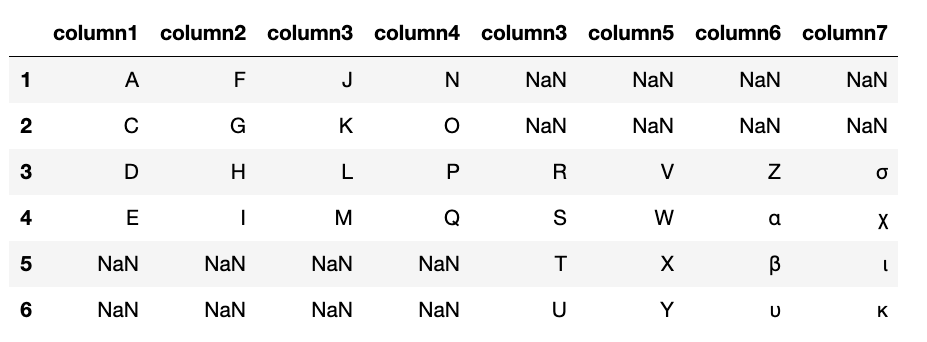
Jetzt verketten. Es ist kein Anhängen. (Dafür gibt es eine Funktion append().) Diese concat()-Operation erzeugt eine Obermenge beider Mengen a und b, kombiniert aber die gemeinsamen Zeilen. Sie ist auch kein innerer Join, da sie alle Zeilen auflistet, auch solche, für die es keinen gemeinsamen Index gibt.
Beachten Sie die fehlenden Werte NaN. Hier gibt es keine entsprechenden Dataframe-Indizes in Dataframe B mit dem Index in Dataframe A.
Zum Beispiel befindet sich Index 3 in beiden Dataframes. Pandas kopiert also die 4 Spalten vom ersten Dataframe und die 4 Spalten aus dem zweiten Dataframe in den neu konstruierten Dataframe. Ebenso befindet sich Index 5 in Dataframe B, aber nicht Dataframe A für die Spalten 1, 2 und 3. Diese Spalten sind also als fehlend markiert (NaN).
Ergebnisse in:
Anhängen
    a = pd.DataFrame({'column1': ['A', 'C', 'D', 'E'],

'column2': ['F', 'G', 'H', 'I'],

'column3': ['J', 'K', 'L', 'M'],

'column4': ['N', 'O', 'P', 'Q']},

index=[1,2,3,4])

b = pd.DataFrame({'column3': ['R', 'S', 'T', 'U'],

'column5': ['V', 'W', 'X', 'Y'],

'column6': ['Z', 'α', 'β', 'υ'],

'column7': ['σ', 'χ', 'ι', 'κ']},

index=[3,4,5,6])

result = pd.concat([a, b], axis=1)
Ergebnisse in:
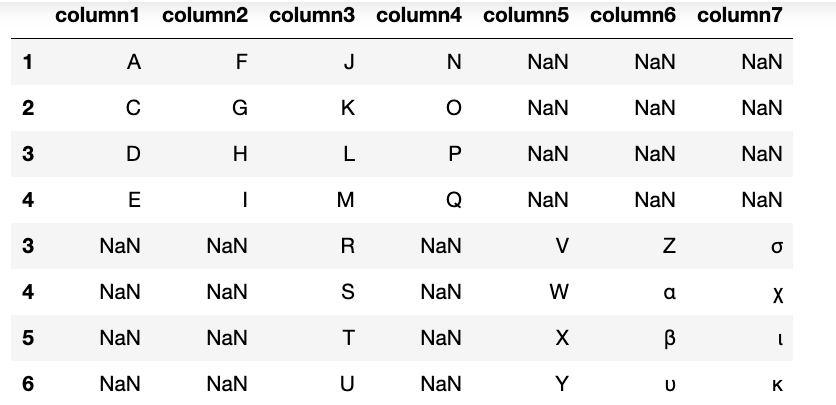
Hier machen wir einen äußeren Join, der in Bezug auf Mengen die Vereinigung zweier Mengen bedeutet. Also werden alle Zeilen addiert. Ein äußerer Join erzeugt hier nicht den Durchschnitt gemeinsamer Indizes. Aber für diejenigen, für die die Spalte nicht in der Menge aller Spalten existiert, ist der Wert NaN. Das muss der Fall sein, da nicht alle Spalten für alle Zeilen existieren. Man muss also alle auflisten, aber einige als leer markieren.
result = pd.concat([a, b], join='outer')
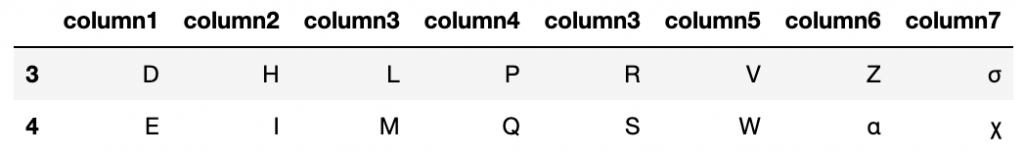
Innenverbindung entlang der 0-Achse (Reihe)
Wir können einen inneren Join per Index oder Spalte machen. Ein innerer Join findet den Durchschnitt zweier Mengen.
Lassen Sie uns entlang der 0-Achse (Zeile) joinen. Nur die Indizes 3 und 4 befinden sich in beiden Dataframes. Ein innerer Join nimmt also alle Spalten nur aus diesen beiden Zeilen.
result = pd.concat([a, b], axis=1,join='inner')
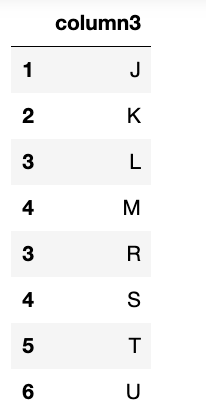
Innenverbindung entlang der 1. Achse (Säule)
Spalte 3 ist die einzige Spalte, die beiden Datenrahmen gemeinsam ist. Wir verketten also alle Zeilen von A mit den Zeilen in B und wählen nur die gemeinsame Spalte, also eine innere Verbindung entlang der Spaltenachse.
result = pd.concat([a, b], axis=0,join='inner')
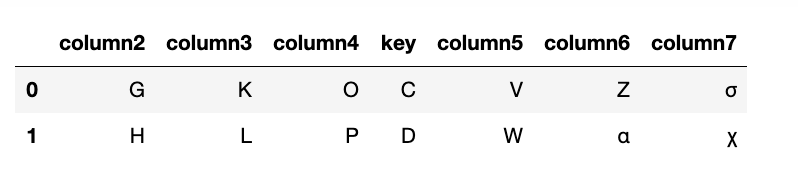
Ein Merge ist wie ein innerer Join, nur dass wir ihm sagen, in welcher Spalte er zusammenführen soll.
Hier machen wir den ersten Spaltennamen (also den Schlüsselwert im Wörterbuch) zu einem gebräuchlichen Namen "Schlüssel". Dann führen wir darauf zusammen.
    a = pd.DataFrame({'key': ['A', 'C', 'D', 'E'],

'column2': ['F', 'G', 'H', 'I'],

'column3': ['J', 'K', 'L', 'M'],

'column4': ['N', 'O', 'P', 'Q']},

index=[1,2,3,4])

b = pd.DataFrame({'key': ['C', 'D', 'T', 'U'],

'column5': ['V', 'W', 'X', 'Y'],

'column6': ['Z', 'α', 'β', 'υ'],

'column7': ['σ', 'χ', 'ι', 'κ']},

index=[3,4,5,6])

result=pd.merge(a, b, on='key')
Der resultierende Dataframe ist derjenige, der einen gemeinsamen Schlüsselwert aus dem Array-Schlüssel=[]hat. Du siehst, dass nur C und D für beide Datenframes gemeinsam sind.
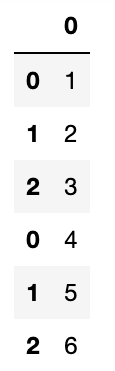
Dies fügt einfach einen Dataframe an einen anderen hinzu. Hier ist eine Serie, also ein DataFrame mit nur einer Spalte. Das Ergebnis ist, dass alle Zeilen aus Dataframe A zu Dataframe B hinzugefügt werden, um Dataframe C zu erstellen.
    import pandas as pd

a=pd.DataFrame([1,2,3])

b=pd.DataFrame([4,5,6])

c=a.append(b)

c
GroupBy
Hier ist eine weitere Operation, die SQL-Programmierern vertraut ist.
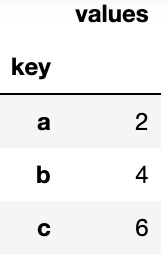
Die GroupBy-Operation erfolgt auf einem einzigen Datenrahmen. Wir gruppieren die Werte aus der Spalte namens Schlüssel und summieren sie.
    a=pd.DataFrame({"key": ["a", "b", "c","a", "b", "c"] ,

"values": [1,2,3,1,2,3]})

b=a.groupby("key").sum()

b
Verwandte Literatur
Pandas Guide
- Pandas-Einführung & Tutorials für Anfänger
- Pandas: Wie man CSV- und JSON-Dateien liest
- Wie man ein Pandas-Dataframe aus einem Wörterbuch erstellt
- Wie man Daten in Pandas gruppiert, verkettet und zusammenführt
- Pandas-Datentypen
- Umgang mit fehlenden Daten in Pandas: NaN-Werte erklärt
- NumPy-Einführung mit Beispielen
- Verwendung von StringIO, um getrennte Textdateien in NumPy zu lesen
- Verwendung der NumPy-Bincount-Statistikfunktion
- Top NumPy Statistische Funktionen & Verteilungen
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.