




Auf einen Blick: Anweisungen zur Verwendung von Pandas zum Einlesen von CSV- und JSON-Dateien in Dataframes unterstreichen die Effizienz bei der Datenverarbeitung. CSV-Dateien können direkt von einer URL mit pd.read_csv() gelesen werden, während JSON-Dateien zusätzliche Schritte erfordern, um verschachtelte Strukturen mit pd.read_json() zu parsen.
- CSV-Dateien können direkt von einer URL mit pd.read_csv() gelesen werden.
- JSON-Dateien erfordern zusätzliche Schritte, um verschachtelte Strukturen mit pd.read_json() zu parsen.
Hier zeigen wir, wie man CSV-Dateien und JSON-Dateien mit Pandas in einen Pandas-Dataframe lädt. (Ganz neu bei Pandas? Die Grundlagen finden Sie in unserer Pandas-Einleitung.) Das zeigt erneut, warum Pandas so leistungsstark ist. Es übernimmt die ganze schwere Arbeit beim Herunterladen einer Datei aus dem Internet, Öffnen, Durchschleifen, Parsen und Umwandeln in einen Dataframe. Und das in einer einzigen Codezeile. Das Jupyter-Notizbuch für diesen Code ist hier. Sie müssen Pandas per Pip installieren , falls Sie das noch nicht haben.
Wie man eine CSV-Datei mit Python Pandas liest
Pandas können eine URL direkt öffnen. Das bedeutet, du musst keine Datei herunterladen, um sie zu lesen. Im Folgenden lesen wir eine .csv-Datei:
    import pandas as pd

url = 'https://raw.githubusercontent.com/werowe/logisticRegressionBestModel/master/KidCreative.csv'

df = pd.read_csv(url, delimiter=',')
Dann schau dir oben darauf an:
df.head()
Die Ergebnisse sehen so aus. Wie Sie sehen können, hat es die Datei anhand des Trennzeichens geparst und die Spaltennamen aus der ersten Zeile der .csv-Datei hinzugefügt.

Wie man eine JSON-Datei mit Pandas liest
JSON ist etwas komplizierter, da das JSON tief verschachtelt ist. Pandas entwickelt das nicht automatisch für dich. Hier folgen wir dem gleichen Verfahren wie oben, nur verwenden wir pd.read_json() statt pd.read_csv(). Beachte, dass wir in diesem Beispiel die Parameterzeilen=True setzen, weil die Datei im JSONP-Format ist. Das bedeutet, dass es keine gültige JSON-Datei ist. Vielmehr handelt es sich um eine Datei mit mehreren JSON-Datensätzen, einer nach dem anderen.
    import pandas as pd

url = 'https://raw.githubusercontent.com/werowe/logisticRegressionBestModel/master/ct1.json'

dfct=pd.read_json(url,lines=True)
Schauen Sie sich nun den Dataframe an:
dfct.head()
Ergebnisse in:
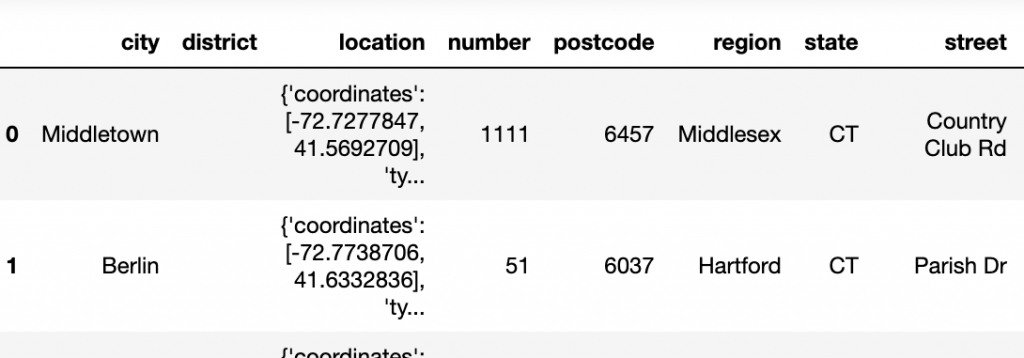
Beachte, dass Pandas das Standort-JSON-Objekt nicht entwickelt hat. Das Eingabe-JSON sieht so aus:
    {

            "state": "CT",
            "postcode": "06037",
            "street": "Parish Dr",
            "district": "",
            "unit": "",
            "location": {
                        "type": "Point",
                        "coordinates": [-72.7738706, 41.6332836]
            },
            "region": "Hartford",
            "number": "51",
            "city": "Berlin"
}
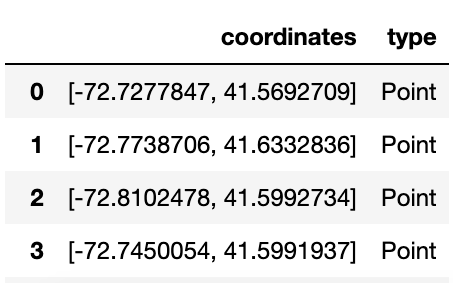
Wir brauchen also einen zusätzlichen Schritt. Wir verwandeln die Elemente in Position in eine Liste und erstellen daraus einen DataFrame
pd.DataFrame(list(dfct['location']))
Resultiert in einem neuen Datenrahmen mit Koordinate und Typ:
Verwandte Literatur
Pandas Guide
- Pandas-Einführung & Tutorials für Anfänger
- Pandas: Wie man CSV- und JSON-Dateien liest
- Wie man ein Pandas-Dataframe aus einem Wörterbuch erstellt
- Wie man Daten in Pandas gruppiert, verkettet und zusammenführt
- Pandas-Datentypen
- Umgang mit fehlenden Daten in Pandas: NaN-Werte erklärt
- NumPy-Einführung mit Beispielen
- Verwendung von StringIO, um getrennte Textdateien in NumPy zu lesen
- Verwendung der NumPy-Bincount-Statistikfunktion
- Top NumPy Statistische Funktionen & Verteilungen
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.