




Auf einen Blick: Eine Apache Spark Machine-Learning-Pipeline vereinfacht den Prozess der Datentransformation, des Modellanpassens und der Bewertung innerhalb eines einheitlichen Workflows und verbessert die Codeklarheit und Reproduzierbarkeit. Dieses Tutorial führt die Nutzer bei der Umwandlung gestuften Spark ML-Codes in ein strukturiertes Pipeline-Format für eine effiziente maschinelle Lernausführung.
- Das Pipeline-Objekt konsolidiert wesentliche Operationen: transformieren, anpassen und evaluieren.
- Ermöglicht eine verbesserte Wartbarkeit des Codes durch automatische Ausführungsreihenfolge.
Eine Apache Spark Machine-Learning-Pipeline ist ein Objekt, das Operationen mit org.apache.spark.ml.Pipeline in einen einzigen ausführbaren Workflow transformiert, evaluiert und einpasst. Anstatt jeden Datentransformationsschritt separat auf einem Dataframe auszuführen, definiert man alle Stufen einmal und lässt das Pipeline-Objekt sie in der Reihenfolge ausführen – was ML-Code sauberer, reproduzierbarer und leichter in die Produktion bringt.
Dieses Tutorial demonstriert das Konzept der maschinellen Lernpipeline von Apache Spark, indem bestehenden gestuften Spark ML-Code in ein Pipeline-Format umgewandelt wird. Der bestehende Code wird in zwei Blogbeiträgen erklärt: Teil eins und Teil zwei. Es wird empfohlen, diese zuerst zu lesen, da Sie sie benötigen, um die hier verwendeten Daten zu generieren. (Alternativ können Sie maintenance_data.csv sowohl als Test- als auch als Trainingsdaten verwenden, um vorzuspringen .)
Das Spark-Pipeline-Objekt ist org.apache.spark.ml.{ Pipeline, PipelineModel}.
Was ist eine Apache Spark Machine-Learning-Pipeline?
Im Allgemeinen beschreibt eine Machine-Learning-Pipeline den End-to-End-Prozess des Schreibens von Code, dessen Freigabe in die Produktion, das Extrahieren von Daten, das Erstellen von Trainingsmodellen und das Abstimmen des Algorithmus. In Apache Spark ist eine Pipeline speziell ein Objekt, das Transformation-, Evaluierungs- und Anpassungsschritte in ein Objekt einfügt: org.apache.spark.ml.Pipeline. Diese Schritte zusammen werden als Workflow bezeichnet.
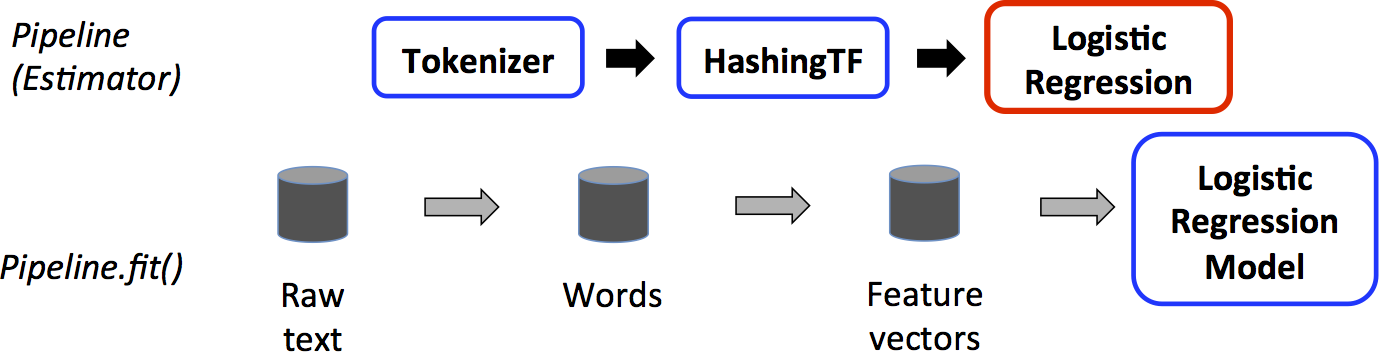
Die Apache Spark-Dokumentation veranschaulicht dies mit einer Grafik: Ausgehend von einem Rohdatenrahmen werden alle Transformationsschritte – zusammen mit dem ML-Algorithmus selbst – in das Pipeline-Objekt eingespeist, das sie in der angegebenen Reihenfolge ausführt.
Wie funktioniert das Spark-Pipeline-Objekt?
Das Apache Spark Pipeline-Objekt führt drei Arten von Operationen auf einem Dataframe aus:
- Transformieren – verändert einen Dataframe, zum Beispiel durch das Hinzufügen von Feature- oder Label-Spalten
- Fit – führt den Dataframe in den ML-Algorithmus ein und berechnet das Ergebnis, wodurch das trainierte Modell erstellt wird
- Bewerten – bewertet die Modellleistung
In der obigen Grafik wird der Dataframe erstellt, indem Daten aus Hadoop oder einer anderen Quelle gelesen werden. Die Operationen Transform () und fit() werden dann durchgeführt, um Feature- und Label-Spalten hinzuzufügen – das Format, das vom logistischen Regressions-ML-Algorithmus benötigt wird. Jeder dieser diskreten Schritte wird in das Pipeline-Objekt eingespeist.
Das Beispiel der Spark-Dokumentation veranschaulicht dies deutlich:
Jeder dieser drei Schritte wird vom Pipeline-Objekt über val pipeline = new Pipeline().setStages(Array(tokenizer, hashingTF, lr)) bearbeitet.
    val tokenizer = new Tokenizer()
  .setInputCol("text")
  .setOutputCol("words")
val hashingTF = new HashingTF()
  .setNumFeatures(1000)
  .setInputCol(tokenizer.getOutputCol)
  .setOutputCol("features")
val lr = new LogisticRegression()
  .setMaxIter(10)
  .setRegParam(0.001)
val pipeline = new Pipeline()
  .setStages(Array(tokenizer, hashingTF, lr))
Wie wandelt man gestuften Spark ML-Code in eine Pipeline um?
Um das mit einem funktionierenden Beispiel zu veranschaulichen: Der untenstehende Code schreibt die Programme aus den obigen Blogbeiträgen – ursprünglich zwei separate Programme (Modell erstellen / Vorhersagen machen) – zu einem kombinierten Programm um.
Hinweis: Die untenstehenden Codebeispiele wurden für Spark 1.x/2.x geschrieben. Einige APIs (wie com.databricks.spark.csv und SQLContext) wurden in späteren Spark-Versionen abgelöst, aber die Pipeline-Konzepte und -Struktur bleiben versionsübergreifend gültig.
Zunächst sollten die erforderlichen Importe berücksichtigt werden:
    import org.apache.spark.sql.SQLContext
import org.apache.spark.SparkConf
import org.apache.spark.SparkContext
import com.databricks.spark.csv
import org.apache.spark.ml.classification.LogisticRegression
import org.apache.spark.mllib.linalg.{Vector, Vectors}
import org.apache.spark.ml.evaluation.BinaryClassificationEvaluator
import org.apache.spark.ml.feature.{VectorAssembler, StringIndexer}
import org.apache.spark.ml.classification.LogisticRegressionModel
import org.apache.spark.ml.{Pipeline, PipelineModel}
import org.apache.spark.sql.Row
Altes Vorgehen: gestufte Operationen
    val df2 = assembler.transform(df)

val df3 = labelIndexer.fit(df2).transform(df2)

val model = new LogisticRegression().fit(df3)
Neuer Ansatz: Pipeline.setStages()
Anstatt Transform()-Operationen separat auszuführen , führen Sie VectorAssembler(), StringIndexer() und LogisticRegression() in die neue Pipeline().setStages(Array(assembler, labelIndexer, lr)) ein. Dann führen Sie pipeline.fit() auf dem ursprünglichen Dataframe aus. Die Pipeline führt jede Transformation in der von .setStages() definierten Reihenfolge aus.
    var file = "hdfs://localhost:9000/maintenance/maintenance_data.csv";

val sqlContext = new SQLContext(sc)

val df = sqlContext.read.format("com.databricks.spark.csv").option("header", "true").option("inferSchema", "true").option("delimiter",";").load(file)

val featureCols =  Array("lifetime", "pressureInd", "moistureInd", "temperatureInd")

val assembler = new VectorAssembler().setInputCols(featureCols).setOutputCol("features")

val labelIndexer = new StringIndexer().setInputCol("broken").setOutputCol("label")

val lr = new LogisticRegression()

val pipeline = new Pipeline().setStages(Array(assembler, labelIndexer, lr))

val model = pipeline.fit(df)
Wie trifft man Vorhersagen mit einem angepassten Spark PipelineModel?
Sobald die Apache Spark-Pipeline angepasst ist, ist das Vorhersagen unkompliziert. Das angepasste PipelineModel speichert bereits alle Transformationen. Lesen Sie die Testdaten (erstellt im Blogbeitrag Teil eins) ein und führen Sie Transform() darauf aus. Filtern Sie dann nach Maschinen, deren Wert der logistischen Regressionsvorhersage größer als 0 ist (d. h. gleich 1), um diejenigen zu identifizieren , die Wartung benötigen .
    var predictFile = "hdfs://localhost:9000/maintenance/2018.05.30.09.46.55.csv"

val testdf = sqlContext.read.format("com.databricks.spark.csv").option("header", "true").option("inferSchema", "true").option("delimiter",";").load(file)

val predictions =  model.transform(testdf)

predictions.select("team", "provider", "prediction").filter($"prediction" > 0).collect().foreach { case Row(team: String,provider: String, prediction: Double) =>
    println(s"($team, $provider, $prediction) --> team=$team, provider=$provider, prediction=$prediction")
  }
Die Ergebnisse sehen folgendermaßen aus:
    (TeamA, Provider4, 1.0) --> team=TeamA, provider=Provider4, prediction=1.0
(TeamC, Provider2, 1.0) --> team=TeamC, provider=Provider2, prediction=1.0
(TeamC, Provider4, 1.0) --> team=TeamC, provider=Provider4, prediction=1.0
(TeamB, Provider1, 1.0) --> team=TeamB, provider=Provider1, prediction=1.0
(TeamC, Provider2, 1.0) --> team=TeamC, provider=Provider2, prediction=1.0
(TeamB, Provider2, 1.0) --> team=TeamB, provider=Provider2, prediction=1.0
(TeamA, Provider2, 1.0) --> team=TeamA, provider=Provider2, prediction=1.0
Häufig gestellte Fragen zu Apache Spark Machine Learning Pipelines
Was ist der Unterschied zwischen einer Spark ML-Pipeline und dem manuellen Ausführen gestufter Operationen?
Ein gestufter Ansatz erfordert das manuelle Übergeben von Datenframes zwischen jedem Transformations- und Anpassungsschritt, was das Risiko von Ordnungsfehlern erhöht und den Code erschwert zu pflegen. Eine Apache Spark ML-Pipeline kapselt alle Schritte – einschließlich Feature Engineering und Model Fitting – in einem einzigen Pipeline-Objekt, das sie automatisch in der von .setStages() definierten Sequenz ausführt.
Was ist der Unterschied zwischen transform() und fit() in einer Apache Spark-Pipeline?
In einer Apache Spark ML-Pipeline modifiziert transform() einen Dataframe , indem Spalten wie Merkmalsvektoren oder Labels hinzugefügt werden. fit() führt den Dataframe in den ML-Algorithmus ein und liefert ein trainiertes Modell zurück. Beide können als Stufen im Pipeline-Objekt definiert und gemeinsam über pipeline.fit() ausgeführt werden.
Was macht Pipeline.setStages() in Apache Spark?
Pipeline.setStages() definiert die geordnete Sequenz von Transformatoren und Schätzern, die die Pipeline ausführen wird. Das Pipeline-Objekt führt jede Stufe im Array in der angegebenen Reihenfolge aus und übergibt das Ausgangsdatenframe jeder Stufe als Eingabe an die nächste.
Kann ein angepasstes Spark PipelineModel für Vorhersagen neuer Daten wiederverwendet werden?
Ja. Nach dem Training über pipeline.fit() speichert das resultierende PipelineModel alle angepassten Transformatoren und den trainierten Schätzer. Das Aufrufen von model.transform(testdf) auf einem neuen Dataframe wendet alle Pipeline-Stufen automatisch an – es ist nicht nötig, die Transformationsschritte neu zu definieren oder auszuführen.
Welche Importe sind erforderlich , um das Spark-Pipeline-Objekt in Scala zu verwenden?
Mindestens erfordert die Verwendung des Apache Spark Pipeline-Objekts den import org.apache.spark.ml. {Pipeline, PipelineModel}. Je nach verwendeten Transformern und Schätzern werden zusätzliche Importe wie VectorAssembler, StringIndexer und LogisticRegression aus dem org.apache.spark.ml-Paket benötigt.
Die in diesem Beitrag geäußerten Ansichten und Meinungen sind die des Autors und spiegeln nicht unbedingt die offizielle Position von BMC wider.
Apache Spark Leitfaden
- Apache Sparks maschinelle Lernpipeline: Eine Einführung
- SGD-Beispiel für lineare Regression mit Apache Spark
- Spark Decision Tree Klassifikator
- Mit logistischer Regression, Scala und Spark
- Wie man Jupyter-Notizbücher mit Apache Spark verwendet
- Verwendung von Python und Spark Machine Learning zur Klassifikation
- Wie man Spark UDFs (benutzerdefinierte Funktionen) in Python schreibt
- Python Spark ML K-Means Beispiel
- Wie man maschinelles Lernen auf die Cybersicherheit anwendet
- Apache Spark: Zusammenarbeit mit Streams
- K-bedeutet Clustering mit Apache Spark
- Spark mit Hive verwenden
- Wie man Apache Spark verwendet, um Vorhersagen für die vorbeugende Wartung zu treffen.
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.