




Auf einen Blick: Lernen Sie, wie Sie den Spark Decision Tree Classifier verwenden, um den Kraftstoffverbrauch anhand von Fahrzeugmerkmalen vorherzusagen, anhand von Scala und Daten der University of Pennsylvania. Das Tutorial enthält einen umfassenden Überblick über die Klassifikation des Entscheidungsbaums sowie praktische Scala-Beispiele.
- Veranschaulicht die Anwendung von Apache Spark ML zur Klassifikation des Entscheidungsbaums.
- Bietet Scala-Code- und Datenverarbeitungsschritte für ein besseres Verständnis.
Hier erklären wir, wie man den Decision Tree Classifier mit Apache Spark ML (maschinelles Lernen) verwendet. Wir verwenden Daten von der University of Pennsylvania hier und hier. Wir schreiben die Lösung in Scala-Code und führen den Leser durch jede Codezeile.
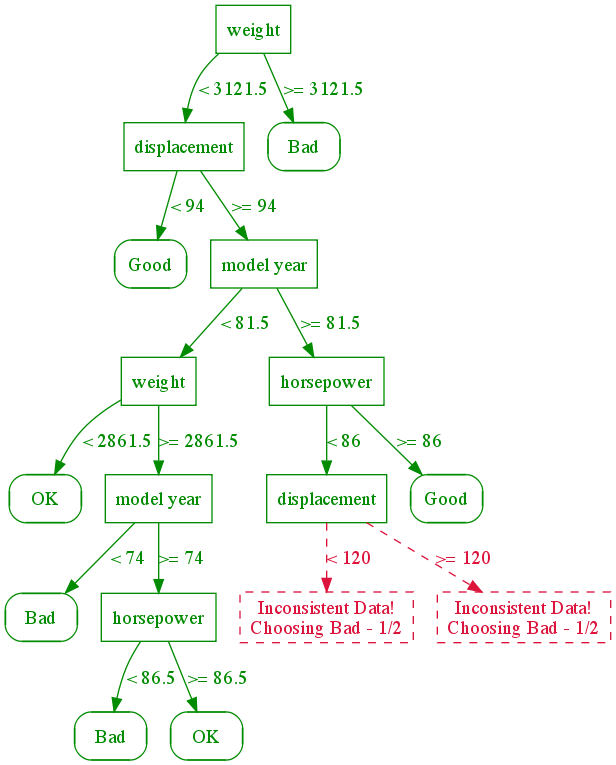
Lesen Sie den mathematischen Teil der Vorlesungsnotizen von Penn nicht, es sei denn, Sie können viel Mathematik. Solche Kenntnisse sind hier nicht notwendig. Stattdessen gibt Ihnen diese folgende Grafik alles, was Sie brauchen, um die Grundidee zu verstehen:
Das Ziel ist es, Autos zu betrachten und den Kraftstoffverbrauch vorherzusagen. Der Verbrauch ist entweder schlecht (0), gut (1) oder okay (2) basierend auf Zylinderzahl, Hubraum, PS, Gewicht, Beschleunigungszeit auf 100 km/h, Modelljahr und Herkunftskontinent. Unter dem Diagramm sind die Daten in Tabellenkalkulation mit Text zu sehen, darunter wird der Text in Zahlen umgewandelt.
Das untenstehende Diagramm beschreibt, wie der Entscheidungsbaum funktioniert. Zuerst schaut man sich das Gewicht an. Wenn es schwer ist, ist der Verbrauch schlecht. Wenn es nicht schwer ist und der Hubraum hoch ist, muss man auf das Modelljahr schauen. Man teilt dieses Problem immer wieder, bis man an einen Punkt kommt, an dem es logisch keinen Sinn mehr macht, weiterzugehen. Offensichtlich kann man, wenn ein Auto sehr viel wiegt, sofort sagen, dass der Verbrauch schlecht sein wird.
Hier sind die Daten mit Spaltenüberschriften.
| Mpg | Zylinder | Verdrängung | PS | Gewicht | Beschleunigung | Modelyear | Hersteller |
|---|---|---|---|---|---|---|---|
| Schlecht | 8 | 350 | 150 | 4699 | 14.5 | 74 | Amerika |
| Schlecht | 8 | 400 | 170 | 4746 | 12 | 71 | Amerika |
| Schlecht | 8 | 400 | 175 | 4385 | 12 | 72 | Amerika |
| Schlecht | 6 | 250 | 72 | 3158 | 19.5 | 75 | Amerika |
| OK | 4 | 121 | 98 | 2945 | 14.5 | 75 | Asien |
| OK | 6 | 232 | 90 | 3085 | 17.6 | 76 | Amerika |
| OK | 4 | 120 | 97 | 2506 | 14.5 | 72 | Europa |
Und hier wird es in numerisches Format umgewandelt, damit wir es mit dem ML-Algorithmus verwenden können. Laden Sie diese Daten hier herunter und speichern Sie sie auf Ihrem Laufwerk oder legen Sie sie in Hadoop ein.
0 8 350 150 4699 14,5 74 0
0 8 400 170 4746 12 71 0
0 8 400 175 4385 12 72 0
0 6 250 72 3158 19,5 75 0
0 8 304 150 3892 12,5 72 0
0 8 350 145 4440 14 75 0
0 6 250 105 3897 18,5 75 0
0 6 163 133 3410 15,8 78 1
0 8 260 110 4060 19 77 0
1 4 97 75 2171 16 75 2
1 4 97 78 1940 14.5 77 1
1 4 98 83 2219 16.5 74 1
2 4 79 70 2074 19.5 71 1
2 4 91 68 1970 17.6 82 2
2 4 89 71 1925 14 79 1
2 4 83 61 2003 19 74 2
Scala Code
Starte Spark-Shell oder erstelle ein Zeppelin-Notizbuch und füge den Code unten ein.
Ergebnisse:
    import org.apache.spark.mllib.tree.DecisionTree
import org.apache.spark.mllib.tree.model.DecisionTreeModel
import org.apache.spark.mllib.util.MLUtils
import org.apache.spark.mllib.linalg.Vectors
import org.apache.spark.mllib.regression.LabeledPoint
import org.apache.spark.mllib.feature.Normalizer
// read the data file and split it by spaces
val data = sc.textFile("/home/walker/mileage.txt").map( l => l.split("\\s+"))
// convert every string to doubles
var dbl = data.map (m => m.map(l => l.toDouble))
// Here we create a Dense Vector and LabeledPoint. A Dense Vector is a
// special kind of Vector than the scala regular Vector. So use Vectors, with an “s”
// at the end. The values must be doubles. A Dense Vector cannot handle
// blank values. If we had that those, we would use a Sparse Vector.
//
// The LabeledPoint is an object with the label and features. The label
// is 0, 1, 2 or gas mileage and the features are the weight, year, etc.
val parsedData = dbl.map { y =>
val c = Vectors.dense(y(1),y(2),y(3),y(4),y(5),y(6),y(7))
LabeledPoint(y(0), c)
}.cache()
// numClasses means number of classifications. In this case it is
// 0, 1, or 2
val numClasses = 3
// Here we say that the 6th feature is categorical with 3 possible values.
// It can be American, European, or Asian.
// The rest of the values are continuous, meaning just numbers and not discrete
// values.
val categoricalFeaturesInfo = Map(6 -> 3)
val impurity = "gini"
val maxDepth = 9
val maxBins = 7
// Now feed the data into the model.
val model = DecisionTree.trainClassifier(parsedData, numClasses, categoricalFeaturesInfo , impurity, maxDepth, maxBins)
// Print out the results
println("Learned classification tree model:\n" + model.toDebugString)
DecisionTreeModel-Klassifikator mit Tiefe 5 und 21 Knoten
Hier steht, dass wir 21 Knoten (untere Endpunkte) und 5 Entscheidungsebenen zu treffen haben. Wenn zum Beispiel Merkmal 3 (Gewicht) [Wir beginnen mit der Nummerierung 0.] <= 2930 ist, dann müssen wir Merkmal 1 (Verschiebung usw.) betrachten, um unsere Vorhersage von 0, 1, 2 abzuleiten.
    If (feature 3 <= 2930.0)
If (feature 1 <= 91.0)
Predict: 2.0
Else (feature 1 > 91.0)
If (feature 5 <= 81.0)
If (feature 2 <= 105.0)
Predict: 1.0
Else (feature 2 > 105.0)
If (feature 0 <= 4.0)
Predict: 0.0
Else (feature 0 > 4.0)
Predict: 1.0
Else (feature 5 > 81.0)
If (feature 2 <= 85.0)
Predict: 0.0
Else (feature 2 > 85.0)
Predict: 2.0
Else (feature 3 > 2930.0)
If (feature 3 <= 3193.0)
If (feature 2 <= 85.0)
Predict: 0.0
Else (feature 2 > 85.0)
If (feature 2 <= 105.0)
If (feature 0 <= 4.0)
Predict: 1.0
Else (feature 0 > 4.0)
Predict: 0.0
Else (feature 2 > 105.0)
Predict: 0.0
Else (feature 3 > 3193.0)
Predict: 0.0
Wir speichern dann dieses Modell und verwenden die Predict()-Methode, um ein bestimmtes Fahrzeug zu überholen und so vorherzusagen, wie viel Kilometer es haben wird.
Vielleicht ist Ihnen aufgefallen, dass diese Art von Modell der logistischen Regression ähnelt. Aber wir verwenden Entscheidungsbäume (es gibt mehrere Typen), wenn wir viel Daten verarbeiten wollen, da es rechenintensiver ist. Mit anderen Worten, es läuft schneller und verbraucht weniger Speicher.
Beachten Sie auch, dass die Penn-Vorlesung das Matlab-Mathematik- und Statistikprogrammierwerkzeug verwendet hat. Aber solche Tools können mit Big Data nicht funktionieren. Sie skalieren nicht wie Apache Spark auf Millionen von Entscheidungen oder mehr.
Apache Spark Leitfaden
- Apache Sparks maschinelle Lernpipeline: Eine Einführung
- SGD-Beispiel für lineare Regression mit Apache Spark
- Spark Decision Tree Klassifikator
- Mit logistischer Regression, Scala und Spark
- Wie man Jupyter-Notizbücher mit Apache Spark verwendet
- Verwendung von Python und Spark Machine Learning zur Klassifikation
- Wie man Spark UDFs (benutzerdefinierte Funktionen) in Python schreibt
- Python Spark ML K-Means Beispiel
- Wie man maschinelles Lernen auf die Cybersicherheit anwendet
- Apache Spark: Zusammenarbeit mit Streams
- K-bedeutet Clustering mit Apache Spark
- Spark mit Hive verwenden
- Wie man Apache Spark verwendet, um Vorhersagen für die vorbeugende Wartung zu treffen.
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.