




Auf einen Blick: Apache Spark ermöglicht die Echtzeitverarbeitung von Streaming-Daten mit DStreams und wandelt kontinuierliche Eingaben in reguläre RDDs um. Dieser Leitfaden zeigt das Lesen von Aktienkursen in Python und Scala und hebt die Unterschiede zwischen Batch- und Streaming-Daten hervor.
- Streaming von Daten ermöglicht die sofortige Verarbeitung unbeschränkter Eingaben.
- Beispiele hierfür sind die Nutzung der Yahoo Finance API zur Aktienkursabfindung.
In den letzten beiden Beiträgen, die wir geschrieben haben, haben wir erklärt, wie man Daten, die von Twitter in Apache Spark strömen, über Kafka lesen kann. Hier betrachten wir ein einfacheres Beispiel für das Lesen einer Textdatei in Spark als Stream.
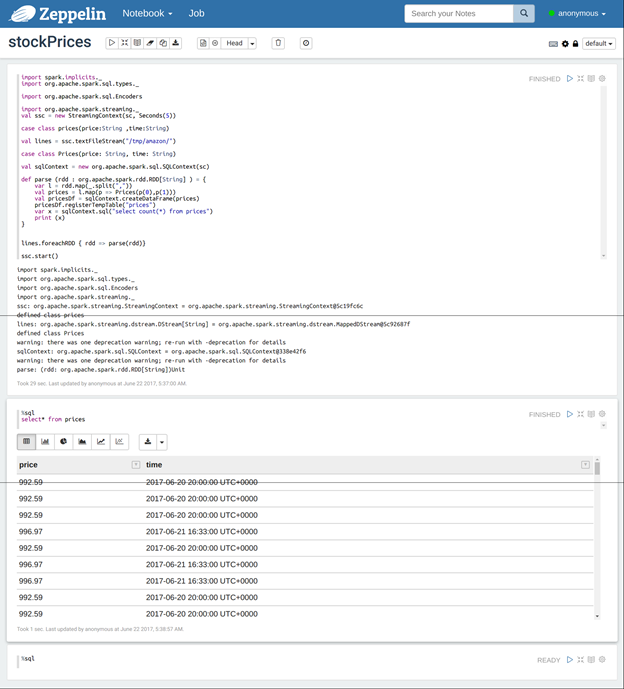
Wir erstellen einen einfachen Aktienticker, der wie der untenstehende Bildschirm aussieht, wenn wir den Code in Zeppelin ausführen.
Die Arbeit mit Streaming-Daten unterscheidet sich stark vom Batch-Daten. Spark Streaming liest stromende Daten in ein Objekt namens DStreams. Daraus erstellt es regelmäßig reguläre RDDs.
Es ist also wie die Arbeit mit RDDs, mit dem wichtigen Unterschied, dass die Eingabe keine Datei mit fester Größe ist. Stattdessen handelt es sich um einen unbegrenzten Strom, wie Twitter-Tweets, diagnostische Informationen von einem Jettriebwerk, Aktienkurse vom NASDAQ usw.
Wir werden das Beispiel mit dem Aktienkurs zur Veranschaulichung verwenden. Wir werden die Yahoo Finance API verwenden. Installieren Sie sie mit:
sudo pip install yahoo-finance
Dann:
mkdir /tmp/amazon/
Kopiere diesen Python-Code in eine Textdatei yahoo.py und führe sie aus:
Python yahoo.py
Das lädt den Amazon-Aktienkurs herunter und schreibt ihn alle fünf Sekunden in eine Datei.
    from yahoo_finance import Share
import time
f = open('/tmp/amazon/amzn.csv', 'w')
while True:
amzn=Share("AMZN")
s = amzn.get_price() + "," + amzn.get_trade_datetime() + '\n'
print (s)
f.write (s)
f.flush()
time.sleep(5)
del amzn
Im Folgenden finden Sie das gesamte Scala-Programm, das wir verwenden werden, um diese Daten als Strom zu verarbeiten. Es ist nur ein einfaches Beispiel. Sie werden Streaming-Daten eher verarbeiten, indem Sie sie zuerst in Kafka schreiben, wie wir es beim Twitter-Beispiel getan haben. Aber dieses einfache Beispiel hilft Ihnen zu verstehen, wie man mit Streaming-Daten arbeitet.
Spark Streaming verarbeitet Textdateien tatsächlich nicht besonders gut, wie wir sehen werden. Im Folgenden erklären wir, dass es keine Änderungen an einer Textdatei nachverfolgen kann. Deshalb müssen wir diese Dateien in einen neuen Ordner kopieren, damit Spark die Änderungen erkennt. Das ist für eine Streaming-Anwendung nicht sehr praktisch. Aber auch das ist nur ein Lehrbeispiel. Man verwendet eher Kafka oder liest eine Datasocket, als eine Textdatei zu verarbeiten. Allerdings wäre dieser Code geeignet für Situationen, in denen eine Anwendung Logdateien wie einen Webserver oder LDAP-Server überführt. Denn dort schließt sie die offene Datei regelmäßig und erstellt eine neue.
Nachdem du das oben beschriebene Python-Programm gestartet hast, starte Spark-Shell und poste den gesamten Code unten in den Spark-Kommandozeilen-Interpreter. Du wirst sehen, dass es ein paar Minuten dauert, bis es zu funktionieren ist. Dann übernimmt es den Bildschirm und beginnt, die Ausgabe zu echoen.
Hier unterteilen wir den Code in Abschnitte, um wichtige Teile zu erklären.
Scala-Code
Die wichtigsten Befehle hier sind das neue StreamingContext und ssc.textFileStream.
Das erste nimmt den SparkContext (bei Verwendung von Spark-Shell als sc) und erstellt einen StreamingContext. Es ist die gleiche Idee wie SparkContext, nur dass es für das Streaming von Daten gedacht ist.
ssc.textFileStream schaut in den angegebenen Ordner und liest diese Daten in DStreams ein, ohne Rücksicht auf irgendein Format. Es liest also nur Bytes an Informationen, auf denen wir noch keine RDDs oder andere Strukturen erstellt haben.
    import spark.implicits._
import org.apache.spark.sql.types._
import org.apache.spark.sql.Encoders
import org.apache.spark.streaming._
val ssc = new StreamingContext(sc, Seconds(5))
val lines = ssc.textFileStream("/tmp/amazon/")
Das Python-Programm schreibt den Aktienkurs und die Zeit in die Textdatei in diesem komma-begrenzten Format:
992.59,2017-06-20 20:00:00 UTC+0000
992.59,2017-06-20 20:00:00 UTC+0000
992.59,2017-06-20 20:00:00 UTC+0000
992.59,2017-06-20 20:00:00 UTC+0000
Der nächste Abschnitt ist vertraut aussehender Code, den wir verwenden, um jede Zeile in dieser Art von Textdatei zu lesen und jede Zeile mit rdd.map nach dem Komma zu teilen. Es gibt jedoch keinen nennenswerten Unterschied, nämlich dass Spark mehrere RDDs erstellt, wenn man mit stromenden Daten arbeitet. Deshalb haben wir die Funktionsparse mit dem Parametertyp org.apache.spark.rdd.RDD[String] geschrieben, sodass lines.foreachRDD { rdd => parse(rdd)} , wie unten gezeigt, jede RDD verarbeitet.
Mit anderen Worten, hier ist der entscheidende Unterschied. Spark liefert eine ganze Reihe von RDDs zurück und wir verwenden dstream.foreachRDD, um jeden von ihnen zu verarbeiten.
Der Rest des Codes erstellt eine Fallklasse , damit wir sie mit sqlContext.createDataFrame in einen SQL-Dataframe umwandeln können.
    case class Prices(price: String, time: String)
val sqlContext = new org.apache.spark.sql.SQLContext(sc)
def parse (rdd : org.apache.spark.rdd.RDD[String] ) = {
var l = rdd.map(_.split(","))
val prices = l.map(p => Prices(p(0),p(1)))
val pricesDf = sqlContext.createDataFrame(prices)
pricesDf.registerTempTable("prices")
pricesDf.show()
var x = sqlContext.sql("select count(*) from prices")
println (x)
}
Wir rufen die Funktionsparse für jedes erstellte rdd auf, wie unten gezeigt.
lines.print() spiegelt die ersten 10 Zeilen des RDD im Rohformat wider.
Im Kommandozeilen-Interpreter passiert nichts, bis wir ssc.start() ausführen. Dann sucht das Programm kontinuierlich nach neuen Dateien, die zu /tmp/amazon hinzugefügt wurden, und verarbeitet jede von ihnen. Es nimmt keine Eingaben mehr von der Tastatur an und bringt Ergebnisse auf den Bildschirm zurück.
    lines.foreachRDD { rdd => parse(rdd)}
lines.print()
ssc.start()
Wenn du diesen Code ausführst, warte ein paar Sekunden, da es eine Weile dauert, bis er startet.
Anfangs wird das Programm die gefundenen Daten wiederholen, weil wir pricesDf.show() verwendet haben.
+------+-------------------------------+ |price|time| +------+-------------------------------+ |992.59|2017-06-20 20:00:...| |992.59|2017-06-20 20:00:...| |992.59|2017-06-20 20:00:...| |992.59|2017-06-20 20:00:...| |992.59|2017-06-20 20:00:...| |992.59|2017-06-20 20:00:...| |996.97|2017-06-21 16:33:...|
Hier wird es seltsam, denn die zweite Iteration zeigt einen leeren Datenrahmen. Warum ist das so?
+-------+-------+
|Preis |Zeit|
+-------+-------+
+-------+-------+
Der Grund, warum der Datenrahmen leer ist, obwohl das Python-Programm noch Daten schreibt, lässt sich am besten durch die JavaDoc-Definition des textFileStream von Apache Spark verstehen.
public JavaDStream<String> textFileStream(String directory)
Erstellen Sie einen Eingabestrom, der ein Hadoop-kompatibles Dateisystem für neue Dateien überwacht und diese als Textdateien liest (mit Schlüssel als LongWritable, Wert als Text und Eingabeformat als TextInputFormat). Dateien müssen in das überwachte Verzeichnis geschrieben werden, indem sie von einem anderen Ort im selben Dateisystem "verschoben werden". Dateinamen, die mit beginnen. werden ignoriert.
Mit anderen Worten: Neue Daten werden erst gefunden, wenn du eine neue Datei manuell in den /tmp/amazon-Ordner kopierst. Das ist umständlich und etwas, das du mit einem Shell-Skript machen könntest. Du kannst das manuell versuchen, indem du die Datei /tmp/amazon/amzn.csv auf /tmp/amazon/a kopierst und dann die Ausgabe von spark-shell erneut ansiehst. Du wirst sehen, dass die neuen Daten aufgenommen werden.
Deshalb haben wir Ihnen ein Beispiel gegeben, wie man mit Streaming-Daten mit Apache Spark arbeitet. Von hier aus empfehlen wir, das Twitter-Beispiel noch einmal zu überprüfen, um das Gelernte zu verstärken. Oder schreiben Sie Ihr eigenes Beispiel mit einem TCP-Socket.
Apache Spark Leitfaden
- Apache Sparks maschinelle Lernpipeline: Eine Einführung
- SGD-Beispiel für lineare Regression mit Apache Spark
- Spark Decision Tree Klassifikator
- Mit logistischer Regression, Scala und Spark
- Wie man Jupyter-Notizbücher mit Apache Spark verwendet
- Verwendung von Python und Spark Machine Learning zur Klassifikation
- Wie man Spark UDFs (benutzerdefinierte Funktionen) in Python schreibt
- Python Spark ML K-Means Beispiel
- Wie man maschinelles Lernen auf die Cybersicherheit anwendet
- Apache Spark: Zusammenarbeit mit Streams
- K-bedeutet Clustering mit Apache Spark
- Spark mit Hive verwenden
- Wie man Apache Spark verwendet, um Vorhersagen für die vorbeugende Wartung zu treffen.
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.