




Auf einen Blick: Die Nutzung von Apache Spark mit Hive verbessert die Datenverarbeitungsgeschwindigkeit, indem die In-Memory-Funktionen von Spark genutzt werden. Der Leitfaden enthält Installationsvoraussetzungen, Konfigurationsschritte und Anweisungen zur Ausführung von Hive-Jobs auf Spark.
- Voraussetzungen umfassen die Installation von Hive und Spark sowie das Setzen von Umweltvariablen.
- Die Anweisungen umfassen das Verlinken von JAR-Dateien, das Starten von Spark und das Ausführen von Hive-Befehlen.
Hier erklären wir, wie man Apache Spark mit Hive verwendet. Das bedeutet, statt dass Hive Daten in Hadoop speichert, speichert es sie in Spark. Der Grund, warum Leute Spark statt Hadoop verwenden, ist, dass es eine reine Speicherdatenbank ist. Daher laufen Hive-Jobs dort viel schneller. Außerdem bewegen sich Programmierer dadurch dazu, eine gemeinsame Datenbank zu verwenden, wenn dein Unternehmen überwiegend Spark betreibt. Es ist auch möglich, Programme in Spark zu schreiben und diese zu nutzen, um mit Hive-Daten zu verbinden, also in die entgegengesetzte Richtung zu gehen. Das ist jedoch kein sehr wahrscheinlicher Anwendungsfall, denn wenn du Spark nutzt, hast du bereits die Vorstellung akzeptiert, RDDs (Spark In-Memory Storage) statt Hadoop zu verwenden. Jedenfalls besprechen wir hier die erste Option.
Voraussetzungen und Installation
- Du musst Hive installieren.
- Installiere Apache Spark aus dem Quellcode (wir erklären es unten), damit du eine Version von Spark ohne bereits enthaltene Hive-Jars haben kannst.
- Stelle HIVE_HOME und SPARK_HOME entsprechend.
- Installiere Hadoop. Wir verwenden es nur, außer dass der Yarn-Resource Scheduler vorhanden ist und JAR-Dateien gespeichert werden. Aber Hadoop muss nicht laufen, um Spark mit Hive zu nutzen. Wenn du jedoch einen Hive- oder Spark-Cluster betreibst, kannst du Hadoop verwenden, um JAR-Dateien an die Worker-Nodes zu verteilen, indem du sie in das HDFS (Hadoop Distributed File System) kopierst.
Die Anleitung hier gilt für Spark 2.2.0 und Hive 2.3.0. Tausche einfach die Verzeichnis- und JAR-Dateinamen unten, damit sie zu den Versionen passen, die du verwendest. Beachte, dass es bei der Suche nach den JAR-Dateien in Spark in mehreren Fällen mehr als eine Kopie gibt. Nutze die Dateien im DIST-Ordner wie unten gezeigt.) Zuerst musst du den Spark-Quellcode herunterladen. Dann kompilierst du ihn folgendermaßen:
./dev/make-distribution.sh --name "hadoop2-without-hive" --tgz "-Pyarn,hadoop-provided,hadoop-2.7,parquet-provided"
Nächstes Update /usr/share/spark/spark-2.2.0/conf/spark-env.sh und füge hinzu:
export SPARK_DIST_CLASSPATH=$(hadoop classpath)
Link Jar-Dateien
Jetzt erstellen wir weiche Links zu bestimmten Spark-Jar-Dateien, damit Hive sie finden kann:
    ln -s /usr/share/spark/spark-2.2.0/dist/jars/spark-network-common_2.11-2.2.0.jar /usr/local/hive/apache-hive-2.3.0-bin/lib/spark-network-common_2.11-2.2.0.jar
ln -s /usr/share/spark/spark-2.2.0/dist/jars/spark-core_2.11-2.2.0.jar /usr/local/hive/apache-hive-2.3.0-bin/lib/spark-core_2.11-2.2.0.jar
ln -s /usr/share/spark/spark-2.2.0/dist/jars/scala-library-2.11.8.jar /usr/local/hive/apache-hive-2.3.0-bin/lib/scala-library-2.11.8.jar
Starte Spark Master und Worker:
Jetzt fang an, Spark.
$SPARK_HOME/sbin/start-all.sh
Erstellen Sie ein Verzeichnis, das Logdateien enthält:
mkdir /var/log/spark
Bearbeitung $HIVE_HOME/conf/hive-site.xml:
    hive.execution.engine
spark


spark.master
spark://(your IP address):7077


spark.eventLog.enabled
true


spark.eventLog.dir
/var/log/spark


spark.executor.memory
2048m


spark.serializer
org.apache.spark.serializer.KryoSerializer
Run Hive
Führen Sie nun Hive wie unten gezeigt aus. Wir laufen im lokalen Modus und nicht im Cluster. Beachten Sie, dass wir Hive auffordern, Fehler in der Konsole zu protokollieren, damit wir sehen können, ob etwas schiefgeht. Außerdem verwenden wir Hive und nicht Beeline, die neuere Hive CLI. Hive möchte, dass seine Nutzer Beeline verwenden, aber das ist nicht notwendig. (Wir haben hier darüber geschrieben, wie man Beeline verwendet.)
hive --hiveconf hive.root.logger=INFO,console
Edit /usr/hadoop/hadoop-2.8.1/etc/hadoop/yarn-site.xml.
    yarn.resourcemanager.scheduler.class
org.apache.hadoop.yarn.server.resourcemanager.scheduler.fair.
FairScheduler
Erstelle einige Daten
Jetzt erstelle eine Tabelle und füge einige Daten ein. Du musst ein paar Sekunden warten, nachdem du einen Befehl eingegeben hast, damit er ausgeführt wird, da er Spark und Yarn verwendet. Denk daran, dass er über einen Cluster läuft.
    create table students (student string, age int);
insert into table students values('Walker', 33);
Der Bildschirm sieht so aus:
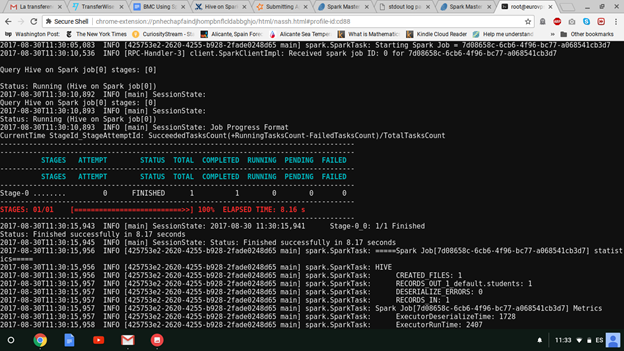
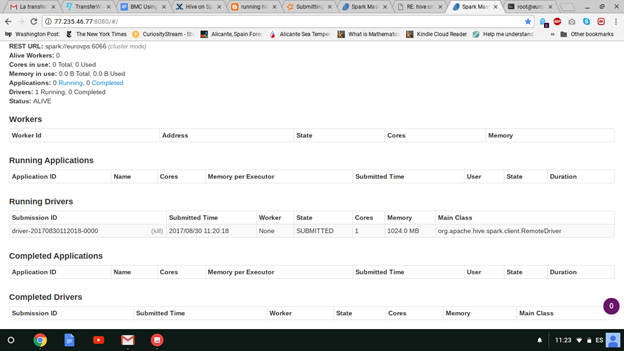
Da es einige Zeit dauert, den Job zu starten, hast du Zeit, die Spark-URL am Port 8080 zu öffnen, um laufende Programme zu sehen. Spark entfernt diese nach Abschluss des Auftrags, es sei denn, du startest den Spark Job History Server.
Jetzt bist du fertig.
Apache Spark Leitfaden
- Apache Sparks maschinelle Lernpipeline: Eine Einführung
- SGD-Beispiel für lineare Regression mit Apache Spark
- Spark Decision Tree Klassifikator
- Mit logistischer Regression, Scala und Spark
- Wie man Jupyter-Notizbücher mit Apache Spark verwendet
- Verwendung von Python und Spark Machine Learning zur Klassifikation
- Wie man Spark UDFs (benutzerdefinierte Funktionen) in Python schreibt
- Python Spark ML K-Means Beispiel
- Wie man maschinelles Lernen auf die Cybersicherheit anwendet
- Apache Spark: Zusammenarbeit mit Streams
- K-bedeutet Clustering mit Apache Spark
- Spark mit Hive verwenden
- Wie man Apache Spark verwendet, um Vorhersagen für die vorbeugende Wartung zu treffen.
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.